前几天看到一条消息:Anthropic 内部很多人都在用一个叫 ELI5 的 skill,工程师 Thariq Shihipar(@trq212,Claude Code 团队)8 月 21 日把它发到了 X 上。我去翻了源码——anthropics/claude-plugins-community 仓库里那个 SKILL.md,321 字节,10 行,没有脚本,没有依赖:
---
name: eli5
description: Explain a topic like I'm a 5 year old. Use when the user types /eli5 or asks for a dead-simple picture explainer of how something works.
---

# eli5

Explain like I'm someone who knows nothing about this topic, using a HTML artifact with big pictures and few words.

Topic: $ARGUMENTS
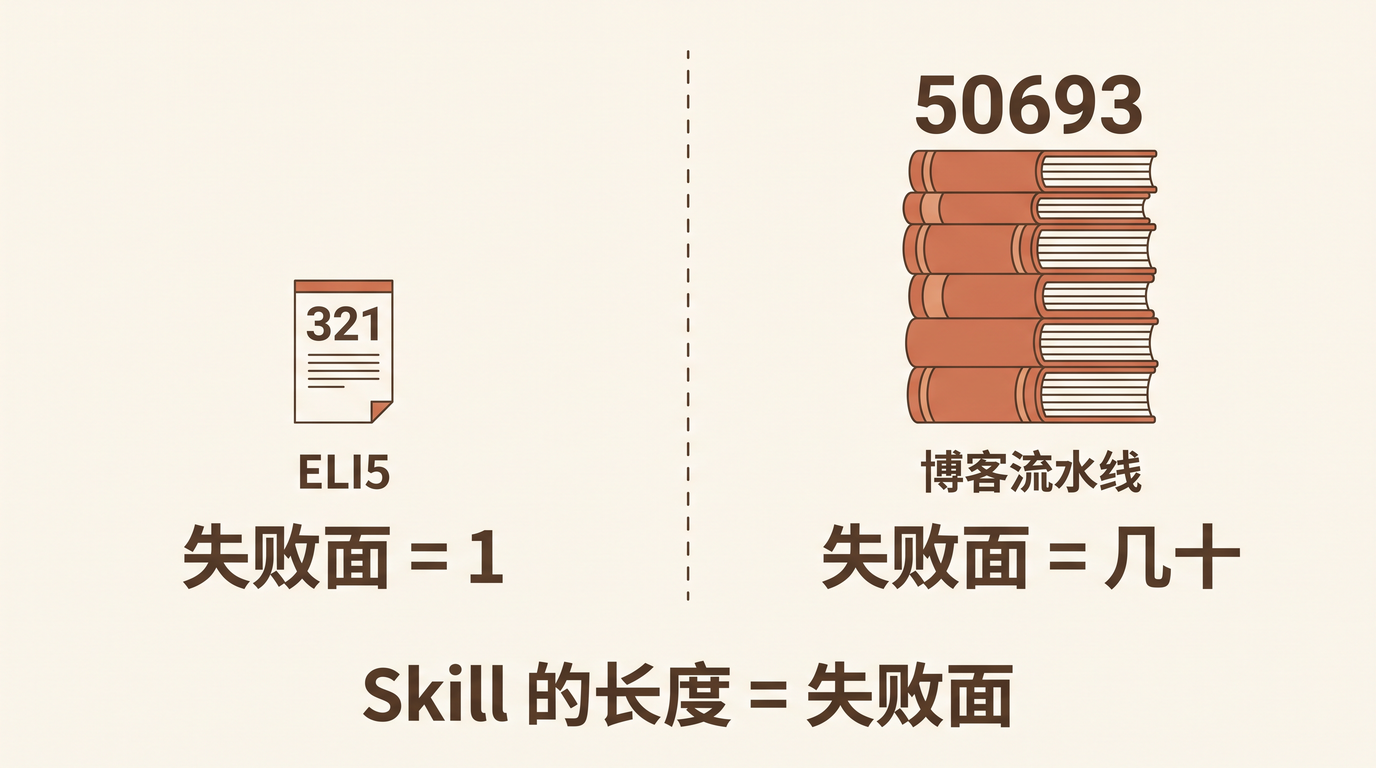
看完我做了件有点自虐的事:wc -c 量了一下我自己天天在用的博客 skill。50693 字节,1078 行。 是 ELI5 的约 158 倍。
那一瞬间我有点心虚。是不是我这份东西,本质上就是一坨啰嗦?「skill 要短、要克制」这两年快成政治正确了,ELI5 又给它添了一把火。可我心虚了三秒就反应过来不对——这两份 skill 防的根本不是同一类失败,拿同一把尺子量,会两头都量错。
这篇想讲清楚一件事:Skill 该多长,由任务的「失败面」决定,不由极简美学决定。
一、ELI5 凭什么 321 字节:它只防一种失败
先承认 ELI5 的厉害,它确实不是「随便写写就短」。
灵魂在正文那句的后半段:HTML artifact、大图、极少文字。你只说「简单解释一下」,模型有的是篇幅铺,八百字小作文分分钟出来;加上「大图少字」这道硬约束,它只能做减法——把最核心的东西拎出来画成图。约束在这里的作用,是 逼模型放弃它默认会做的事。
所以 ELI5 短,不是因为作者克制,是因为 这个任务的失败面只有一条:模型会用「更详细」冒充「更清楚」。一条定义性的约束,正好堵死这一条失败路径,多一个字都是浪费。321 字节不是运气,是这个任务的内在复杂度就这么大。
Thariq 举的三个用法也印证了这点——/eli5 how does this module work、/eli5 why did we make this tradeoff、/eli5 what caused this incident——全是「把一件复杂事压成一张图去对齐」的窄任务。窄,所以一条约束封死。
二、我的博客流水线凭什么 5 万字节:每条规则是一次翻车
再看我那份 1078 行的东西。它长,也不是因为我话痨,是因为 它防的失败有几十条,而且每一条都真实发生过。
随手抽三条它里面的硬规则:
- 评估打分低于 18 分必须停下来重写,不许说「勉强可以」——这条是某次差点把一篇论证有硬伤的文章发出去之后加的;
- 真实日志、命令输出、配置摘录的代码块 绝不能 加「# generated by hugo AI」标记——给真实证据打 AI 生成标记本身就是造假,这条是踩过一次才写进去的;
- AI 配图生成后必须用 vision 逐字核验中文有没有乱码——因为图像模型对密集小字的中文渲染会退化,糊出乱码 CJK,这条也是翻过车才有的。
光是配套的「文章入库」skill,里面带「实证」二字的条目就有 30 条——30 条,意味着至少 30 次真实的踩坑被固化成了规则。这不是修辞,是我刚刚 grep -c 数出来的。
关键区别在这里:ELI5 那条约束是 定义性 的——它定义了「这个任务是什么」;我这几十条是 防御性 的——每一条堵一个「这个任务会怎么坏」。删掉 ELI5 那条,它就不是 ELI5 了;删掉我任意一条防御规则,对应的坑会 重新打开,下一次写文章照样掉进去。
长度在这里不是啰嗦,是 失败面的度量。
三、失败面度量法:定义性约束 vs 防御性约束
把上面的对照收成一张表:
| ELI5 | 博客流水线 skill | |
|---|---|---|
| 字节数 | 321 | 50693(约 158×) |
| 任务宽度 | 窄:压成一张图 | 宽:选题→查重→成稿→配图→评审→发布 |
| 失败模式数 | 1(用详细冒充清楚) | 几十(数字张冠李戴、弯引号转义、配图乱码、相对时间写错、secret 被脱敏…) |
| 约束类型 | 定义性:一条定义任务 | 防御性:每条堵一个真实坑 |
| 合理长度 | 321 字节,正好 | 5 万字节,正好 |
| 砍短的后果 | 不再是 ELI5 | 对应的坑重开 |
        任务的失败面 = 这个任务真实会坏的方式有几条
                          │
          ┌───────────────┴───────────────┐
          ▼                               ▼
      失败面 = 1                     失败面 = 几十
     (ELI5)                       (博客流水线)
          │                               │
   一条定义性约束                   几十条防御性约束
          │                          (每条绑一次实证)
          ▼                               ▼
      321 字节                         5 万字节
          │                               │
          └───────────────┬───────────────┘
                          ▼
            Skill 的合理长度 = 失败面,不长不短
            短于失败面 → 漏防,照样翻车
            长于失败面 → 啰嗦,稀释注意力
判据不是「越短越好」,也不是「越全越好」,是 对齐:skill 的长度应当等于它要防的失败面的大小。短于失败面,是没防住——ELI5 拿去做博客流水线,第一天就会把一篇论证有硬伤的稿子发出去;长于失败面,才是真啰嗦——往 ELI5 里塞十条它用不上的规则,那叫注水。
四、那「越长越被稀释」呢?——和我自己两篇旧文和解
讲到这里必须正面回应一个反方,而且这个反方是 我自己 提出的。
我在 让 AI 自己写 Skill 里写过:「上下文爆炸。Prompt 越长,核心指令越容易被后续对话稀释。」我在 AI 时代的新代码大全 里也写过,Skill 的设计目标「非常克制」,指令太冗长就该精简。两篇旧文加 ELI5,三个声音都在说:短才对。那我这份 5 万字节是不是自相矛盾?
不矛盾,因为 被稀释的是「平铺的长度」,不是「与失败面对齐的长度」。
#172 批判的,是把五十条规则一股脑塞进一段连续 prompt、让它们在同一层注意力里互相抢位置——那种长度确实会稀释,因为模型分不清此刻哪条相关。但我的博客 skill 不是平铺的:它是分节的,而且把大块内容拆进了 references/ 子文件 按需加载——写文章时进上下文的是排版规则和评审标准,做入库时进上下文的是那 30 条实证。任何一个具体任务,真正塞进模型眼前的,永远只是失败面里 与当前这步相关的那一小片,不是全部 5 万字节。
所以三篇旧文其实指向同一条原则,只是被「长度」这个词误导成了对立:该精简的是「与当前任务无关的平铺内容」,该保留的是「失败面要求的防御规则」。 ELI5 短,因为它的失败面只有一条、且每次全量加载也不稀释;我的 skill 长,因为失败面有几十条、但靠结构化和按需加载让每一次的实际上下文依然精简。长度的数字相反,背后的纪律是同一条。
这也和 私有 Eval 是终极护城河 里的判据分层是同一个道理:判据不能合并成一个总分,否则出了问题分不清是哪一层退化;约束也不能压成一句「尽量做好」,否则出了问题不知道是哪条没防住。分层、定位、各自独立——eval 如此,skill 的规则也如此。
五、判据:删掉这条,会不会重开一个真实的坑
落到可操作,写或改 skill 时只问一个问题,对每一条规则问:
删掉它,会不会让一个真实发生过的失败重新发生?
- 会 → 留着,哪怕它让文件变长。它不是装饰,是一道闸门,而且最好绑一个「实证」说明它堵的是哪次坑;
- 不会 → 删掉,哪怕它看起来很专业、很全面。它只是让你心理上更踏实的注水。
极简美学不是判据,「显得专业」不是判据,字节数更不是判据。唯一的判据是 失败面:你的任务真实会以几种方式坏掉,你就需要几条防御性约束;任务窄到只会以一种方式坏,那 321 字节就是对的,多写就是错。
回到开头那点心虚。我现在不心虚了——但我也不会因此就觉得 5 万字节是勋章。它随时该被审视:哪条规则的「实证」已经过时(模型变强后那个坑自己填平了),哪条其实能从两条合并成一条。对齐失败面是一个动态过程,不是一次写完就供起来。 ELI5 提醒我的不是「该把 skill 写短」,是「该定期问每条规则还在防一个真实的坑吗」。
Anthropic 用 321 字节封死了一个窄任务,我用 5 万字节兜住了一个宽任务,两个长度都对——因为它们各自诚实地等于自己要防的失败。你的 skill 现在多长?更重要的是:里面每一条,删掉之后,会不会有个坑重新打开?欢迎留言聊聊。