9 月初,我的数字员工「涌现」在一周里掉了三次链子。
它每天早上八点跑一轮「早读」:读公众号后台、读 GA、digest 小红书、更新 token 消耗、读 aibase——五步,预算一小时。8 月 31 日、9 月 2 日、9 月 5 日,三次吃了同一个兜底。前两次重启了事,第三次我让 opencode 做了一轮十五分钟的验尸:模型网关的机器名,被 /etc/hosts 里一行陈年映射和 DNS 搜索域联手坑了——解析结果里混进一条不通的 IPv6 路由,我常用的工具个个有回退所以毫无察觉,Agent 的运行时没有回退,当场死亡。整个排查过程我写成了 谁停掉了数字员工的早读。
事后回想,我当时的感受不是恼火,更接近于交学费的踏实。这个「早读」场景,技术上毫无炫技之处——定时任务、抓取、摘要、发消息,任何一个传统后端工程师一天就能搭完。但正是这个普通的场景,在过去几个月里每天给我生产真实的执行、真实的失败、真实的修复。我对 Agent 工程的大部分真实认知,不是从论文和 demo 里来的,是从这条 loop 里长出来的。
这让我越来越确信一个判断:Agent 应用工程师的核心竞争力,不是会不会调 Prompt、接 MCP、做 RAG,而是能不能建立一个真实的、持续运行的 Agent Loop。 而在选择做什么项目时,我会把一个指标放在非常靠前的位置:这个场景每天能给我多少次真实的执行反馈。
一、Prompt、MCP、RAG 为什么不是竞争力
先说清楚为什么这三样不算。
它们是 知识,而知识的命运是被课程化、被文档化、被下一代模型直接吸收。我在 模型正在吞噬 Agent 框架 里写过这条规律:模型每强一代,框架的能力层就被吃掉一层。Prompt 技巧、MCP 接法、RAG 管线,全在被吃掉的清单上——它们的半衰期以月计。你花三个月练熟的手艺,下一次模型发布就可能变成内置默认行为。商品化的知识不构成竞争力,不可携带的调教才构成。
而跑 loop 攒下的东西恰恰不可携带:哪种失败在上线第三天出现、哪类用户输入会在周五下午炸、哪个兜底话术救过场、哪条规则是踩着哪次事故写进 skill 的——这些长在真实轨迹里,没法被课程化,也没法被竞品复制,因为它跑在你的生产数据上。数字员工的自我进化 那篇的结论在这里同样成立:RSI 跑在生产数据上,不跑在算法上。工程师的成长也一样。
这也是 Agent 工程师和传统应用工程师最大的区别所在。传统应用是确定性的:代码写完,它每次做同样的事;bug 可复现,修一次好一次,发布即完成。Agent 应用是随机性的:同样的输入,今天的输出和上周不同;「修复」不是一锤定音,是统计意义上的改善;模型会升级、用户会漂移、环境会变,发布才是开始。一个习惯了「发布即完成」的工程师,面对一个「发布才开始」的系统,会本能地想把它修到「不再出问题」然后收工——但 Agent 系统永远不会停止出问题,它只是把问题从已知挪到未知。接受这一点,才谈得上建 loop。
二、10~100 次/天:一个被低估的甜区
把上面的逻辑压缩成一个可操作的选型指标:
这个场景有没有可能让我每天获得 10~100 次真实的 Agent 执行反馈?
为什么是这个带宽?两端各有陷阱,这一节是我自己的推断,但每一端都有机制支撑。
低于 10 次/天,归因全是噪音。 反馈稀薄时,迭代周期被迫拉长到周级甚至月级:你改了一处 prompt,要等一周才攒够几个样本来判断有没有效——而这一周里模型变了、用户变了、输入分布也变了,改善和退化搅在一起,你分不清是修复生效还是运气。学习需要「动作 → 结果」的紧密配对,间隔一拉长,配对就断了。这种场景里干一年,约等于在第一周的水平上重复了三百次。
高于 100 次/天,逐条消化变得不可能。 反馈太密时,你被迫从「案例学习」切换到「统计学习」——建 dashboard、做分层 evals、看分布而不是看个案。那是另一门手艺(私有 Eval 是终极护城河 讲的就是它),而且统计学习的前提是先有足够多的案例学习打底——没见过一百个具体失败的人,看不出分布图里哪个尾巴不对劲。
所以 10~100 是 人脑还能逐条消化每个失败、又能快到日级迭代 的甜区。它对应的场景画像也很具体:一个部门内部的 HR 问答、一个销售跟进助手、一个客服机器人、一个运营日报——用户量不大不小,每天几十次真实调用,每次失败都有具体的人、具体的输入、具体的后果可以复盘。
还有一个机制值得单独点出:持续运行的 loop 是失败面工厂。 321 字节和 5 万字节 那篇讲过,防御性约束每条都绑一次真实翻车。一个每天真实运行的 Agent,就是在每天生产新的失败样本——你的 skill、你的 eval、你对系统的认知,全部靠这些样本喂养。选场景选反馈密度,本质上是在选失败面的生成速率。
顺带说一句,这个指标和 AI Agent 使用的复利效应 里 Mitchell HashiCorp 的做法是同一件事的两个方向:他靠「把已经手动完成的事再让 Agent 做一遍」来制造反馈、建立对能力边界的真实认知——那是个人采纳期的手工办法;选一个每天自动给你 10~100 次反馈的场景,是把这个办法系统化、常态化。
三、必须补的一刀:反馈 ≠ 学习
到这里都还顺,但有一个地方不补上,整个论证会塌:「每天真实运行、每天失败」是场景属性,「每天被修正」是工程师动作——后者不会自动发生。
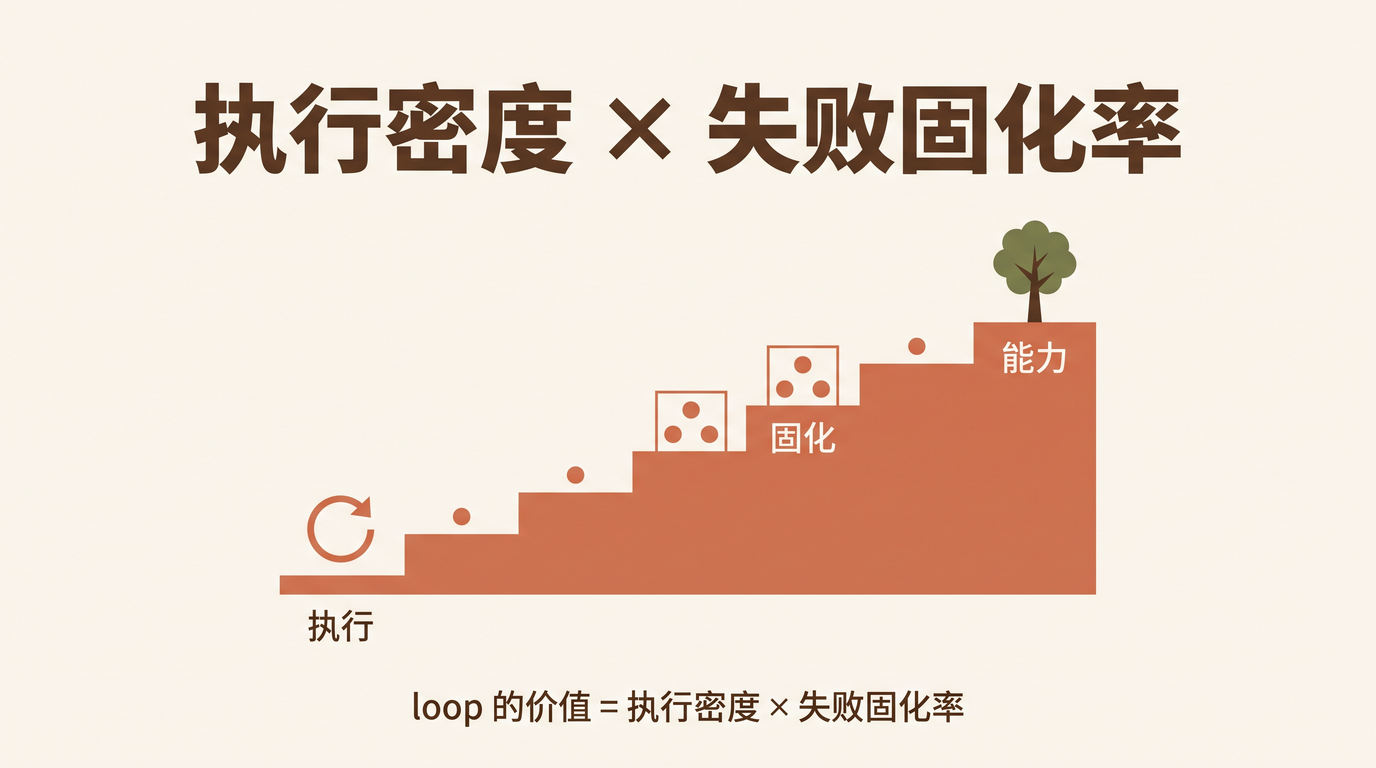
loop 的价值不是执行密度单独决定的——执行密度就是标题里那个「每天的真实反馈次数」,场景给的上限;真正决定价值的是它和失败固化率的乘积:
loop 的价值 = 执行密度 × 失败固化率

执行密度:每天多少次真实执行(场景给的)
失败固化率:每次失败变成规则/eval/记忆的比例(工程师做的)

密度高 × 固化率低 → 噪音场(比没有 loop 更糟)
密度低 × 固化率高 → 盆景(精致但长不大)
密度高 × 固化率高 → 训练场
失败固化率的意思是:每次失败,要么变成一条防御性规则写进 skill,要么变成一条 eval 用例进测试集,要么变成一次记忆更新——修好的坑不许重开,棘轮只许向前。#403 里有个现成案例:某次真机对话同时违反了 3 条 persona 规则,而当时 422 条离线单测全绿、检索 eval 100%、8 次工具调用零报错——整套验收一条都没红。那次失败如果没有被固化成 persona 层的 13 条专项用例,它就会以另一个面目下周再来一次,而你甚至认不出它是同一个坑。
没有第二个 loop(失败 → 固化的 loop),第一个 loop(执行 → 反馈的 loop)会静默腐烂,而且腐烂的形态比「没有 loop」更糟:用户侧长出习得性无助——「它又错了,算了」;工程师侧长出警报疲劳——「哦,又失败了」。九十天后你得到的不是训练有素的工程师,是一个所有人对失败都脱敏的系统。脱敏是学习的反面。
所以「会不会建 Agent Loop」的完整定义是两层的:建得起第一个 loop,让 Agent 真实运行;更要建得起第二个 loop,让失败不可逆地变成资产。 市面上大多数项目只做到第一层,大多数简历也只写得出第一层。
四、市场在系统性地错误定价
这个指标还藏着一个职业市场的张力:招聘市场按 demo 定价,能力按 loop 生长。
跑出一个酷炫 demo 的人,简历好写、面试好讲、offer 好拿——「多 Agent 协作系统」「自主任务规划」,每个词都在发光。把一个普通的 HR Agent 真实跑了 90 天、修掉两百次失败的人,简历上只能写「维护了一个 HR 机器人」。但后者的能力是前者拿不到的,原因很朴素:demo 只跑过晴天,loop 跑过了所有的雨天。 面试官看不见的部分——第三次掉链子之后的验尸、422 条全绿之下的漏网之鱼、用户说「算了」之前你抢在前面的修复——恰恰是能力本体。
所以「普通场景」这件事要说得更狠一点:不是「普通场景也可以当训练场」,是 普通场景更好。技术越酷、离真实运行越远的场景,越容易停在 demo 态——没有真实用户每天使用,就没有每天的真实失败,loop 转不起来;反过来,HR、销售、客服、运营这些「不酷」的场景,每天被真实用户逼着面对你想不到的失败,而这正是训练场的定义。技术酷不酷是 demo 的属性,反馈密不密才是成长的属性。
这不是说不要做酷的东西。是说选成长项目时,把「每天 10~100 次真实反馈」放在「技术栈新不新」前面——前者喂养能力的复利,后者只喂养简历的亮度。
五、产品护城河和工程师护城河,是同一个东西
最后把镜头拉远。这个指标有个漂亮的对称性。
任务好搬,关系难搬 那篇讲过,对用户来说,周期任务是留存锚——一个每天真实运行的 Agent,让用户把记忆、例行事务和授权存放在产品里,迁移变贵,留存变牢。对工程师来说,同一个持续运行的 loop 是成长锚——每天的真实失败被固化成不可携带的调教,能力变厚,市场变宽。
产品护城河和工程师护城河是同一个东西的两面,都在六个字上:真实、持续、不可携带。demo 是便携的,谁都能复现一个 demo;loop 是不可携带的,九十天的失败固化史没法打包带走。选择建 loop 的人,同时在给产品和给自己挖同一条河。
文章开头引用的那几句判断,放在这里作为收尾:
Agent 应用工程师的核心竞争力,不是会不会调 Prompt、接 MCP、做 RAG,而是能不能建立一个真实的、持续运行的 Agent Loop。
所以选择 Agent 场景时,我会把一个指标放在非常靠前的位置:这个场景有没有可能让我每天获得 10~100 次真实的 Agent 执行反馈?如果没有,哪怕技术很酷,也未必是一个好的成长项目。
反过来,一个看起来很普通的 HR、销售、客服、运营 Agent,只要每天真实运行、每天失败、每天被修正,反而可能是非常好的 Agent 工程师训练场。
补上我这一刀之后,完整版是:每天真实运行、每天失败、每天的失败都被固化成不许重开的规则——这才是训练场。你的 Agent 现在每天给你多少次真实反馈?失败固化率又是多少?欢迎留言聊聊。