9 月的一个深夜,我在翻 blog2 仓库里的一个文件,翻到有点不舒服。
skills/hugo-blog/SKILL.md,版本号 3.4.0,1078 行。第一次写它的时候只有几十行。中间模型换了好几代,这个文件一行没删,只加。加进去的每一行背后都是一次真实翻车——「Wan2.7 的 prompt 里不要写中文」「Gemini 的 landscape 必须是 1280x896,小了直接返回 400」「加粗标记内侧不能有空格」。
不舒服的点在这里:让我踩下这些坑的那几个模型,现在一个都不用了。但这 1078 行,一行都没作废。
我盯着它看了很久,意识到自己看的不是一个文件,是一条 loop 的沉淀物。
然后一个念头冒出来:模型训练是一个 loop,Agent 是一个 loop,人生也是一个 loop。 三个 loop 的结构完全一样——行动、观测、评估、更新。区别只有三条:反馈延迟多久、单次迭代多贵、状态能不能跨轮留下。
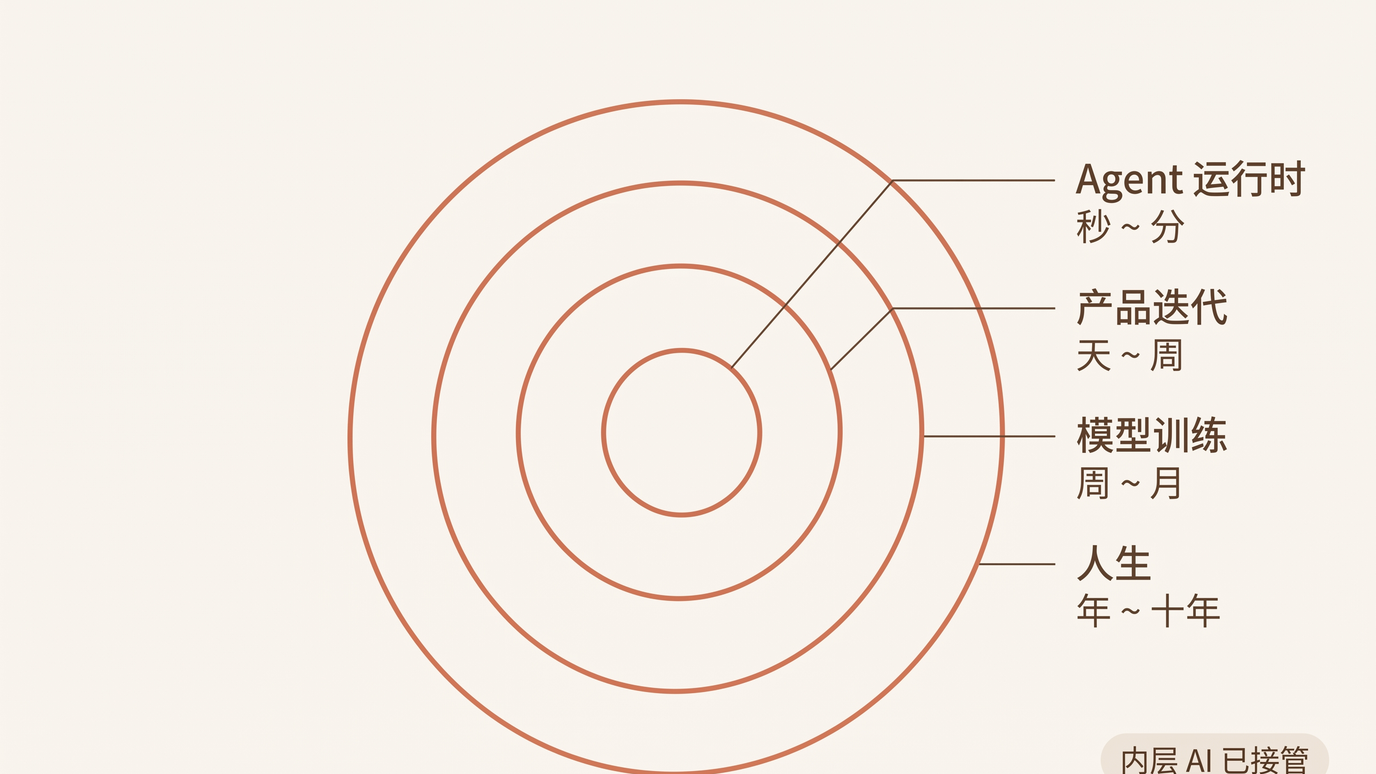
再补上产品迭代这一层,四个尺度摆在一张表上,问题就自己浮出来了:
| Loop | 周期 | 反馈信号 | 谁在优化它 | 单次迭代成本 |
|---|---|---|---|---|
| 模型训练 | 周~月 | loss、eval 分数 | 模型团队 | 极高 |
| Agent 运行时 | 秒~分 | 工具返回、用户反应 | 你的 harness | 低,还在降 |
| 产品迭代 | 天~周 | 留存、收入 | 你的团队 | 中 |
| 人生 | 年~十年 | 复利、关系、健康 | 只有你 | 不可逆 |
注意最右两列。AI 干的事情,是把第二行的迭代成本压到接近零。 而「跑得快」恰恰是过去二十年开发者投入最多的方向——写代码更快、部署更快、试错更快。AI 没有开辟这条路,它把这条路走到了尽头。
一个东西变免费,它就不再是竞争力,它的互补品才升值。这条规律我在 别再用技能衡量自己 里用它解释过技能租赁,这次它作用在 loop 本身:快 loop 免费了,稀缺的变成了慢 loop 的方向感,和跨轮次留下来的状态。
下面六条信念,全部从这句话推出来。每条前面有一个真实故事。
信念一:模型会被替换,Loop 不会
2026 年 8 月 8 日下午,我的数字员工失联了 16 分钟。
监控这边一切正常:进程存活检查通过,HTTP /session 探测返回 200,健康检查每 5 分钟跑一次,连着三次报「健康」。唯一的异常是群里任何人 @ 它,它都不回。最早发出告警的,是一个人在钉钉里觉得不对劲——比我们任何一条监控都快。
后来复盘出真相:那套监控体系监控的根本不是「数字员工在工作」,而是「装着数字员工的那个容器还在」。我们于是加了第 7 项检查 check_brain——不探接口,直接发一次真实模型调用。接口探测证明的是「有人在门口应声」,模型调用证明的是「里面真有人在干活」。全过程写在 健康检查全绿,数字员工失联了 16 分钟。
信念:部件全绿 ≠ loop 通。你的资产是那条端到端的回路,不是回路里任何一个可替换的零件。
模型是租来的零件。今天租 Claude,下个月租 Gemini,没人拦着你换。但你搭的那条「采集 → 判断 → 执行 → 回收反馈」的回路,换模型的时候原封不动地留下来了——那才是你造的。
人生版更难听一点:体检指标全绿,不等于你正在过的日子是对的。你监控的指标,必须是端到端的。
信念二:没有 loss curve 的努力,是在瞎跑
那个年轻人又来找我了。我写过他两次。
第一次在 从用好 AI 到管理 AI:他每天都在用 AI,prompt 也调得不错,但总觉得还是在「自己干活」。第二次在 别再用技能衡量自己:他照我说的做了,然后回来告诉我,又订了三个工具,整理了 30 条常用 prompt,刷完两门 AI 课程——「我的工具更多了,效率也确实高了。为什么反而更焦虑?」
我当时给他的答案是「技能可租赁,闭环不可租赁」。这答案没错,但后来我发现我没答到点上。
他真正缺的不是答案,是曲线。 他没法回答一个最基础的问题:我比三个月前的自己好在哪?不是他没进步——是他在跑一个没有 loss curve 的训练。
训练模型的人都知道,曲线比单点重要得多。单点高分可能是运气、可能是过拟合、可能是评测集泄题;只有曲线的形状能告诉你「在收敛」还是「在震荡」。可大多数人的职业努力,记的全是单点:今天学了一个框架,明天读完一本书,后天考了一个证。没有一条曲线把它们串起来。
信念:把隐式反馈显式化。 Agent 里没有梯度,只有信号——用户采纳了吗、重试了吗、打断了吗、下一轮还追问吗。把这些落成可回放的 eval 集,你就有了曲线。人生里同理:谁主动来找你、你拒掉了多少、同一类错误重复了几次。这三个数能画出曲线。三十条 prompt 画不出。
信念三:梯度是借来的,状态才是自己的
YC Startup School 的舞台上,主持人 Diana Hu 问 Jeff Dean 一个问题。
Dean 刚讲完他和 Sanjay 写的一个性能优化 Skill——教模型自己跑完「测基准 → 改代码 → 验证提升 → 再迭代」这一整圈。Diana 听完说:「谁拿到这个 Skill,就能像 Jeff Dean 一样做性能优化了。这东西肯定价值无限。有人能拿到它吗?」
Jeff Dean 的回答是:「哦,我们其实把它公开了。」
全世界最想要的东西,他随手公开了。因为他清楚:Skill 会扩散,跑 Skill 的那条 loop 不会——Google 内部那个被上百万进程使用的微基准库、那套专有工具链、几十年攒下的判断力,一样都拿不走。我在那篇 Skill 是组织知识的新载体 里详细记了这一幕。
回头看我开头那个让我不舒服的文件,它就是这件事的民间版本:1078 行里没有一行是「模型教我的」,全是「模型坑过我之后我记下的」。模型全换掉了,这本账一个字没丢——让我不舒服的那个地方,恰恰是它值钱的地方。
信念:权重是租的,跨轮累积的状态才是自己的。 你的 skill、你的 eval 集、你的 context 工程、你踩坑记下来的那些约束——它们能穿越模型代际继承下去。你今天调得再熟的某个模型脾气,下一次发版就清零。
Mitchell Hashimoto 那六个阶段说的也是这件事,我在 AI Agent 使用的复利效应 里写过:他把已经手动干完的事再让 Agent 干一遍,看起来是纯冗余。但那次冗余产出的是一份可复用的状态。复利从来不长在动作上,长在动作留下的东西上。
信念四:发散是默认形态,不是意外
我写过两个 skill,一个 321 字节,一个 5 万字节。
321 字节那个只干一件事,没有防御性约束,因为它翻不了车。5 万字节那个每一条啰嗦的约束背后,都绑着一次真实翻车——「这个参数不能省」「这一步必须等上一步落盘」「遇到这种输入立刻停手别猜」。长度不是文风问题,是失败面的面积问题。详见 321 字节和 5 万字节。
另一面是死循环。一个没有步数上限、没有成本熔断的 Agent loop,不是「可能」烧穿预算,是「迟早」烧穿。所以护栏不是可选装饰:步数上限、超时、预算熔断、置信度阈值、人在环。
训练里这些东西有名字——gradient clipping、early stopping、weight decay。它们的存在本身就说明了一件事:发散不是训练的意外,是训练的默认结局。 不主动约束的优化过程,会一路跑到爆。
信念:先装护栏,再加速。自动化程度越高,护栏的优先级越高,不是越低。
人生版的发散长得不一样,但机制一模一样:反刍、内耗、在同一个错误判断上反复加注。它不会自己停下来,因为每一轮都在用上一轮的输出当输入——错误信念被自己强化,越跑越偏,而且当事人完全感觉不到,因为局部每一步都是「合理」的。
这就是为什么止损必须是一个 事先写好的规则,不能是事到临头的判断。事到临头的你,正是那个已经跑偏的 loop 的产物。
信念五:外层 loop 决定内层 loop 的上限
和一个朋友讨论组织 AI 化时,他有一句话点破了本质:
「训练过模型的人都懂:损失函数错了,训练步数越多,跑得越偏。」
组织也一样。我在 组织的损失函数 里展开过:「希望营收翻倍」「希望成为行业第一」不是目标,是许愿——许愿型目标不可分解,推不出任何一个人周一早上的动作。于是团队越勤奋,离目标越远,因为每个人都在认真地优化一个错的东西。
把这条规律放到上面那张表上,就变成了一句更狠的话:内层 loop 的效率,永远被外层 loop 的方向封顶。
你在 Agent 运行时那一层把延迟从 3 秒压到 1 秒,如果产品迭代那一层在解一个没人要的问题,你省下的是两秒钟的无效等待。你在产品层做出了漂亮的增长,如果人生那一层选错了赛道,你赢的是一场自己不参加颁奖礼的比赛。
信念:选对要解的问题,权重远大于把问题解决得漂亮。
这条最难执行,因为内层 loop 的反馈快、成就感强、可量化;外层 loop 的反馈慢、令人不安、还常常没有标准答案。人天然会躲进内层。这也是为什么「忙力所能及的事」会带来安全感——忙碌是一种 方向问题的止痛药:它让你免于回答那个更难的问题,而且当天就有产出可以交差。
信念六:人生这个 loop,没有 replay buffer
DeepSeek Harness 的源码里有个细节我印象很深:注册即副作用,卸载即回滚。 插件每注册一个能力,同时登记一个对应的清理动作;插件卸载或重载时,这些注册被一起撤销。官方原话是 registrations are effects that unwind when their plugin unloads。我在 一切皆插件 里给它的评语是:可替换是口号,可回滚才是能力。
Agent 世界的失败是便宜的。跑飞了重启 session,写错了 git revert,判断失误下一轮就能改。代价是 token。
人生不行。健康、关系、信任,这三样没有 revert。 它们是单次写入、不可回滚的资源,而它们的反馈延迟长得离谱——坏掉的信号往往在几年后才到达,等你看见曲线的时候,那一轮迭代早就结束了。
所以这里有一个反直觉的结论:人生 loop 的设计原则,和 Agent loop 是相反的。
- Agent loop 追求快速试错——因为失败便宜,样本越多收敛越快。
- 人生 loop 追求可逆性优先——因为失败昂贵,一次不可逆的损失能抹掉几十次成功迭代的收益。
这条信念可以直接写成一个事前检查,比任何励志语录都好用:
每次投入前,先给这件事分类,再决定投入节奏:

可逆     失败成本 = 时间 / token / 一点面子
         → 高频试错,越快越好,不要开会对齐
         例:一次尝试、一个小项目、一次公开的失败观点、一次重构

不可逆   失败成本 = 无法回滚
         → 留余量,宁可慢,不许穿仓
         例:健康、核心关系、信誉、本金

典型错配(大多数人正好做反):
         可逆的事犹豫三个月
         不可逆的事三分钟就梭了
分类必须在投入之前做。投入之后再分类,你已经在为「继续投」找理由了——那是信念四说的自我强化。
两个最强反方
反方一:「六个信念,本质是幸存者偏差。决定结果的是时代、赛道、资源和运气。你在对的时候进了对的地方,比你信什么重要一百倍。给信念列清单,只是事后给自己讲故事。」
这个反方有力,我承认它的一半:信念确实不改变外部概率分布。 你信什么,不会让风口提前到来。
但它改变的是同一分布下的 采样策略。同样一个运气窗口砸过来,相信「状态必须跨轮累积」的人会把它变成资产,相信「技能即资产」的人会把它变成一次性收入;相信「发散是默认形态」的人会在顺境里装护栏,不信的人会在顺境里加杠杆。窗口是运气给的,窗口的转化率是信念给的。
而且本文这六条不是情绪口号,每一条都对应一个可被行为检验的约束——它规定了我会 拒绝 什么:拒绝只看部件指标的监控、拒绝没有曲线的努力、拒绝不可继承的调教、拒绝没有护栏的自动化、拒绝躲进内层的忙碌、拒绝在不可逆资源上高频试错。能被行为证伪的东西,就不是事后故事。
反方二(更狠):「方向不是先验选出来的,是跑内层 loop 跑出来的。你把内层贬成『已经不是你的竞争力』,等于砍掉了唯一的方向传感器——不亲手跑,你凭什么判断外层方向对不对?」
这一刀切中要害,信念五如果单独读,确实会被误用成「别干活了,去思考方向」——那是最坏的读法,也是大多数「战略型」失败的起点。
正确的关系是 分工,不是取代。内层 loop 有两个身份:一个是产能(把活干完),一个是探针(告诉你外层假设错了)。AI 接管的是第一个身份,第二个身份接管不了——因为它要求你真的下场、真的被打脸。
所以信念五应该被读成:内层照常跑,但跑的时候要多问一句「这一轮的反馈,是在验证我的产能,还是在验证我的方向」。 大多数人的内层 loop 只回收前一种信号,于是跑了一年,产能涨了,方向从未被检验过一次。
这也是 选 Agent 项目,我第一个看的是反馈密度 那篇的补集:那篇讲怎么让内层 loop 转得密,这篇讲怎么让内层的信号往外层传。少了任何一边,另一边都白搭。
收尾
三个 loop 是同构的。这件事真正的含义不是「人生像训练模型」这种漂亮比喻,而是一句很实用的分工:
内层的产能正在被 AI 接管,而且会越来越便宜。你剩下能做的,是把内层跑出来的信号,往外层传。
外层只有三件事:方向对不对(信念五)、状态留不留得住(信念二、三)、有没有跑爆(信念四、六)。至于内层跑得多快——那已经不再是你的稀缺项了,但它仍然是你唯一的方向传感器。
所以别做单步最优的执行者,做那个能持续收敛的系统的设计者。
你的四条曲线里,哪一条已经很久没更新了?欢迎留言聊聊。