今天在 GTLC 现场听完白鲸开源 CEO 郭炜的演讲,回来就把那张 slide 写成了《当智能变得免费,什么东西在涨价》。顺着这个题目继续想,想到一个更落地的对比:
企业花钱买 AI,是为结果买单;个人花钱买 AI,是提效给自己赚钱。
两句话听起来是同一件事的两面。但放到账本上看,是两种完全不同的账——而且大多数人把自己的账记错了。
个人的账:两类正在发生的高价值任务
先看个人这边。今天个人掏钱买 AI,高价值的用法其实就两类。
第一类:工程师写代码。 用 Qoder 这类 Coding Agent,token 账单自己付,每个月几十到几百块。买的是效率,但沉淀下来的不止效率——代码进了自己的仓库,踩过的坑变成了 know-how,交付记录变成了个人声誉。token 烧完,东西留下了。
第二类,也是增量更大的一类:非工程师搭应用和工作流。 一个自媒体人用 AI 搭一条从选题、写稿、排版到发布的流水线;一个运营把自己的周报流程做成自动化;一个小店主用 AI 搭了个订单处理的小应用。他们不会写代码,但他们在做和工程师同构的事——用 token 换一条属于自己的流水线。流水线每天在跑,内容库在涨,粉丝在攒,这些都是资产。
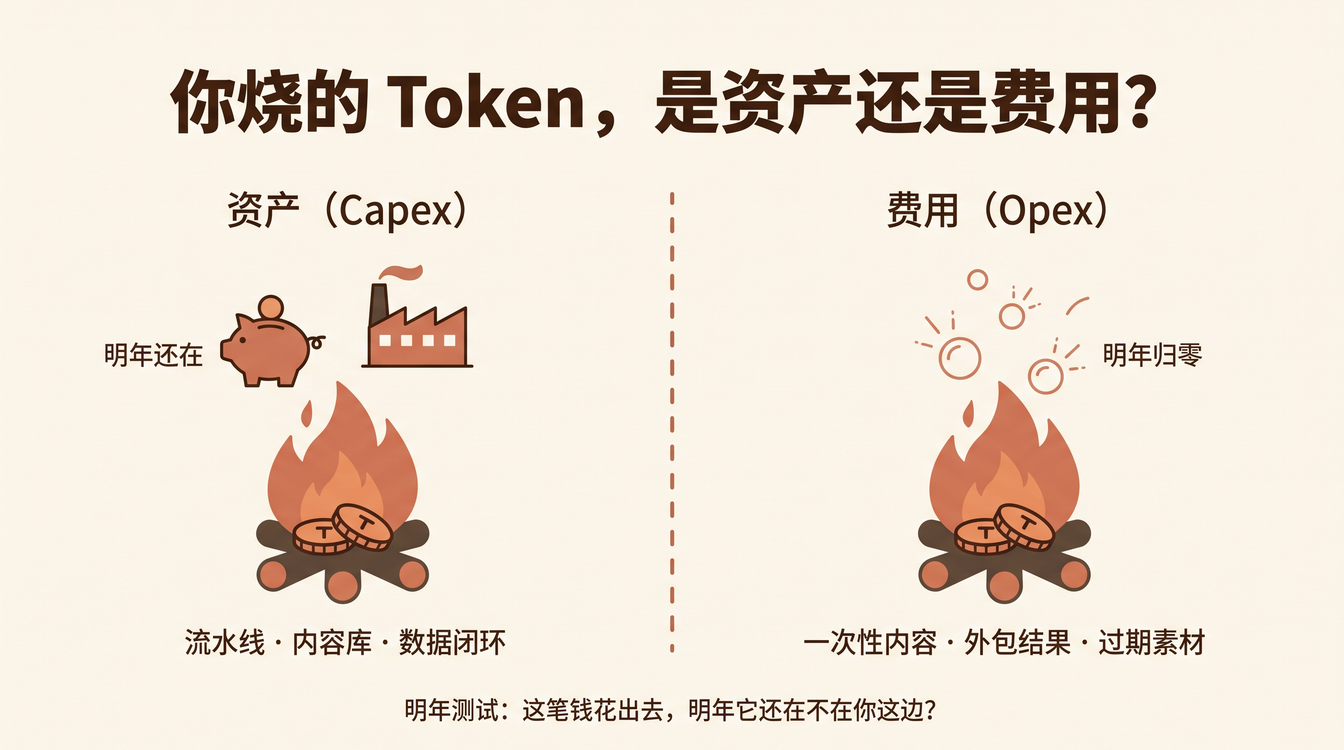
这两类任务的共同点:token 是自己掏钱买的,烧出来的资产落在自己账上。 用会计的话说,这是资本性支出(capex)——花一次,受益跨年。
企业的账:为结果买单,默认是费用
再看企业这边。今天企业买 AI 主要两种形态:一种是 买结果——外包给服务商,按交付付费;另一种是 自建管道——开发、部署、云端托管一支 7×24 运行的 Agent 队伍,token 消耗量远超个人,一个中型企业的月度消耗可能是个人的几千倍。
问题出在第一种。为结果买单,结果交付完就蒸发了:一批 AI 生成的营销素材投放完就过期,一次外包的客服任务结束就结束,一份咨询报告看完就进抽屉。钱花了,账上什么都没留下——这是标准的费用(opex),当期损益,跨年归零。
token 成本怎么计量、怎么归因到团队和数字员工,我在《未来的员工,有两份成本单》里写过;按工作付费的定价怎么签「干完了」,在《数字员工按工作收费,谁来签「干完了」》里写过。这两篇解决的是「怎么算账」,今天要补的是另一半:算清楚之后,这笔账该记成什么性质。
最危险的不是记成费用——费用没什么可耻的,该外包的就该外包。最危险的是 把费用误记成资产:以为「我们在 AI 上投了这么多钱,数字化转型了,资产厚了」,实际上账上沉淀为零。更糟的一种情况是,买结果的同时把过程数据也送给了供应商——你在上一篇文章里读过的那个问题又回来了:数据进了谁的资产负债表?你付钱,供应商攒资产,这是纯负的交易。
明年测试:一个问题分清两种账
capex 和 opex 的判别,不需要会计知识,一个问题就够:
这笔钱花出去,明年它还在不在你这边?
在,是资产;不在,是费用。套到常见场景上:
| 支出 | 明年还在吗 | 性质 | 留下的资产(对应郭炜环图) |
|---|---|---|---|
| 买一批 AI 生成内容投放 | 投放完就过期 | opex | 无 |
| 自媒体搭选题→发布流水线 | 流水线每天在跑 | capex | 分发网络、内容库 |
| 工程师用 Coding Agent | 代码和 know-how 留下 | capex | Know-how |
| 企业外包客服结果 | 服务结束即蒸发 | opex | 无(过程数据还可能归对方) |
| 企业云端托管 Agent 跑业务 | 流程数据持续沉淀 | capex | Proprietary Data |
| 买一个会被下版模型替代的自研工具 | 明年模型自带此能力 | opex | 无 |
注意表里最微妙的一对:同样是外包,「买结果」和「买结果并要求过程数据回流」是两种账。 前者纯 opex;后者多付一点成本,把交易过程变成了自己的数据闭环——opex 里长出了 capex。这就是为什么合同里那几条数据条款,比砍价重要。
不对称:个人有上限,企业没有
还有一层容易被忽略的不对称。
个人的 token 消耗有天然上限——一个人的产出撑死就那么多,就算全天候用 AI,月账单也就几百上千块。企业没有这个上限:云端托管的 Agent 是 7×24 跑的,数量可以横向扩,单价下跌还会诱发用量超比例增长(#393 里写过的杰文斯陷阱,不展开)。
这意味着两件事。
对个人:账小,所以 每一笔都该尽量记成 capex——同样烧一百块 token,烧成一条可复用的流水线,和烧成一篇一次性文章,明年的处境完全不同。
对企业:账大且无上限,所以竞争维度会变。会用 AI 的组织已经到处都是,明年拉开差距的不是谁的 token 烧得多——烧得多太容易了——而是 谁的 token→资产转化率高。烧同样的 token,一家沉淀出数据闭环、流程资产、评测集(就是《软件工厂 3.0》里说的模具),另一家只沉淀了一堆过期素材。前者越烧越厚,后者越烧越薄。
最强反方
反方一:企业买结果就是理性的,不是每家公司都该攒 AI 资产。
对一半。买结果没问题——可重复采购、市场充分竞争的结果,外包永远比自建便宜,记成 opex 天经地义。要守住的只有两条纪律:一,别自我安慰,opex 就是 opex,不要拿「数字化投入」的名义给费用化妆;二,合同里把过程数据的归属写清楚——你可以买结果,但不能顺便免费给供应商喂数据闭环。
反方二:个人那边也没那么好看——大多数人烧的是公司的 token,干的是公司的活,资产全落在公司账上。
这一条全对,而且是这篇文章真正想说的第二个提醒:用公司的 AI 提效,是在帮公司记 capex,你自己的账上还是零。 公司发的 Coding Agent、公司买的 AI 平台,烧出来的代码资产、数据资产、流程资产,离职时一样都带不走。这就是为什么上一篇《学 AI 要学让你赚钱的 AI》的核心建议是「用自己的 token 搭自己的管道」——不是公司小气,是两本账本来就该分开记。白天用公司的 AI 给公司攒资产,那是职业道德;晚上用自己的 AI 给自己攒资产,那是职业规划。两个都做,才叫对冲。
怎么办
企业三个动作:
- 给每笔 AI 支出打标签:过一遍「明年测试」,标出 capex 和 opex。大多数企业第一次做完这个盘点会发现,自以为的 AI 资产投入,八成是费用。
- 在采购和 Agent 设计里内置 opex→capex 的转化:外包合同写数据回流条款;自建 Agent 把过程数据、评测集、流程模板当成一等公民存下来,而不是只存交付结果。
- 报表看转化率,不看消耗量:token 消耗量是电表读数,不是业绩。要问的是这个季度账上多了哪几项资产——数据闭环厚了多少,模具多了几套,评测集覆盖了多少场景。
个人两个动作:
- 分清两本账:公司的 AI 是公司的账;自己掏 token 搭的管道、攒的内容库、做的产品,才是自己的 capex。每个月留一笔自己的 token 预算,像交社保一样交给自己。
- 把 token 优先烧在管道上,而不是产出上:一篇 AI 写的文章是费用,一条能持续产文章的流水线是资产。先建管道,再谈产出。
写在最后
郭炜那张环图问的是「AI 无法低成本复制什么」,今天这篇其实是它的账本版:无法复制的东西,才配记进资产栏;其余的,都是费用。
年底翻账单的时候,这个问题值得每个用 AI 的人和公司问一遍自己:今年烧掉的 token,有多少明年还在你这边?
你的 AI 支出里,capex 和 opex 各占多少?欢迎留言聊聊。