9 月中旬,一家叫 TypeSafe AI 的公司出隐身。创始人 Diogo Almeida 是 RLHF/InstructGPT 的共同发明人,GPT-4 致谢名单里有他的名字——可以说,是他教会了大模型「说人话」。而他隐身两年后发布的产品,却出人意料:一个不会说一句话的模型。
这个模型叫 Jev,定位「决策模型」:输入任意状态和预定义的问题,输出只有三种——选择题、打分、是非题,每个都附带校准过的置信度。口号只有三个词:Decisions, not strings(要决策,不要字符串)。输入 $0.042/百万 token,输出免费,端到端 70–500 毫秒。
市场反应激烈:发布帖 420 万浏览,5 天撤掉 waitlist 全面开放,browser-use 团队次日开源集成(仓库已 12.5k 星),Vercel、OpenRouter、LangChain 一周内全部上架,连蹭热度的 memecoin 都出现了。
一个「不会说话」的模型,凭什么这么火?
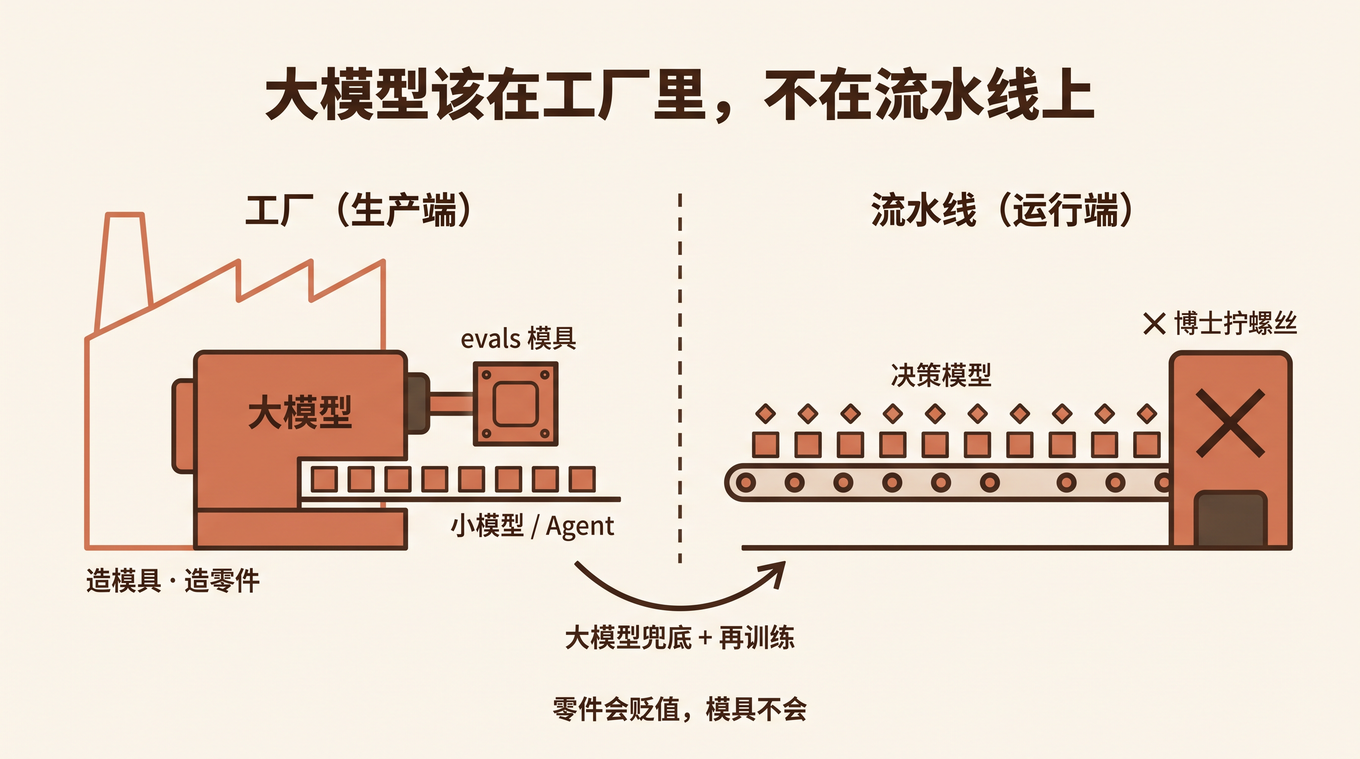
因为它赌对了一件事:大模型的岗位不在每一次调用里,而在调用背后——大模型该在工厂里,不在流水线上。
一、90% 的调用,不需要大模型
拆开看一个 Agent 处理复杂任务的过程:几百次模型调用里,约 90% 是路由、分类、校验、状态判断——「这条消息该转给谁」「这个任务完成了吗」「这段回复合格吗」「下一步调哪个模型」。这类决策的共同特征是:高频、窄输出、判据明确。
用前沿大模型干这些活,等于雇了一个博士去流水线上拧螺丝——你并没有用到它的能力,只是在为它的通用性付溢价。Jev 的商业逻辑就是把这 90% 剥离出来:不生成文本(所以输出可以免费),不逐步推理(所以延迟可以做到毫秒级),只返回类型安全的决策。Agent 的模型架构因此正在定型为四层:
┌────────────────────────────────────────────────┐
│  Frontier(大模型)    规划 / 推理 / 疑难决策      │
├────────────────────────────────────────────────┤
│  Flash(通用小模型)   写作 / 摘要 / 普通生成      │
├────────────────────────────────────────────────┤
│  Decision Model        路由 / 分类 / 校验 / 高频判断 │
├────────────────────────────────────────────────┤
│  确定性代码             规则 / 计算 / 数据库操作    │
└────────────────────────────────────────────────┘
        ↑ Harness 负责调度:每个任务落到哪一层
到这里,故事听起来像「小模型的春天」。但 Jev 自己给出的证据,恰恰划出了这条路线的边界。
二、先别急着蒸馏:两组数字
第一组:独立基准 jabr v2(49 个任务 869 例,由竞争对手 von 的作者自测——方向对自家不利,相对可信),Jev 得 96.6%,开源最好的 von 只有 71.5%。碾压。
第二组:TypeSafe 自家的多任务 workflow 评测(厂商自评,独立媒体转引;官方承认数字未经独立复现),Jev 得 67.8%,GPT-5.6 Terra 67.9%——打平,还低于 Sol 的 74.1%。
两组数字合起来说明什么?在分布稳定的窄分类任务上,专用决策模型可以碾压开源同类;但在多样化的多任务工作流上,它对前沿大模型只是平价——赢的不是准确率,是成本和延迟($0.0004/case 对 $0.03–0.18,0.4 秒对 10–38 秒)。它的优势是有条件的。
条件之外还有暗坑。一份用扑克 GTO solver 做对照的独立评测(backnotprop)打到它的软肋:在训练分布外的决策题上,Jev 与正解的一致率只有 33–44%,置信度还倒挂——对错误决策给出 0.86 的置信,对接近正解的只给 0.09。「校准」这个核心卖点,出了分布就失效。小模型没有大模型的泛化冗余,分布一漂就悄悄烂掉,而且它自己不知道。
蒸馏这条「大模型教小模型」的路也不是免费午餐。一位日本开发者的实验:把模型蒸馏成 0.6B/2B 的学生,学生全都不及 27B 的 teacher。同样叫蒸馏,结果可以差一个档——差别不在算力,在有没有评测集(evals)和训练配方当模具。
所以真正的判断线不是「该不该用小模型」,而是任务特征:
| 任务特征 | 正确选择 | 会计性质 |
|---|---|---|
| 量小,或分布不稳,或判据说不清 | 前沿/Flash + 结构化输出 | opex,按用量付费 |
| 量大 + 分布稳定 + 判据明确 | 蒸馏小模型 / 决策模型 | capex,先付管线后省推理 |
| 分布外 / 新出现的任务 | 大模型兜底 + 触发再训练 | 保险,不能省 |
这就是《你烧的 token,是资产还是费用?》那本账在模型分层上的重演:直接调大模型 API 是 opex,蒸馏专用小模型是 capex。判断变量 = 任务量 × 分布稳定度。量不够就急着蒸馏,省下的推理费付不起迭代成本——这是很多团队真实的亏法。
三、「你不是说过别省 token 吗?」
写到这里,老读者会抓到一个把柄:我二月写过《任何省 Token 的做法都不是大模型的最佳实践》,点名反对过「用更小的模型替代」。现在又教大家把小活给小模型,这不是打自己的脸吗?
不矛盾,因为两篇说的语境不同。#125 反对的是:在需要智能上限的场景——探索、复杂推理、生产——把「省 token」当目标去压缩上下文、降级模型。那是用产出质量换钱,越省越穷。本文说的是:在分布稳定、输出窄、判据明确的运行环节用大模型,那是为不需要的通用性付溢价。
底层原则其实是同一条:每个 token 都该买它该买的东西。 生产端要买智能上限,别省;运行端要买判断速度,别多花。错的从来不是「用小模型」,而是「用小模型省生产的钱」和「用大模型烧运行的钱」——两个方向同样是错。
而且大模型并不退出运行端,它的运行角色从「干所有活」变成两个新岗位:兜底——小模型置信度低、漂移监控报警时,升级到它处理;触发再训练——兜底积累的样本回流成新的标注数据。扑克评测正是「为什么必须留兜底」的证据:小模型在分布外会静默失效,你不能指望它自己报错。
四、大模型的岗位说明书:模具厂
把上面拼起来,大模型的正确岗位说明书有三条,全在生产端:
- 训练小模型——跑标注、造训练数据、蒸馏专用模型;
- 开发 Agent——写代码、搭工作流、调 prompt;
- 优化 Agent——造 evals、分析失败案例、迭代任务定义。
一句话:大模型是模具厂,evals 和任务定义是模具,小模型和跑起来的 Agent 是压出来的零件。
这正是《软件工厂 3.0:从卖人月到卖模具》那套逻辑在模型分层上的投影。而《当智能变得免费,什么东西在涨价》里的关键判断在这里直接适用:零件会贬值,模具不会。 你今天蒸馏的小模型,明年可能被下一代通用模型免费覆盖——Flash 级模型的价格两年降了一个数量级,这种事一直在发生;但你的评测集、任务定义、标注数据、漂移监控,不会被任何模型升级覆盖,它们是你手里唯一能决定「什么时候换零件」的东西。
最危险的资产结构恰好是反过来的:一堆为省钱蒸馏出来的小模型(那是负债,还要持续投入维护),没有 evals(那是瞎子,不知道零件什么时候坏的)。
五、落地顺序:先模具,后零件
顺序不能反。完整的流程是这样:
- 大模型先跑——用前沿模型跑目标任务,积累真实样本和标注数据;
- 先造模具——把样本固化成 evals。换任何模型之前,先有一把能判对错的尺子;
- 验证分布——漂移监控上线,确认任务分布稳定;
- 算账再蒸馏——日均调用量 × 单次节省 > 蒸馏管线的月成本,才动手(阈值自己算盈亏平衡,别抄别人的数字);
- 留好兜底——低置信样本和漂移报警自动升级到大模型,处理结果回流成再训练数据。
第 2 步和第 4 步的顺序是关键:先蒸馏、后建 evals 是本末倒置——没有尺子,你连蒸出来的模型是更便宜还是更差都不知道,省下的每一分钱都是没验收的。
路由逻辑写出来大概是这样:
from dataclasses import dataclass

@dataclass
class TaskProfile:
    daily_calls: int        # 日均调用量
    dist_stable: bool       # 分布稳定:漂移监控上线且近期无报警
    has_evals: bool         # 已建领域评测集
    out_of_dist_risk: bool  # 高频出现分布外样本

def choose_model(t: TaskProfile) -> str:
    if t.out_of_dist_risk or not t.dist_stable:
        return "frontier"         # 大模型兜底,先积累样本
    if t.has_evals and t.daily_calls > 50_000:  # 阈值为示意,按盈亏平衡自算
        return "decision_model"   # 量够大 + 有模具:capex 划算
    return "flash"                # 中间态:通用小模型 + 结构化输出

# generated by hugo AI
注意这个函数的输入:没有一项是「模型跑分」,全部是 你自己业务的状态——量、分布、模具。选模型的依据从来不在模型排行榜上,在你的账本和监控里。
写在最后
Jev 本身未必是最终赢家:开源替代 48 小时内跟进,大厂的结构化输出越来越好,这个品类没有专利护城河,连它引以为傲的校准都会在分布外失效。但它赌的那个分工大概率成立——决策层正在从 LLM 里剥离出来,大模型退回流水线背后。
所以对你来说,问题不是「要不要接 Jev」,而是:你的组织里,大模型现在在干什么?在流水线上拧螺丝,还是在工厂里造模具?
如果你的大模型预算全部烧在运行端的重复判断上,你是在用最贵的资源做贬值最快的工作。把它调回生产端——造 evals、训小模型、开发和优化 Agent——这些产出不会随模型迭代贬值,反而是每次模型降价都让你手里模具更值钱的前提。
你的大模型现在在哪个岗位?欢迎留言聊聊。