全世界此刻活着大约四百个患早衰症的孩子。这种病的发病率是四百万分之一——有记录的病例,从 1886 年第一次被医学文献描述算起,总共只有一百多例到四百例之间(不同登记系统的口径不同)。他们的智力完全正常,身体却在以十倍速衰老,平均寿命十四年半。
2020 年 11 月,第一种药获批:Zokinvy。平均延长生命两年半——在日本的批准数据里是四年多。
这已经是人类为这四百个孩子做过的最好的事。但如果你去看这个药是怎么来的,会发现一件事:商业逻辑从头到尾都没成立过。
出资推进全部临床试验的,不是哪家大药企,是一个患者家庭办的基金会(Progeria Research Foundation,1999 年由 Sam Berns 的家人创办——Sam 是那个在全网留下「我选择快乐」演讲的早衰症男孩)。基因是基金会资助的科学家在 2003 年发现的,从基因发现到药物获批走了十七年。最终做这个药的,是一家专做超罕见病的小公司。
几百个患者,十七年,延长两三年寿命。这笔账,按任何商业标准都算不平。但我想说的不是「算不平所以不该做」——恰恰相反:
算不平,才是问题所在。不是「没人想」,而是在人类过去的组织方式下,这几百个孩子根本「配不上」一个研究团队。
一、一个用了几十年的公式
吴泳铭在云栖大会上讲了一个判断:当 AI 具备专业研究所需的智力水平,只要算力足够多和便宜,每个细分领域都可以组织上百万个 Agent 持续研究、模拟和验证——「顶级思考,将从奢侈品变成可规模化供给的商品」。他举的例子,恰好也是早衰症:这样的罕见病很难获得充足的研究资源,很少有公司愿意花十几年时间、耗费巨资,为几百人研发一种新药。
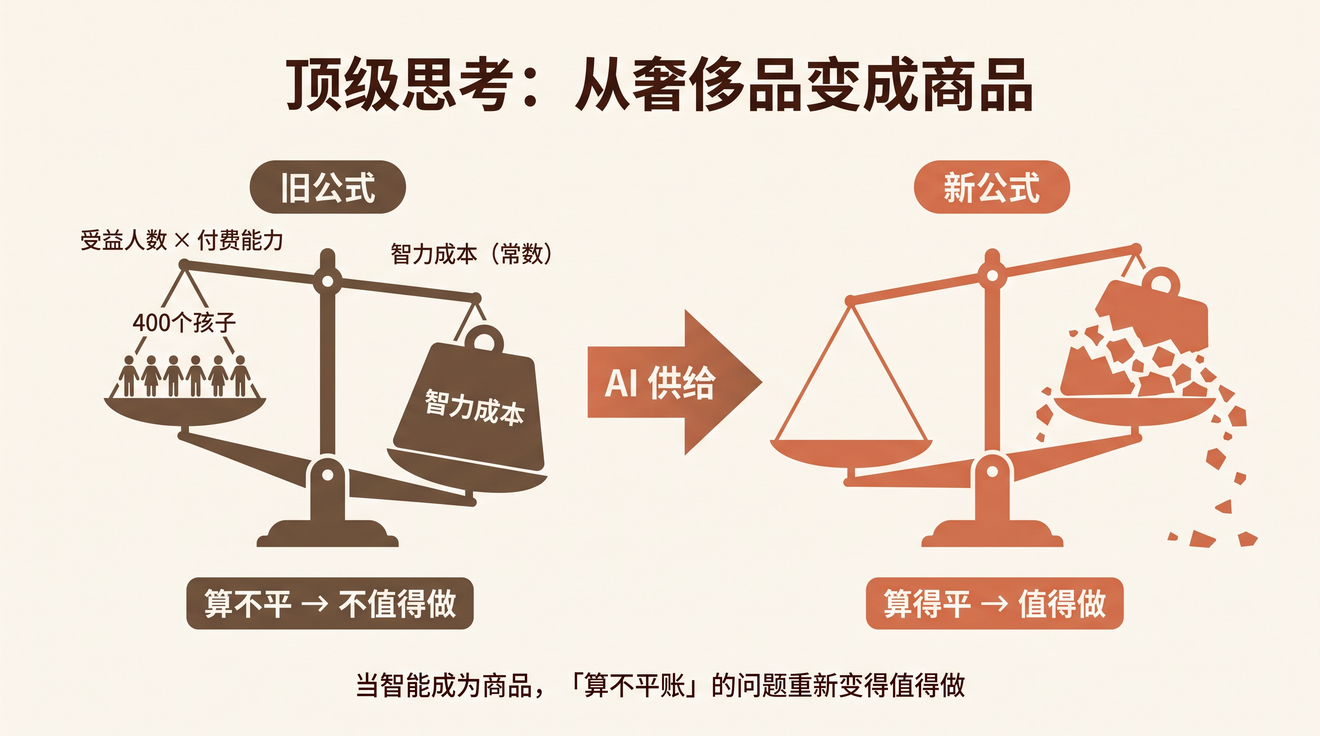
把这个判断翻译成一个公式。过去几十年,人类决定「什么问题值得解决」,用的都是同一个式子:
值得做 ⟺ 受益人数 × 每人付费能力 ≥ 所需智力投入的成本
这个公式的右边,过去几乎是个常数。培养一个能研究早衰症的科学家要二三十年,全世界这个领域的专家一只手数得过来;他们的时间是世界上最稀缺的资源之一,稀缺到——只能分配给公式左边足够大的问题。
所以这个公式实际上反着用:不是「这个问题重不重要」,而是「受益人数 × 付费能力够不够大,大到能雇得起那些昂贵的头脑很多年」。早衰症的孩子卡在左边:四百个人,每个家庭就算倾家荡产,也凑不出十七年的顶级研发。
于是一大类问题被公式判了死刑:罕见病、超垂直行业、小语种文化、只有几百个用户的工具、某个小县城特有的治理难题。它们不是不重要,是 没资格获得足够的智能。
吴泳铭演讲里那句「顶级思考将从奢侈品变成可规模化供给的商品」,说的就是这个公式的右边要塌了。机器思考总量目前不到人类的 3%,他的判断是未来会达到人类的 1000 倍以上(这是演讲口径,具体倍数未必准,但方向没有争议:智力供给正在和人口脱钩,变成一种可按需扩张的基础设施)。
当右边从常数变成商品,「值得做」这个集合会突然变大——所有当年「因为算不平账而没做」的事,都要重新算一遍。
二、这个转折,历史上发生过一次
这不是猜想。智力成本坍缩导致「值得做」集合爆炸,过去三十年发生过一次完整的先例:基因测序。
2000 年前后,人类基因组计划完成时花了约三十亿美元、十三年(官方口径,27 亿美元/13 年)。今天测一个人的全基因组,几百美元——成本降了大约六个数量级。接下来发生的事:以前只有顶级实验室能做的分析,普通实验室也能做了;以前「样本太少、测不起」的研究方向被打开了;罕见病的基因诊断从天方夜谭变成临床常规——早衰症的基因能在 2003 年被发现,本身就是测序成本第一次大幅下降的直接受益者。
测序成本坍缩没有让基因学家失业,它让 更多问题变成了可研究的。
第二个先例更近:AlphaFold。2022 年,DeepMind 把超过两亿个蛋白质的预测结构一次性公开——单个蛋白质结构的解析,从以月计的晶体学实验变成以分钟计的计算。结构生物学的一道智力壁垒直接消失,药物靶点筛选里「算结构」这一环的成本被压到接近零。
两次都是同一个模式:某种智力供给的成本坍缩 → 一批「算不平账」的问题重新变得值得做 → 瓶颈迁移到下一环。
三、最强的反方:瓶颈根本不在「想」
写到这里,必须正面回应一个很强的反驳:
罕见病的真正瓶颈不在「没人想」,而在临床试验、审批和生产。AI 生成一百万个分子假设很容易,但你没有一百万个病人可以验证——四百个孩子,招募一个对照组都要全球协作。湿实验的速度,不会因为干实验变快而变快。
这个反驳,我认一半。
认的一半:AI 不移除所有瓶颈,它只移除 智能供给 这一个瓶颈,然后瓶颈会迁移到验证端。指望「有了 AI,罕见病明年就攻克」,是把迁移误当成消失——和《能上春晚的项目,和能赚钱的项目》里讲的泡沫区是同一种错误。
不认的一半:瓶颈迁移就是进步,而且是历史上验证过的那种进步。 第一,Zokinvy 的十七年里,相当大一部分时间不是花在「想」上,而是花在试验和审批上——但前提是「想」的部分先有足够的人和钱。没有足够的思考,验证根本排不上日程:一个没有候选分子、没有作用机理假设的病,连临床试验的申请都写不出来。第二,历史上每次智力成本坍缩之后,验证成本都跟着降了——测序成本降了六个数量级之后,合成生物学、CRISPR 的验证通量也跟着上来了。瓶颈迁移不是终点,是下一轮成本坍缩的起点。
所以准确的表述是:AI 不会让四百个孩子明年有药,但它会让「为四百个孩子组织一场持续十七年的顶级研究」这件事,从需要基金会卖房筹款的奇迹,变成一个算力问题。
四、把公式用在自己身上
这个判断对个人和组织,各有一个直接推论。
个人:你的「不值得做」清单,需要重估一遍。 过去你放弃的一些方向,不是因为不重要,是因为按旧公式算不平账——「学这个没有市场」「做这个工具就几十个人会用」「研究这个问题没人付钱」。《学 AI 要学让你赚钱的 AI》里我说判断标准是「有没有人愿意为它付钱」,这条仍然成立——但要加一个注脚:当智力成本坍缩,「有没有人付钱」的门槛也在降。以前要一万个付费用户才能养活一个方向,现在一百个可能就够,因为服务他们所需的智力投入便宜了一个数量级。旧公式判过死刑的小方向,值得重新上诉。
from dataclasses import dataclass

@dataclass
class Problem:
    beneficiaries: int      # 受益人数
    willingness_to_pay: float  # 每人每年付费意愿(元)
    intelligence_cost: float   # 所需智力投入的年成本(元)

def worth_doing(p: Problem) -> str:
    revenue = p.beneficiaries * p.willingness_to_pay
    if revenue >= p.intelligence_cost:
        return "值得做:旧公式也成立"
    if p.intelligence_cost > 0 and revenue / p.intelligence_cost > 0.01:
        return "重估区:智力成本若降两个数量级,就成立"
    return "放弃:瓶颈不在智力"

# 早衰症新药(旧世界):400 人 × 家庭极限付费 << 17 年顶级研发
#   → 旧公式:死刑。需要基金会 + 使命驱动才能翻案
# 早衰症研究(AI 供给):intelligence_cost → 算力账单
#   → 进入重估区:瓶颈迁移到临床验证
# generated by hugo AI
组织:AI 投入的长期价值,藏在「以前不划算」的事里。 给一千个大客户做智能化,是效率故事,大家都会做,做完也只是不掉队。真正的超额价值在旧公式判过死刑的那一侧:以前「客户太小,服务不起」的长尾客户、以前「需求太碎,不值得排期」的场景、以前「没有专家,进不去」的行业。这正是《当智能变得免费,什么东西在涨价》的反面推论:当智能免费,涨价的不是智能本身,是那些终于变得可行的问题。
社会:这是智能时代最深的一种公平。 过去四十年,技术普惠的主线是「让买不起的人买得起」——手机、流量、云服务。AI 的普惠是更深一层:让「算不平账」的问题获得智能。 富人区的孩子和罕见病的孩子,第一次在「能获得多少顶级思考」这件事上站在同一条成本曲线上。
写在最后
回到那四百个孩子。
Zokinvy 延长的那两年半,是基金会、小公司、十七年和无数善意硬扛出来的。它证明了一件事:这个问题值得做——只是旧公式说它不值得,所以它等了一个世纪。
公式现在死了。不是因为它错了,而是因为它的右边塌了。当顶级思考从奢侈品变成商品,「值得做」的边界会向外推一大截——推到罕见病,推到小语种,推到每一个曾经「算不平账」的角落。
至于瓶颈迁移到验证端之后怎么办?那是下一个十七年的事。但至少,下一个四百个孩子,不用再等一个卖房筹款的奇迹。
你或你的组织里,有什么「以前算不平账、现在值得重估」的方向?欢迎留言。