Meta 本月发布 personal agent「Muse」时,同时公开了一份赏金价目表:有效漏洞报告最高 30 万美元,其中单独一档——「成功影响一个用户的 prompt injection」——最高 13 万美元。
看清楚这一档在买什么:不是买「别进来」,是买「进来给我看」。一家把 agent 接到用户邮箱、日历、浏览器、Shell 和银行卡的公司,公开为「攻破我的 agent」付钱。这不是自信,这是承认:注入不可根除。
承认之后呢?Meta 同一篇文章里给出了整个行业目前最完整的答案,题眼是一句话:
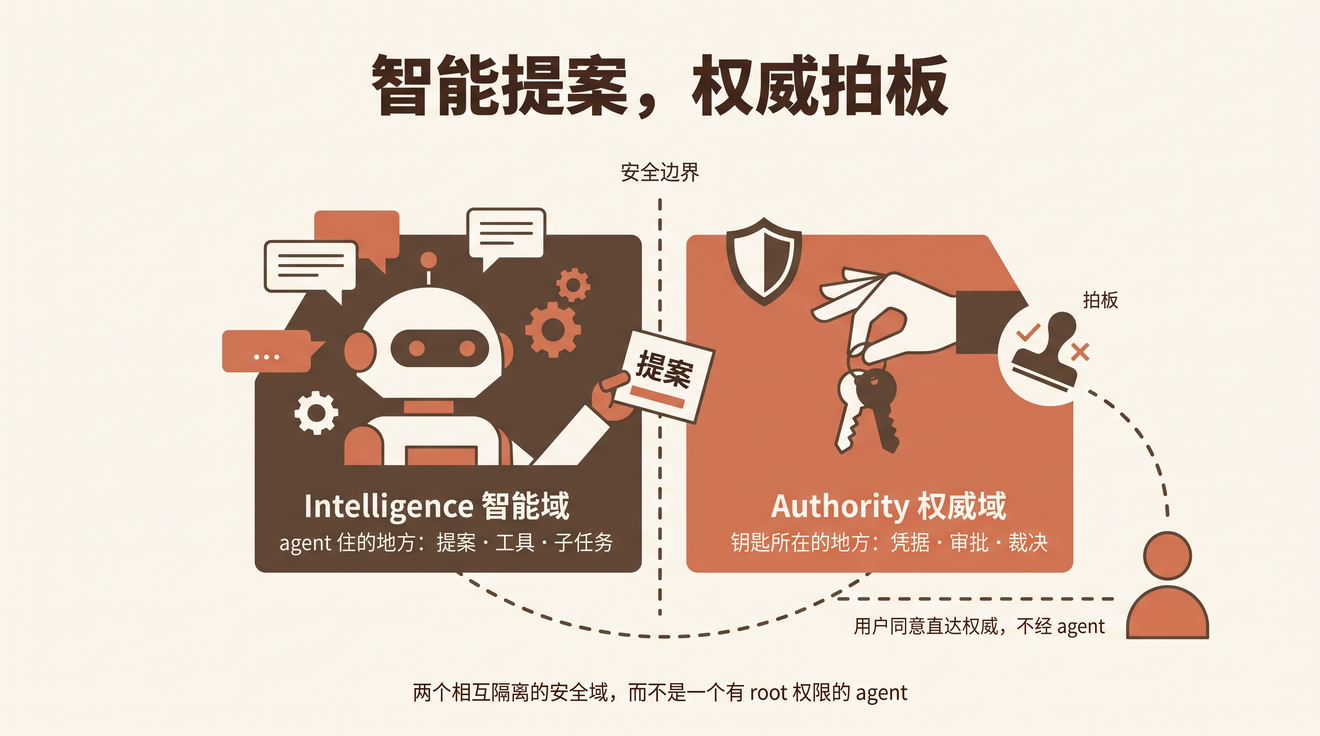
一台机器上的两个相互隔离的安全域,而不是一个有 root 权限的 LLM agent。 (two isolated security domains on one box, not an LLM powered agent with root)
一、问题本身就问错了
Chatbot 时代的安全问题是:「回答错了怎么办?」答案是事实核查、RAG、更好的模型。
Agent 时代的问题变了。Muse 有长期上下文、在后台运行、会派生子 agent 蜂群、会自己写工具——它的日常就是替用户读邮件、改日历、逛网页、花真钱。这时真正的问题不是「回答错了怎么办」,而是:
假设 agent 一定会犯错,甚至假设它已经被 prompt injection 完全控制——系统如何保证损失仍然有限?
Meta 原文的表述几乎是逐字的:assume the agent may be under attack, and limit the potential damage。注意这个假设的彻底性:不是「降低被攻破的概率」,是 把「已被攻破」当作系统的正常工况来设计。
这是安全工程的老传统(飞机不假设引擎不坏,假设引擎一定坏),但在 AI 行业是新立场——因为绝大多数 agent 产品的安全叙事还停留在「我们的模型很抗注入」这一层。
二、答案:两个安全域,三权分立
Muse 的每个用户有一台专属云 VM。VM 里面被切成两个互相隔离的安全域:
域一:runtime cell(agent 住的地方)。 systemd-nspawn 容器,装着 harness、用户工作区、工具执行环境。容器内的 root 被映射为宿主机的非特权用户;独立 rootfs、虚拟网卡、syscall 过滤、capability 裁剪。agent 在自己的房间里怎么折腾都行——房间本身出不了事。
域二:cell 外的安全服务(钥匙所在的地方)。 凭据存储(authd)、权限权威(Sentinel)、安全分类器(hatch-safety)、按 connector 拆分的特权 worker(privsep)。agent 与它们只能通过 Unix socket 通信,对端身份由内核凭证(SO_PEERCRED)验证——不是 agent 说它是谁它就是谁,是内核说它是谁它才是谁。
原文把这层分工写得像一部宪法:privsep 决定凭据代码在哪跑,authd 决定谁能拿到什么凭据,Sentinel 决定一个动作能不能做。而 agent?
Agent 只有提案权。 它提出「我想调用日历连接器写一个日程」,Sentinel 裁决这个动作过不过、用什么凭据、走什么通道。智能负责提案,权威负责拍板——这就是全部架构的一句话版本。
三、三个比「防注入」更狠的设计
其一:agent 永远见不到真钥匙。 agent 手里拿的是 surrogate token(代理令牌),真凭据由 Sentinel 在网络边界即时换入——凭据从不进入 agent 的上下文。原文用了个斩钉截铁的词:任何试图通过注入胁迫 agent 交出真实密钥的尝试,都是 futile(徒劳)。支付同理:单次卡号绑定商户、金额、时限,偷到也花不出去。这一层的设计哲学不是「阻止攻击」,是 让攻击无意义——$130k 赏金敢开,就是因为赌注入成功了也带不走东西。
其二:读过的东西会被标记。 tainted egress——内核级污点追踪(eBPF + 自加 LSM hooks):进程初始是干净的,一旦读了用户数据就变「脏」;干净进程的网络请求可以走窄边界自动放行,脏进程的一切外发回落人工审批。这是把上世纪的 OS 信息流控制(Bell-LaPadula 那一脉)搬进了 agent 系统。通篇看下来,Muse 安全架构其实是一场 老 OS 安全的复兴:privsep 是 OpenBSD 的概念,nspawn、cgroup、capability 裁剪全是经典件。Meta 自己定了性:这是 OS 问题,不是 AI 问题。
其三:审批通道绕过 agent 本身。 需要用户点头的动作,弹窗由 Sentinel 直接发到客户端 UI,用户的答复直接路由回 Sentinel——全程不经过与 agent 的对话。为什么这么设计?因为一个被攻陷的 agent,恰好最有可能伪造「用户已同意」。审批必须是 strict capabilities(严格能力凭证),不能是 conversational suggestions(对话里的建议)。授权分五档:一次性、单会话、单任务、限时、永久——摩擦被精确地放在「同意真正重要」的地方,日常操作照常流动。
四、最强反方:这是不是过度设计?
反方有两个版本,都值得正面回答。
版本一:给每个 agent 配一个「持钥匙人」,摩擦大到没法用。 回答:五档授权就是对摩擦的定价——低风险自动过,不可逆的才上人工。而且这个反方搞反了因果:不是安全设计带来了摩擦,是 agent 拿着真钥匙才没有摩擦。没有摩擦的 agent 系统,摩擦只是转移到了用户身上——以事故的形式。
版本二(更深):hatch-safety 分类器也是 AI,这不还是「用 AI 管 AI」? 我在《Agent 安全是企业安全的新命题》里写过「用 AI 管 AI」的执行控制体系,这个反方正是冲它来的。Muse 的回答很微妙:分类器确实在,而且是独立于主模型训练的(原文:独立训练能达到显著更高的准确率——窄而高频的判断,专用模型胜过通用大模型亲自上阵,这与《大模型该在工厂里,不在流水线上》的结论同构)。但请注意架构里谁在最后一层:分类器是缓冲,Sentinel 是权威;缓冲可以是概率的,权威必须是确定的。 持钥匙的东西自己不能是概率性的——「用 AI 管 AI」的最后一公里,是「用不用 AI 的东西管 AI」。
五、组织含义:发工号容易,发钥匙难
把 Muse 当成一个「数字员工的个人版」来看,它的架构对企业落数字员工是一份现成的编制方案:
数字员工权力审计三问(对照 Muse 架构):

1. 钥匙在哪个域?
   凭据/权限/审批链在 agent 够不到的地方,还是在它的
   上下文和配置文件里?
   —— agent 见得到真凭据的系统,注入成功 = 全线失守

2. 审批通道绕不绕过 agent?
   用户/管理者的「同意」是直达权限系统,还是经由
   agent 转述?
   —— 经由 agent 的同意,等于让被审计人填写审计结论

3. 读过敏感数据的进程,外发受限吗?
   有没有污点追踪?还是任何子任务都能把读到的
   一切发往任何地方?
   —— 无标记的外发通道,就是注入的取款机
# generated by hugo AI
三问背后是同一个组织学判断:数字员工的正确编制,不是「更像人的员工」,而是「有提案权的实习生 + 持钥匙的门卫」。 工号、权限、审批链必须归组织平台持有——这不是对 AI 的不信任,是对一切代理人的基本制度设计,人类员工同样适用(财务和出纳也不会是同一个人)。
这也让「Spec 是数字员工的劳动合同」这个说法有了更精确的含义:合同约束的从来不是智能,是权限。 一个数字员工能干什么,不由它多聪明决定,由合同(capability 凭证)写了什么决定。
最后一个边界,Meta 自己诚实披露的:这套架构今天防攻击者、防 agent,不防 Meta 自己——密码学可验证的 Confidential VM「今年晚些时候」才上线。评估任何平台的 agent 安全架构时,都值得多问一句:安全边界防谁?
结尾:孟德斯鸠进了机房
三权分立是个老发明:立法提案、行政执行、司法裁决,谁也不能既提案又拍板——不是因为不相信掌权者的德性,是因为权力集中本身不可接受,无论掌权的是人还是模型。
Muse 把这条原则翻译成了架构:agent 提案,Sentinel 拍板,审批通道独立于两者。智能与权威,从此是两个安全域。
回到开头那笔 $130k 的赏金。现在可以读懂它的完整含义了:Meta 不是在买「别进来」,是在买「进来也没用」——钥匙不在房间里,标记跟着数据走,同意走的是 agent 碰不到的通道。
攻击者可以赢得对话,但赢不了架构。
这大概就是 agent 时代安全的最终形态:不承诺智能不出错,只承诺出错也越不出权限的笼子。 对企业来说,好消息是这套范式不需要等 Meta——三问审计今天就可以对着自己的数字员工做一遍。
你的 agent 系统里,钥匙和智能在同一个域吗?欢迎留言聊聊。
(架构细节核对自 Meta research 官方博客 Security and safety for AI agents: our approach with Muse(2026-09-08,作者 Tarek Sheasha);引文为原文直译。)