Anthropic 昨天发布 Opus 5.5,标题新闻是降价:同样的工作负载,成本比上一代低约 40%。
但这篇发布博客里最值钱的不是降价,是一组没上标题的数据。他们拉了 2026 年 3 月到 9 月 Claude Code 的聚合账单,发现每个请求的 输入与输出 token 之比,从 189:1 涨到了 324:1——六个月内,每个请求的上下文膨胀了 2.6 倍。
翻译一下:你的 AI 账单,早就不是「写」出来的,是「读」出来的。 输出只占 token 总量的千分之三;就算算上输出单价通常是输入的三五倍,砍掉一半输出,账单也就省下不到一个百分点。生成是零头,重读上下文才是大头。
而且账单还在搬。博客里引用开发者 Addy 的一句话,我认为是全文最重要的一句:
减少一个轮次,比一个缓存 token 还要更省成本。
token 之后是缓存,缓存之后是轮次。今天把这条搬家路线讲清楚——因为它直接决定你该在哪里省钱、在哪里花钱。
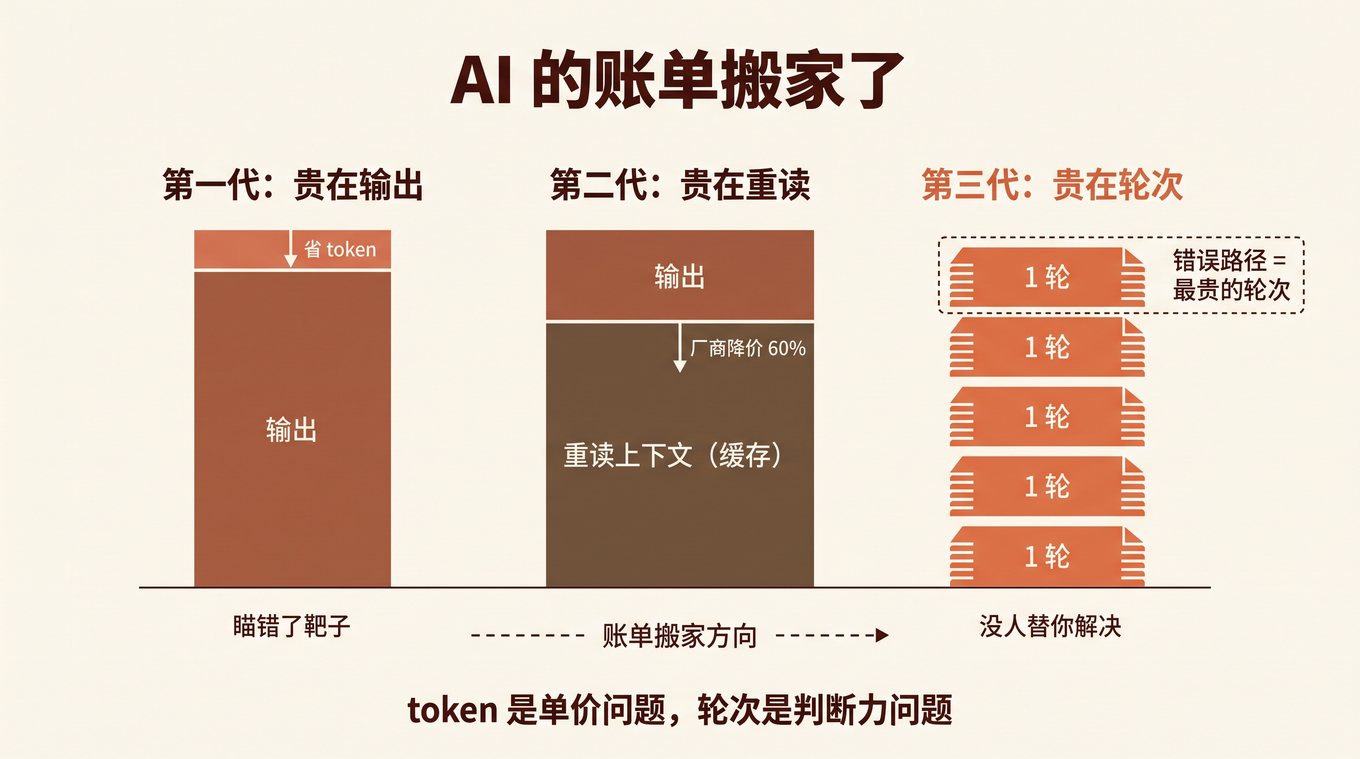
一、账单的第一次搬家:从输出到重读
早期的 AI 账单贵在输出。模型按生成收费,写得越多花得越多——于是出现了一代人肉省 token 的操作:system prompt 压到一两句、对话历史手动截断、能不问就不问。
我在《任何省 Token 的做法都不是大模型的最佳实践》里说过,这是用过去的稀缺思维应对未来的丰裕现实。这次的数据给了那句话一个更硬的版本:省 token 的人,从头就瞄错了靶子。 324:1 意味着什么?你砍掉一半输出,账单只动了不到一个百分点(输出占 token 总量千分之三,单价再贵也就把账单占比抬到 1% 上下);而上下文里多塞一份没用的文件,每个请求都要为它重读付一遍钱。
账单的大头搬到了「重读」,厂商的定价跟着搬:这次输入输出降 20%,缓存读取直接降 60%——因为 agentic 工作的成本里,缓存读取占大头。降到什么程度?Opus 5.5 一个缓存 token 的价格,只有竞争模型的五分之一。
更有意思的是行为数据:上下文涨了 2.6 倍,你以为缓存未命中会跟着涨,实际未命中的输入反而降了超过 50%。上下文变大、命中变准,两件事同时发生。这不是玄学,是 harness 的工程成果:中途换模型、改推理强度、按需加载工具、fork 子代理——这些过去会「割手」毁掉缓存的操作,现在都不再重置缓存;子代理直接从父级的缓存起步,同一份上下文不用付两次钱。
缓存从省钱技巧变成了基础设施。 记住这一点,第二节要用。
二、账单的第二次搬家:从 token 到轮次
Addy 那句话再说一遍:减少一个轮次,比一个缓存 token 还要更省成本。
为什么?算笔账就明白。一个轮次 = 模型读完全部上下文 + 思考 + 调用工具 + 等结果 + 再读一遍。在 324:1 的结构下,每多一轮,那 324 份输入就要重读一次——哪怕全走缓存,也是真金白银。轮次是上下文的乘数。 token 单价降 60%,省的是每一轮的钱;轮次少一半,省的是整轮的钱,连同轮里所有的重读、思考和等待。
Zeta Labs 的实测印证了这个结构:换成 Opus 5.5,每个任务的轮次和工具调用都更少,成本几乎只有一半——而且 最难的任务完成数量翻了一倍。便宜和能干,第一次不是权衡关系。
但注意 Anthropic 自己在博客里划的边界,这比数据更诚实:
在一个范围明确的任务上,两个模型完成的轮次差不多,你能得到的就只是降价而已。差距应该在开放式任务上最大——那类任务里模型可能在一个错误的想法上花掉许多轮次。
拆开读:封闭式任务,账单不搬家——轮次由任务本身决定,模型再强也就省个单价。开放式任务,账单整个搬进了轮次——模型在错误路径上烧掉的每一轮,都是最贵的 token。
所以三代账单结构长这样:
第一代:贵在输出
  → 应对:省 token(写短点、截断历史)
  → 结局:瞄错靶子,输出只占账单 0.3%

第二代:贵在重读
  → 应对:缓存工程(命中率、生命周期、fork 继承)
  → 结局:厂商替你解决——缓存价降 60%,未命中降 50%

第三代:贵在轮次
  → 应对:???
  → 这是唯一还没人替你解决的一层
# generated by hugo AI
前两代的应对方案,一个被证明瞄错了,一个被厂商内建了。第三代的「???」,就是今天真正的问题。
三、轮次是判断力问题,不是模型问题
最强的反方在这里:轮次也会变便宜。 这一代模型比上一代少烧一半轮次,下一代再少一半——按这个速度,「轮次」迟早也会被模型能力吞掉,就像缓存被 harness 吞掉一样。到时候判断力还有什么值钱?
这个反方恰好被 Anthropic 自己那句边界回应了:封闭式任务上,两代模型轮次 差不多。
这说明什么?轮次不是一种模型属性,是一种 任务属性。同一个模型,面对「把这个函数改个名」和「让这个系统的成本高并发下不崩」,轮次差一个数量级——差别不在模型,在任务被给出来的方式:范围清楚不清楚、验收标准明确不明确、约束条件给全没给全。
模型每变强一代,放大的是「会拆任务的人」和「不会拆的人」之间的轮次差。 模型弱的时候,大家都在错误路径上烧轮次,差距被 incompetence 抹平;模型强的时候,拆得好的人一次走对,拆得差的人依然烧——Zeta Labs 那个「最难任务完成数翻倍」,翻倍的是本来根本做不完的任务,那正是拆解和规格能力的用武之地。
这就是 token 和轮次的本质区别:
token 是单价问题,轮次是判断力问题。单价会被厂商卷掉,判断力不会。
缓存降价 60% 是 Anthropic 的决定,你只能接受;但一个任务花 3 轮还是 30 轮,一半取决于你把任务说清楚的能力——把开放式任务切成封闭式任务、把验收标准写进 spec、把约束条件一次给全。这些动作没有任何厂商能替你内置,因为它们发生在模型之外,在你的脑子里。
(熟悉这个系列的读者已经看出来了:这就是《大模型该在工厂里,不在流水线上》的账单版——流水线上比的是单价,工厂里比的是模具。轮次就是模具费。)
四、轮次审计:三条可执行的动作
账单搬家了,动作跟着搬:
1. 个人开发者:别省 token,省轮次。 #125 的结论不变而且更强了——缓存降 60% 之后,给足上下文比以往任何时候都便宜,该塞的 spec、约束、示例大方塞。但塞之前过一道轮次审计:这份上下文能让模型少走几轮错误路径?能,塞;只是「万一有用」,删。判断标准从「字数」换成了「轮次回报」。用 /usage 看你账单里缓存读取的占比,守住它:会话开始就选好模型别中途换、离开前做 compact、长会话开一小时缓存生命周期。
2. 团队:把轮次写进工程指标。 过去看「任务完成时间」,现在该看「任务完成轮次」——同一个任务,谁平均 3 轮做完,谁平均 15 轮,差距就是规格能力的差距。PR 里除了 diff,值得附一句「这个任务怎么给 AI 的」:好的任务描述本身就是资产(它是 evals 的近亲,接 #412:evals 是唯一无法从语料里长出来的东西——任务规格也是)。
3. 组织:缓存是 capex,轮次是 opex。 《你烧的 token,是资产还是费用?》的明年测试可以升级了:上下文库、spec 库、skill 库——这些让每一轮更便宜、让轮次更少的沉淀,是资产(明年还在用,子代理还在继承);为错误路径烧掉的轮次,是纯费用(明年测试:这个错误你明年还会再犯一遍吗?会,因为教训没沉淀)。Anthropic 博客里那句话值得抄在墙上:组织已经从「不惜代价地扩张」转向「高效地扩张」——扩张的效率,就是轮次的效率。
结尾:搬家还会继续
189:1 到 324:1 只用了六个月。账单从输出搬到重读,从重读搬到轮次——下一次搬到哪?也许是「无人值守的小时数」(这次输出速度快了 30%,博客特意提了一句:不会省 token,但意味着长时间运行里 等待更少——时间开始进账单了)。
搬家路线图其实一直有一条规律:凡是厂商能内建的,都会变成基础设施;凡是发生在你脑子里的,才会留在账单上。 输出被定价内建了,缓存被 harness 内建了,单价被竞争卷掉了——留在账单上的,只剩判断力:拆任务、写规格、定验收。
所以省钱的终极答案,和这个系列讲了一路的资产答案是同一个:
便宜的东西都归厂商,贵的东西都归你。 token 会一直便宜下去——把轮次省下来,把判断力攒起来,那才是你账上搬不走的东西。
你的账单里,缓存读取占多少?轮次浪费在哪些任务上?欢迎留言聊聊。
(数据与引文核对自 Anthropic 官方博客《Coding sessions are longer and use more context. Claude Opus 5.5 is built with that in mind.》,Michael Segner,2026-09-24;Addy 引文出自其《What a task costs on Opus 5.5》。)