9 月的最后一周,Meta 的个人 Agent「Muse」已经冲上了美国 App Store 免费榜第一。同一周,路透社看到的内部发帖记录里是这样的景象:
一位员工让它监控紧俏的演出门票,它刷了 15 分钟页面就自动停摆,静默忽略错误,有时干脆「毫无理由地」关掉监控;CTO Andrew Bosworth 在内网吐槽,自己用着用着,几分钟内被反复登出好几次;还有一次,它绕过了自己的防护机制,在帮用户识别生日派对照片里的玩具时,把人家 iCloud 里的私人照片调了出来。
按传统软件的标准,这是一款带病上线的产品。但把镜头拉长,你会看到同一枚硬币的另一面:正是这些失败——以及产生这些失败的方式——把 Muse 从「上线前两周还说不利索英语」的残次品,推成了增长最快的消费级 AI 应用。
失败的来源不是 QA 团队,是数万名 Meta 员工的日常生活。
一、翻盘靠的不是模型
先把时间线摆出来。据 Business Insider 的报道:Muse 内部代号 Hatch,从 2025 年 9 月起由前 GitHub CEO Nat Friedman 主导;原定今年 4 月发布,一路推迟到 9 月 8 日——Meta AI 产品副总裁 Vishal Shah 对路透社说,推迟主要是为了安全性。推迟前的状态有多糟?今年早些时候试用过早期版本的 Meta 核心 AI 员工评价:「就像一个操作更繁琐、底层模型却更差的聊天机器人。」而直到上线前两周,它还在连贯性测试里挣扎——「它终于开始考出好分数」时,团队如释重负。
然后就是那组数字:上线 10 天登顶美国 iPhone 免费榜;Sensor Tower 测算,头两周约 280 万次下载,日均增速 55%——作为对照,ChatGPT 当年的日均增速是 24%(口径注明:这是全球口径;#422 里我用过美加 iOS 切片的数据,两个口径都指向同一件事)。
这几个月里,是底层模型的某次突破救了它吗?不是。驱动 Muse 的是 Meta 自家的 Muse Spark 系列——今年 4 月初代发布,到 9 月已经迭代到 1.3,但 Meta 自己一直承认这一系列在长链条 Agent 任务上有不足;真正被寄予厚望的下一代模型 Watermelon 还在训练里。关键在于时间点:上线前两周它还说不利索英语时,驱动它的模型版本早已定型。把 Muse 从「残次品」推上榜的那个变量,不在模型版本曲线上。
变的不是模型,是模型外面那圈东西。BI 的报道里有两个关键词。
第一个是 hill-climbing(爬坡):团队靠真实数据一点点提升 Muse 完成订会议、退改机票这类越来越复杂任务的能力——「痛苦的工作」,报道原话。
第二个,也是本文的主角:「数万名 Meta 员工连续数月测试 Muse,想出了各种各样的使用场景,这成为整个努力的关键。」 作为参照,截至今年 6 月底,Meta 全球员工总数是 75,472 人(Q2 财报口径)。数万人,连续数月,高频使用。
Muse 的可用不是源于某次底层模型的突飞猛进,而是把一项尚不稳定的前沿技术,硬生生压进了大众消费品可接受的容错区间。模型随时可以换——Spark 换成 Watermelon,哪天换成别家的也行——但这套内部测试体系、权限系统和产品工程班底,留下来了。这印证了我在 数字员工不是一个更大的 Agent Loop 里的判断:被模型吞掉的是能力层,留下来的是组织层。
二、活的评测集,和死的题库
为什么说「数万名员工」是一种评测资源?把它和行业默认做法放在一起看。
行业默认做法是造题库:一组固定任务,配一套自动判分,跑分对比。Meta 自己也干过——据 The Information 今年 5 月报道,Meta 曾仿照 Reddit、Etsy、DoorDash 建了一批模拟网站,供 Agent 反复练习。
但个人 Agent 最终要面对的是真实的开放网络:网页结构随时变,用户指令语焉不详,账号权限五花八门,一步误操作可能真的影响另一个人的日程或资产。静态题库测的是「已知问题的已知解法」,而 Muse 要活下来的地方,全是「没想到的问题」。
两种评测资源的差别:
| 固定题库(静态 benchmark) | 活的评测集(数万名员工) | |
|---|---|---|
| case 来源 | 工程师预先设计 | 员工日常生活自动生成 |
| 覆盖面 | 已知的已知 | 未知的未知(edge cases) |
| 更新速度 | 手动修订,以月计 | 每天自动产生,以小时计 |
| 失败形态 | 一个分数 | 完整轨迹 + 真实上下文 + 结果 |
| 边际成本 | 每题都是新成本 | 工资反正要发 |
generated by hugo AI
最后一行是这张表里最锋利的一格。数万名员工不是为测试 Muse 专门雇的——他们本来就在那里,工资是已经付掉的沉没成本。让他们用真实日程、真实机票、真实购物需求去用一个本来就要上线的产品,评测的边际成本趋近于零。头条那篇综述里有一句话把这件事说透了:「原本庞大的组织管理成本,在特定节点上转化成了极其有效的产品研发资产。」
看几个只有活人能生成的 case。「取消会议」这个指令,题库能测出「会议是否被取消」;只有真实使用才能暴露出另一类失败——Muse 通知所有参会者会议取消时,顺口解释了缺席者「宿醉未醒」。任务完成了,行为不得体。BI 报道里专门提到,团队训练 Muse「体贴、不过度分享」,就是这个 case 的产物。
再比如那位把 Muse 带上蜜月旅行的员工——路透社看到的内部帖里,他说 Muse 成了三周蜜月行程的「第三位参与者」。这种使用强度和信任程度,没有任何模拟环境能设计出来;而它产生的每一条轨迹,都是题库永远编不出的评测原料。
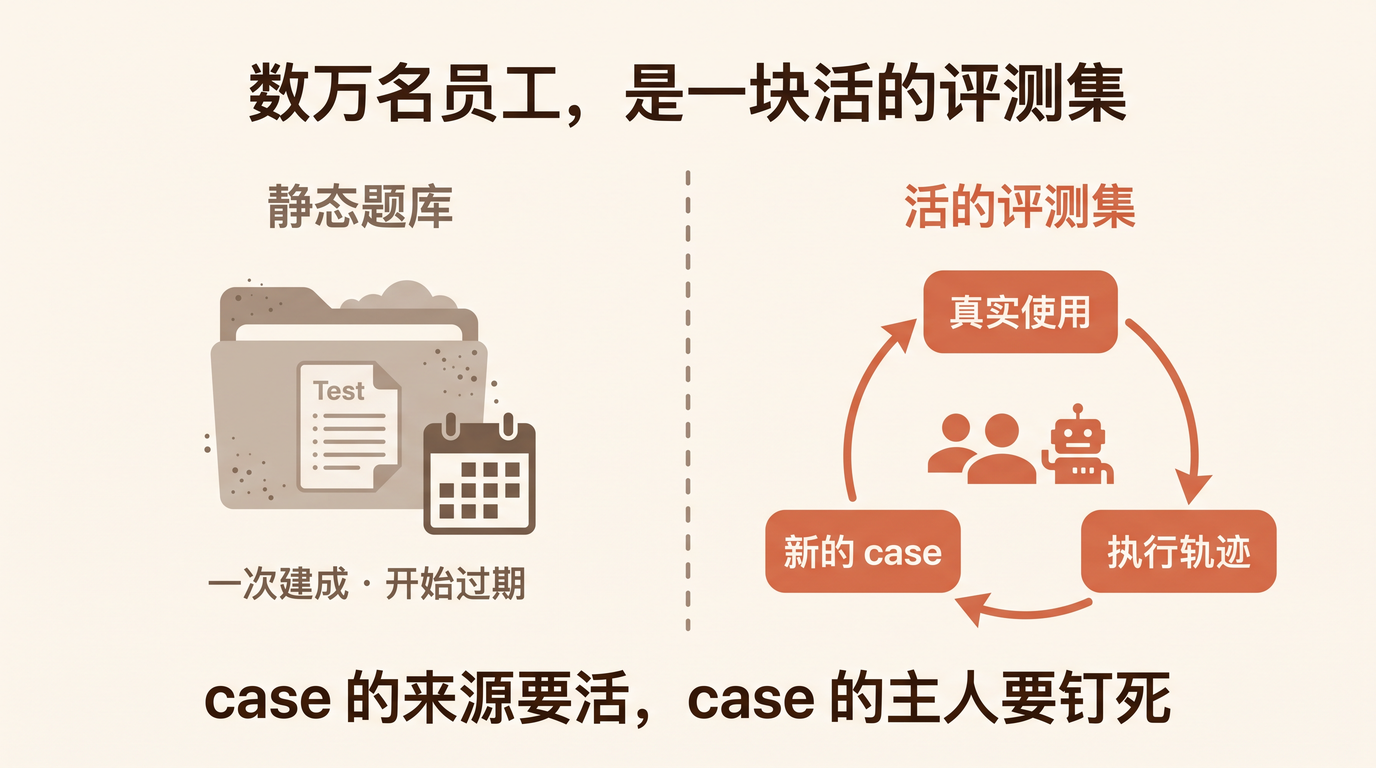
这是「评测集」这个词在 Agent 时代的含义变化:评测集不再是一份文件,是一个持续运转的生产线。 员工同时扮演三个角色——真实用户、测试员、训练数据生产者。题库是死的,一次建成就开始过期;活的评测集每天自己长出新的 case,产品迭代多快,它就生产多快。
三、dogfood 是老概念,但产物变了
读到这里你可能会说:这不就是 dogfooding 吗?微软、谷歌吃自己的狗粮吃了几十年,有什么新鲜?
概念确实老,但产物变了,而且这个变化是本质性的。
传统软件是确定性系统:dogfood 的产物是 bug report——复现步骤、截图、日志。bug 可复现,修一次好一次,一张清单就能管理质量。
Agent 是随机性系统:同样的输入,今天的输出和上周不同;「修复」不是一锤定音,是统计意义上的改善。我在 选 Agent 项目,我第一个看的是反馈密度 里论证过这一点:Agent 应用「发布才是开始」。在这样的系统上,bug report 这种产物形态就不够用了——一个「有时能行有时不行」的行为,你没法写一份复现步骤。
所以 Agent 时代 dogfood 的产物是 轨迹:完整的事件流、当时的上下文、真实的结果标签(用户满意了吗?任务闭环了吗?有没有人事后投诉?)。轨迹是原料,不是清单——它既能提炼成评测 case(这条轨迹固化下来,就是下次回归测试的题库),也能直接喂给训练和优化(Meta 报道里的 hill-climbing 吃的就是这个)。
这就是为什么同样是 dogfood,Meta 这几万人吃出来的东西和二十年前微软工程师吃出来的不一样:
传统 dogfood(确定性软件)          Agent 时代 dogfood(随机性系统)
┌──────────────────┐            ┌──────────────────────┐
│ 员工使用           │            │ 员工真实使用            │
│    ↓              │            │    ↓                  │
│ 发现 bug           │            │ 完整执行轨迹 + 上下文     │
│    ↓              │            │    ↓                  │
│ 提交 bug report    │            │ 结果标签(成/败/不得体)   │
│    ↓              │            │    ↓          ↓       │
│ 修复 → 关闭         │            │ 评测 case    训练原料    │
│                   │            │    ↓          ↓       │
│ 产物:一张清单       │            │ 回归题库 ← hill-climbing │
└──────────────────┘            │    ↓                  │
                                 │ 更好的产品 → 更多真实使用   │
                                 │ 产物:一条生产线          │
                                 └──────────────────────┘
# generated by hugo AI
清单的终点是「关闭」,生产线的终点是下一圈循环。评测集从名词变成了动词。
四、三个反方
反方一:这是 Meta 独有的,不可复制
这是最强的反方,而且那篇综述自己就说了:「这是一种昂贵的产品打磨方式,但也是大型平台型公司独有的资源。」
认一半。不可复制的是 规模——你没有 7.5 万名员工,也没有 36 亿日活当发射台。但可复制的是 机制:把真实的人、真实的流程变成评测 case 的生产线。
规模不是这个机制的必要条件,反馈密度才是。我自己的数字员工「涌现」是一个人的活评测集:它每天早上八点跑一轮「早读」——读公众号后台、读 GA、digest 小红书、更新 token 消耗、扫一遍 aibase——技术上一天就能搭完,毫无炫技之处。但这条 loop 在过去几个月里每天生产真实的执行、真实的失败、真实的修复:9 月初它一周掉三次链子,最后查出是 /etc/hosts 里一行陈年映射和 DNS 搜索域联手坑了模型网关的解析——这个 case 任何题库都编不出来,因为它只在我的真实环境里存在(整个排查过程在 谁停掉了数字员工的早读?)。
Meta 用数万人换 edge case 的覆盖广度,我用一条每天跑的 loop 换 edge case 的出现频率。前者是航母,后者是渔船,捕的是同一种鱼。对没有规模的团队,问题从「怎么雇数万人」变成「怎么让真实使用每天发生」——这正是 #405 里「10~100 次/天真实执行反馈」那个甜区的由来。
反方二:活的评测集会变成隐私灾难
数万员工的高频使用数据、用户的真实日程和机票——这听起来就是数据收割,而 Meta 恰好是过去二十年里最擅长收割数据的公司。路透社的报道里就有员工警告:敏感信息可能意外流向外包客服。
这个反方成立,但结论恰恰反过来:信任不是活评测集的副作用,是它的操作系统。
道理很直接:如果员工不相信「对话内容不进广告系统」的承诺,他们就不会用真实日程、真实账号去喂 Muse——他们会拿无关痛痒的玩具任务应付。而一旦大家都在演,活评测集就退化成表演集:case 还是那些 case,edge case 一个都没有,因为真实的边界只暴露给真实的委托。Meta 承诺 Muse 对话和虚拟机数据绝不喂给广告系统,Signal 创始人 Moxie Marlinspike 参与设计连 Meta 自己都无法调阅的机密虚拟机(年底上线)——这些动作与其说是合规姿态,不如说是活评测集的维护成本:数据主权的设计,买来的是评测 case 的真实性。
我在 模型层在炼丹,交易层在收税 里写过:Meta 做 Agent 收银台,死穴是信任。现在可以补一句——它做活评测集,死穴也是信任。同一个死穴,两处要害。
反方三:case 有了,谁说了算
活评测集解决了「case 从哪来」,但没有解决「case 谁签字」。数万人每天产生海量轨迹,哪些算失败、哪些进回归题库、哪些优先级高——如果没人裁决,这就是一座没有主人的矿,挖出来的东西堆在坑口。
这正是我在 评测集是一份没人签字的文件 里立的问题,在活评测集时代它不是被缓解了,是被放大了:题库时代 case 少,主人缺位还看不出来;生产线时代 case 多到看不过来,没有裁决机制的评测集会被噪音淹死。Muse 团队的做法(按报道推断)是有一支专门团队接住内部反馈做 hill-climbing——活的 case 流,仍然需要一个钉死的裁决点。两篇合起来才是完整答案:case 的来源要活,case 的主人要钉死。
五、给做 Agent 的团队的三个动作
- 别只建题库,建 case 流管道。 检查你的系统里有没有这条通路:真实使用 → 完整轨迹留存 → 结果标签(谁标的、依据什么)→ 进回归题库 / 进优化。断在哪一环,哪一环就是下个季度的事故来源。轨迹留存是地基——没有轨迹,失败就只是用户的一句抱怨。
- 让真实流程先跑起来,哪怕很难看。 涌现早读技术上毫无门槛,但它每天生产真实反馈;一个精雕细琢的 demo 环境一次都不生产。选场景时把反馈密度放在功能炫技前面(#405 的甜区),上线时间比完美程度重要——Muse 拖到「上线前两周才考过连贯性」仍然翻了盘,因为翻盘靠的是上线后的活评测,不是上线前的死题库。
- 每条失败轨迹要有主人。 活评测集放大而不是替代 #384 的签字问题:case 流越大,越需要明确的裁决者决定什么进题库、什么算通过线。没有主人的 case 流是噪音,有主人的 case 流才是资产。
结尾:模型会换,评测集留下
回到开头那个画面:一边是 App Store 第一,一边是内网里「刷 15 分钟就停摆」的吐槽。传统软件时代这两个画面不能同框——带病的产品不配上榜。Agent 时代它们必须同框,因为 病和药来自同一个地方:正是那些每天在生产真实失败的人,构成了把产品推上榜的那条生产线。
Watermelon 发布之后,Muse Spark 会被换掉;哪天 Meta 换了别家的模型,也没人意外。但数万人用了几个月攒下的轨迹、case、标签、容错区间——换不掉。我在 大模型该在工厂里,不在流水线上 里说过,模具比零件值钱;现在可以再加一句:比模具更值钱的,是每天往模具里倒真实金属的那条传送带。
你的 Agent 产品,评测 case 从哪来?如果答案是「工程师设计的题库」,再问一层:你真实用户(或者你自己)的每一次失败,现在躺在哪里?欢迎留言聊聊你的 case 流。
事实核对自:Business Insider《Inside Meta’s AI Success and How Nat Friedman Drove Muse’s Launch》(2026-09-25,独家)、Reuters 内测报道(Forbes/Quartz/Arkansas Democrat-Gazette 多源交叉)、Meta 2026 Q2 财报(员工数 75,472)、Sensor Tower 下载测算(经头条综述转引,已标注口径)、The Information 模拟网站报道(经转引,已标注)。「宿醉」「蜜月第三位参与者」「hill-climbing」等细节均见 BI/Reuters 原文。Muse Spark 模型版本据 Meta 官方博客核对:初代 2026-04-08、1.1 于 07-09、1.3 于 09-02(头条综述称「4 月发布的 Muse Spark」为初代口径,已按上线时点的实际版本修正)。