xAI 的数据分析团队每天要接几十个一次性的分析请求——查一个数、核一个口径、拉一张表。按老办法,要么排队等分析师,要么申请数据仓库权限自己折腾。
他们做了一个 Data Bot,让全公司任何人都能直接拿答案。这个动作本身不稀奇,稀奇的是喂给它的东西:这个团队花了两年,攒出一套覆盖 4.5 万多张表的技能库,整个交给了 Bot。(数字为 xAI 发布材料口径,下同。)里面写的是什么?怎么找对数据、怎么分析欺诈功能的使用、图表要遵守什么规范、怎么安全地更新全公司的仪表盘。
9 月 28 日,xAI 发布 Team Bots:整个团队共享一个 Grok 智能体,Bot 是共享的,每个人和它的私聊保持私密。发布稿里最热闹的段落是「五人团队每天发 100 多个 PR」「保险公司 24 小时搭一个 Bot 挽回 12 万美元」。但我把这篇发布稿读了三遍,认定最值钱的细节是那个不起眼的两年和 4.5 万张表。
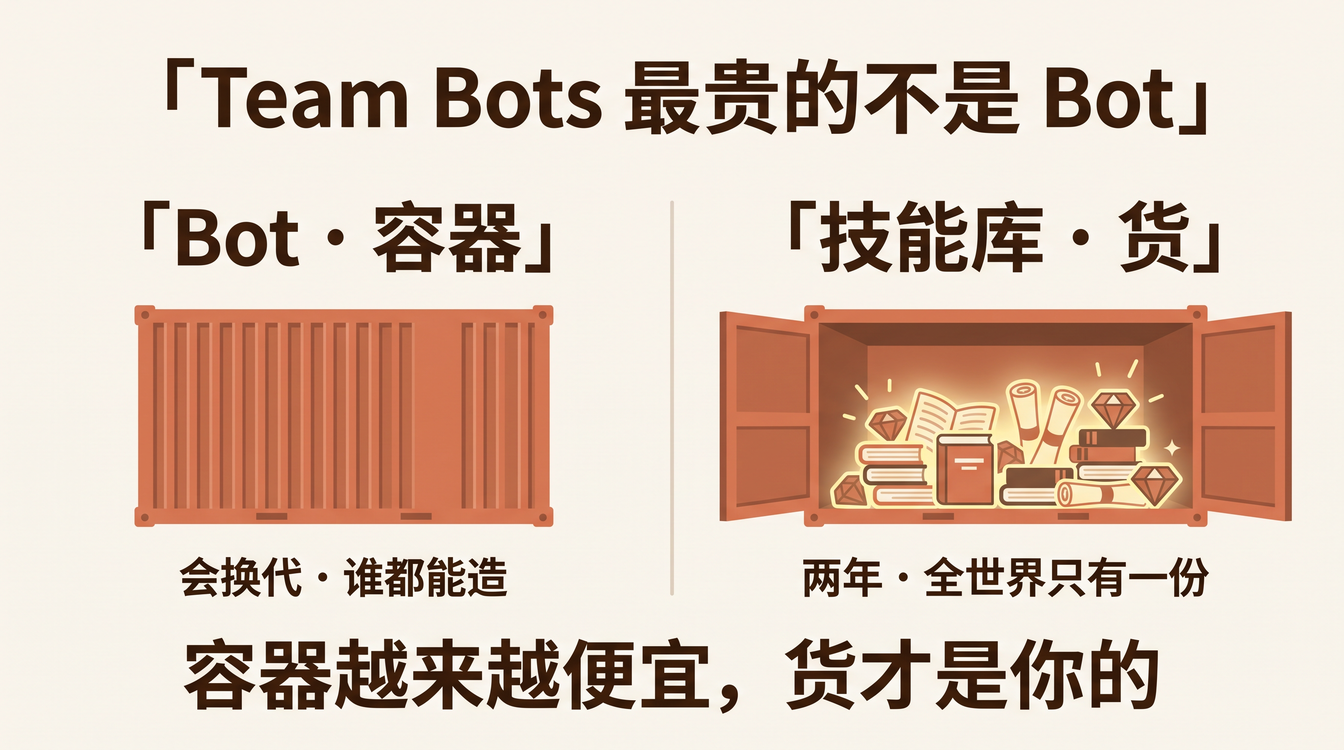
因为它暴露了这门生意真正的定价结构:xAI 卖的是容器,客户装进去的才是货。
一、拆开 Team Bots:哪些是容器,哪些是货
Team Bots 的内核是四件套。按「这东西归谁」拆开看:
| 组件 | 是什么 | 归谁 |
|---|---|---|
| Context | 文件、指令、技能——品牌指南、内部文档、团队流程 | 客户的货 |
| Plugins | 连进 Salesforce、Notion、GitHub 的能力,可按人配置或按团队统一配置 | 接口(xAI 修路,客户的路) |
| Credentials | 安全访问没有现成插件的第三方 API | 客户的钥匙 |
| Memory | Bot 在岗位上越干越顺的那部分学习 | 客户的货 |
四件里,真正属于 xAI 的只有承载这四件的运行时和底下的 Grok 模型。而模型换得有多快?Grok 4.7 上线才一周多,马斯克已经宣布 4.8 本周完成训练。发布材料的叙事也顺着这个现实走:Bot 围绕团队的角色和工作流长出来,模型只是它当前用的那颗脑子。
这就是我说的定价结构:容器和发动机是 xAI 的,货是客户的。 Bot 是集装箱,模型是船,技能库、凭证、记忆才是箱子里的东西。船会换代,集装箱标准化了谁都能造,但箱子里那批货——那个数据团队两年的 4.5 万张表——全世界只有一份。
这里得给「货是你的」补一个诚实的前提:货能不能从集装箱里搬走。 如果技能库的格式锁死在 xAI 的运行时里、导不出也迁不走,那这批货名义上归你、实际上扣在对方的仓库里——这就是 vendor lock-in,「货是你的」要打折扣。所以一个组织在往容器里装货之前,真正该问的不是「这个 Bot 好不好用」,是「哪天换船了,我的货搬不搬得动」。技能是 Markdown 这类开放文本、凭证走标准协议、记忆能导出——货才是真货;否则你攒的不是资产,是别人仓库里的寄存品。这是我替读者补的一问,发布稿并没回答:Team Bots 的技能、记忆能不能整体导出迁走,xAI 没说(AlphaSignal 的评测也点到,共享学习的删除、保留、回滚这些控制「均不明确」)。但它恰恰是「货归谁」这个问题的命门。
有意思的是,同一周发布 Manus 2.0 的那家,反倒把这件事写进了卖点——它的 Skills 从今年年初起就强调「便于在兼容开放标准的产品之间迁移」。同样在做团队 Agent,一家把「货搬得走」当承诺亮出来,一家对此沉默。沉默本身就是半个答案:当一个产品不愿谈迁出,它谈的就不是帮你存货,是帮你把货存进它的仓库。
我在 Grok Bot 能当队友,还当不了员工 里写过,Grok Bot 的 Templates「分享的是菜谱,不是那盘已经做好的菜」。Team Bots 是这句话的团队版,而且把「菜谱」这个比喻推到了实处:菜谱(技能)可以共享、可以传承、可以越改越好;厨师(模型)随时可以换人。一个组织真正的厨艺,从来不在厨师手里,在菜谱和那口用了多年的锅里。
二、两年的技能库,是隐性知识的资产化
「4.5 万张表的技能库」听起来像是 4.5 万份文档。不是。拆开看,这套技能库里沉淀的是三类东西,每一类都是老分析师脑子里的隐性知识:
第一类:找对数据。 4.5 万张表里,哪张是权威口径、哪张是废弃的、哪两张名字像但口径差一个时区——这是每个数据团队最贵的经验,通常住在两三个老员工的脑子里,以「你去问 XX」的形式传承。写进技能库,它就变成了可执行的资产:Bot 直接找对表,新人不用再排队问人。
第二类:分析的套路。 「怎么分析欺诈功能的使用」不是一条 SQL,是一套流程——先看哪些信号、怎么排除误报、结论用什么图表呈现、哪些边界情况要单独标注。这是方法论层面的 know-how。
第三类:不许做的事。 图表规范、安全更新全公司仪表盘的说明——这些是护栏。技能库里最值钱的往往不是「怎么做」,是「什么情况下必须停下来」。我在 321 字节和 5 万字节:两个 Skill 的长度都没错 里给过判据:每条规则的底下都压着一次真实的翻车。 两年的技能库,就是两年的翻车记录压缩成的防御工事。
把三类合起来看,这个数据团队干的其实是一件事:把「资深分析师」这个岗位,编译成了一份 Bot 可以执行的合同。 这正好是 一切皆员工 里那套「一个员工 = 一份 SPEC 编译出的一个 profile」的外部同构——只不过 xAI 的版本里,SPEC 叫 skills,profile 叫 Team Bot。
而发布稿里还有一句话,说明这份资产是活的:「Bot 会记住对它查询的更正,从一个人身上学到的,改善它给所有人的答案。」一个人发现 Bot 用错了口径,纠正一次,全公司的人从此都得到对的答案。隐性知识的资产化,加上更正的共享化——这是技能库区别于文档库的全部。 文档库是死的:写完就开始过期,没人负责改。技能库是活的:每一次使用都在给它投票,每一次更正都在给它施肥。
三、「能被写下来的」,为什么没有贬值
写到这里,必须处理一个我自己设下的障碍。上周我在 能被写下来的,都在贬值 里立过一个判据:凡是能被写成文本的东西,原则上都在「事实的总和」里,都能进语料,都能被蒸馏——不可蒸馏的才是资产。
技能库不就是写下来的文本吗?按这个判据,它不是正在贬值吗?这篇是不是在打那篇的脸?
不打。把 #416 的蒸馏测试原样搬过来跑一遍就清楚了。测试是:把它完整写成一份文档,交给一个足够强的模型,它能复现你的价值吗?
现在把那份 4.5 万张表的技能库完整拷贝给另一家公司——文本一个字不少。会发生什么?满纸的指针,全部悬空。 「查退款率用 dwd_trade_refund_di 这张表,注意它和 dwd_trade_refund_df 的口径差一个时区」——对方没有这张表;「更新仪表盘 X 之前必须先跟数据 owner 确认」——对方没有这个 owner,也没有这块仪表盘;「欺诈分析的第三步要排除测试账号,测试账号名单在 Y 系统里」——对方连 Y 系统是什么都不知道。
技能库的文本是 指针,指针指向的是这家公司私有的数据、流程、决策历史。指针可以复制,指向物复制不了。所以蒸馏测试在这里的结果是:蒸走了文本,蒸不走价值——因为价值不在文本里,在文本与组织的绑定里。
这给 #416 的判据补了一个精确化:「能被写下来的都在贬值」,贬的是 通用知识——「怎么写 SQL」「怎么画柱状图」这类写进任何语料都成立的东西,模型每强一代就吞掉一层。不贬的是 私有绑定——写下来也只在你的组织里成立的东西。同一份文本,两重身份:
            一份技能库 = 两层
┌──────────────────────────────────────────┐
│  文本层(怎么写)   可复制、可蒸馏          │
│   · 怎么查 SQL、怎么画图、怎么做归因        │
│   · 通用部分正被模型逐层吃掉 → 贬值         │
├──────────────────────────────────────────┤
│  绑定层(指向什么)  不可复制、不可蒸馏      │
│   · 4.5 万张表的私有 schema                │
│   · 哪个口径对、哪块仪表盘能动、谁必须确认   │
│   · 每天几十次真实查询的更正流              │
│   · 不在「事实的总和」里 → 升值             │
└──────────────────────────────────────────┘
把文本层单独拷给别人 = 一堆悬空的指针:
指针复制得了,指向的私有世界复制不了。
# generated by hugo AI
所以「最贵的不是 Bot,是技能库」这句话还要再拧紧一圈:最贵的也不是技能库的文本,是文本底下那层活的绑定。 两年,不是在写 4.5 万份文档的时间,是让这层绑定长出来的时间。
四、活的技能库,和它的治理缺口
「从一个人身上学到的,改善它给所有人的答案」——这句发布稿里的话,是全文我最想圈出来的一句,也是我最不放心的一句。
想圈出来,是因为它把技能库从「文档」升级成了「流」。对照我刚在 数万名员工,是一块活的评测集 里写的框架:Meta 的数万名员工每天产生轨迹,轨迹提炼成 case,case 回流进产品——Data Bot 的更正流是同一条管道的小规模版本:真实查询产生更正,更正回流进技能,技能改善下一次查询。评测集是活的,技能库也必须是活的;死的技能库和死的题库是同一种死法。
不放心,是因为这条管道有个没人回答的问题:更正进共享层之前,谁签字?
一个人纠正了 Bot 的口径,这个更正从此影响全公司所有人拿到的答案。如果他纠正错了呢?如果他的部门口径和公司口径本来就不一致呢?AlphaSignal 对 Team Bots 的评测里点到了同一处:共享学习的「提升、审查、删除、保留和回滚控制均不明确」。发布稿把「一人学会、全员受益」当卖点讲,但按我在 评测集是一份没人签字的文件 里立的标准,没有裁决点的共享学习,是把一个人的错误放大成全组织的事实。
同样是「Agent 从使用中学」,Manus 给了一个反例:它的「Projects 从任务中学习」把学到的东西以指令、文件或技能的形式 提出更新建议,「经用户批准后生效」——签字点直接建进了产品。一边把更正默默并进共享层,一边把更正变成待批准的提案;差别不在学不学,在学完之后谁点头。
这就是 #424 那句话在技能库上的重演:case 的来源要活,case 的主人要钉死。技能库同理——更正的来源要活(谁都可以纠),更正的主人要钉死(进共享层要有人签字)。 两年的技能库之所以是资产,不只是因为它攒得多,更因为每一条都经过了那个数据团队的裁决;哪天它变成一条谁都能写、没人负责的共享流,它就从资产退化成噪音。
五、模型会吃掉技能库吗
最后一个反方,也是老反方:模型每强一代,就吞掉一层技能。今天的 Bot 要教它「怎么找对表」,明天的模型自己就会探索 schema;今天要教它图表规范,明天它审美比你好。技能库会不会也是过渡产物——两年攒的东西,被下一代模型一夜清零?
会吃掉一半。被吃掉的是能力层:写 SQL、画图表、做归因分析,这些「怎么做」的技能,模型确实在一层层内置——模型正在吞噬 Agent 框架 的规律在技能库上同样成立。
吃不掉的是事实层:哪张表是权威的、哪个口径是对的、哪块仪表盘能动、谁的确认是必须的。 这些不是能力,是你公司的私有事实——它们不在任何公开语料里,模型再强也只是「没见过你公司的世界」。事实层的技能有个特点:模型越强,它反而越值钱,因为强模型拿着对的事实能干出更大的活,拿着错的事实也能造成更大的破坏。
所以两年技能库的正确读法是分层折旧:里面「怎么做」的部分在快速贬值,该让模型吞的让它吞,别心疼;「是什么、归谁管、什么不能碰」的部分在持续升值,而且只有天天用它的人才能把它养对。把技能库当文档写的团队在攒贬值资产,把技能库当闭环养的团队在攒升值资产——同样的两年,两种命运。
结尾:你组织的「4.5 万张表」在哪里
回到开头那个画面。xAI 发布稿里最响的数字是「100 多个 PR」「12 万美元」,但真正决定这家公司能不能用好 Team Bots 的,是那个最安静的数字:两年,4.5 万张表。
容器会越来越便宜——这是 xAI 们的生意,他们巴不得容器免费。模型会越来越强——这是实验室的生意,跟你没商量。唯独货是你的:你组织里那些「去问 XX」的传承、那些踩过的坑、那些不许碰的线,它们今天住在哪里?
三种住法,三种命运:住在老员工脑子里,人走了就没了;住在文档库里,写完就开始过期,没人负责改;住在一条 Bot 每天真实执行、每天被人更正、更正有人签字的闭环里——只有第三种是资产,前两种都是遗产。
你的组织里,最贵的那份「技能库」现在几岁,谁在养它?欢迎留言聊聊。
事实核对自:xAI Team Bots 官方发布(2026-09-28,@bot 推文)及 AlphaSignal、WindowsForum、TeslaNorth 等多源交叉——四件套(Context/Plugins/Credentials/Memory)、共享 Bot/私密会话、Slack 句柄、五人团队 100+ PR/天(reportedly)均一致;Data Bot 两年/4.5 万张表、Harper 保险 24 小时/12 万美元、更正共享机制出自发布材料口径(经 AIbase 日报转述),未独立核实,引用时已标注;Grok 4.7 上线(9/21)与 4.8 训练节点出自 AIbase 日报关联报道(马斯克 X 帖转述);AlphaSignal 对共享学习治理(promotion/review/deletion/rollback)不明确的批评见其评测原文;Manus Skills「便于在兼容开放标准的产品之间迁移」(2026-01-27)与「Projects 从任务中学习·经用户批准后生效」(2026-05-06)出自 Manus 官方博客自整理时间线(经「十字路口」公众号转述)。