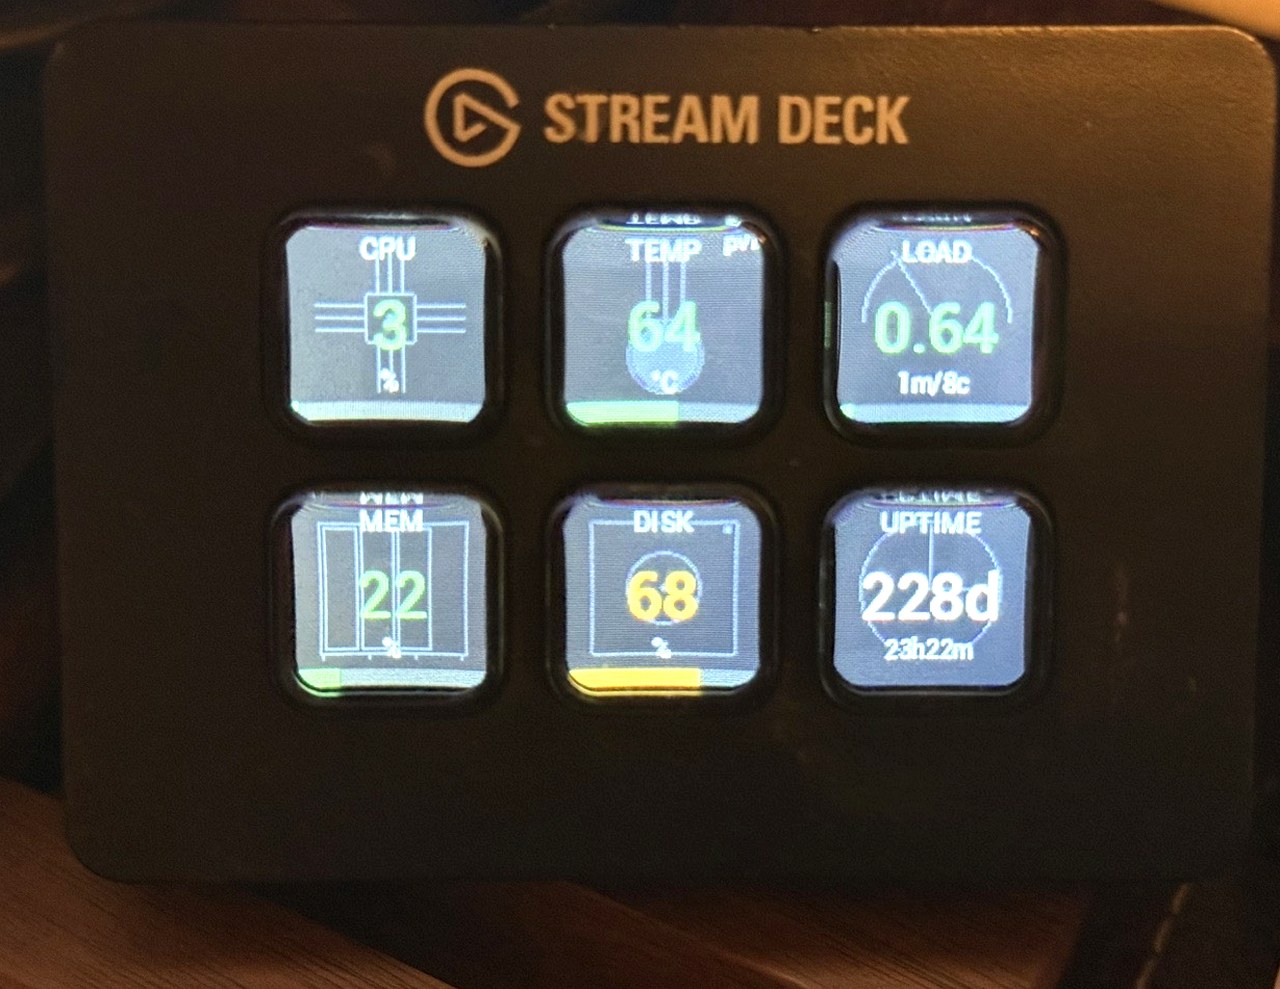
我在这台 8 核 ARM 小主机上挂了一块 Stream Deck Mini,当常驻系统监控面板:6 个按键,实时显示 CPU、内存、温度、磁盘,翻页键切到每核占用,长按熄屏。它已经默默跑了很久。
直到某天我 top 了一下。排在最前面的不是哪个服务,而是它自己——python 进程占着约 3% 的 CPU,比它监控的大部分服务都费电。
一个监控工具,把自己变成了最该被监控的对象。
这篇讲我怎么把它的空闲占用压到 0.4%,而且按键 反而更跟手了。中间踩了一个坑:在 SDK 里把「非阻塞读」改成「阻塞读」会死锁。这个坑值得单独讲,因为它不只属于 Stream Deck——任何「轮询 → 事件驱动」的改造都会遇到。
一、它在「画」,还是在「看」?
先做归因。把进程按线程拆开看 CPU,会发现两个来源:
- 渲染:每次刷新把变化的按键重新编码成未压缩 BMP,通过 USB 写下去。Mini 一个按键约 19 KB、要走约 20 次 USB 写,6 个键全变就是一次可观的 USB 流量;
- 输入:一个后台线程以固定频率问设备「有按键吗」。15Hz 就是每秒 15 次,30Hz 就是 30 次,永远不停。
那段时间我刚做过一轮渲染优化:只重绘真正变化的按键(进度条按像素量化)、背景和图标缓存、温度改直读 sysfs(一次采样从 44ms 降到 2ms)。空闲占用从最初的约 3% 降到了约 1.9%。
但剩下的 1.9% 里,大头是那个永不停歇的输入轮询。
这解释了一个反直觉的现象:那块设备 99.9% 的时间都不会有按键事件。也就是说,每秒 15~30 次轮询里,绝大多数得到的回答是「没有」。我们在为「什么都没发生」付 CPU。
监控类常驻程序的成本,往往不在「看一眼」,而在「不停地看」。
二、第一反应是调低频率——但这是治标
最直觉的省法是把轮询频率降下来。我实测过每一档(同一台机器、无按键空闲):
| 空闲轮询频率 | 额外 CPU |
|---|---|
| 30 Hz | ~0.5% |
| 15 Hz | ~0.3% |
| 5 Hz | ~0.13% |
代价是延迟。读取线程每 1/poll-hz 秒采样一次;如果一次「按下 + 松开」整段都落在两次采样之间,这次轻点就 完全丢失。右下角翻页键用的是短按,低频下就表现为「翻页键不灵 / 只有长按熄屏有反应」——因为长按持续时间长、总会被采到,于是看起来像「和长按冲突」。
一旦你把频率降到 10Hz 以下,就会开始漏掉正常轻点。这本质是把 CPU 换成可靠性,交易并不划算。
真正的问题不是「轮询太快」,而是「根本不该轮询」。
轮询(Poll):  线程 ──每 66ms──▶ 问一次「有按键吗?」──▶ 没有,睡 66ms
                       │
                       └─ 99.9% 的唤醒都扑空,但设备只在变化时才有数据

阻塞(Block): 线程 ──hid_read_timeout()──▶ 睡在 USB 内核传输里
                       │
                       └─ 设备一有变化,内核立刻唤醒它:零轮询、零等待
# generated by hugo AI
设备只在按键变化时才上报——这意味着我们 不需要 问,只需要 等。等,就是阻塞读。
三、第二个反直觉:更跟手,反而更省 CPU
把「每 66ms 问一次」换成「睡到有事件为止」,同时得到两个好处:
- CPU:空闲时线程睡在内核的 USB 中断传输里,不消耗 CPU;
- 延迟:一次轻点在按下的一瞬间就被内核唤醒处理,不用等下一个采样窗口。
省 CPU 和低延迟,在这里不是取舍,而是一起变好。真正被牺牲的,是「框架的简单性」——这也就是下一节要讲的坑。
四、最深的坑:在 SDK 里阻塞读会死锁
我一开始想得很简单:SDK 里那个 read 用的是非阻塞 hid_read,我在外面循环调用、加个 sleep,不就是轮询吗?那我把它换成阻塞的 hid_read(无超时)不就行了?
答案是不行。Stream Deck 的 Python SDK 里,读和写共用同一把锁:
class Device(Transport.Device):
    def read(self, length: int) -> bytes | None:
        """Performs a read of a HID In report from an open HID device."""
        with self.mutex:                          # 与 write 共用同一把锁
            return self.hidapi.read(self.device_handle, length)

    def write(self, payload: bytes) -> int:
        """Writes a HID Out report to an open HID device."""
        with self.mutex:                          # 同一把锁
            return self.hidapi.write(self.device_handle, payload)
# generated by hugo AI
而且更底层还有一把类级别的锁:Library.read() 在调用 hid_read 时也持有 Library.mutex。
如果我在这条路径上做 无超时 的阻塞读,会同时出两件事:
- 读取线程抱着
Device.mutex不放 → 主线程想写画面时卡死,屏幕不再更新; - 退出时 SDK 的
_setup_reader(None)会join()读取线程 → 但读取线程正阻塞在hid_read里,永远不会返回 → 进程挂住,只能kill -9。
所以「把 SDK 的读改阻塞」是死路。正确的做法是 绕过这两把锁,直接对 HID 句柄做带超时的阻塞读。
五、改造三问
这次踩坑之后,我总结成一个可复用的检查清单。凡是把「轮询」改成「事件驱动阻塞等待」的改造(HID、串口、socket、GPIO、轮询文件),动手前都先问三件事:
| 问题 | 为什么致命 | 本例答案 |
|---|---|---|
| ① 设备是不是 事件驱动 的? | 如果设备不会主动上报(只能轮询状态寄存器),阻塞会永远等不到 | 是。只在按键变化时上报,可阻塞 |
| ② 读路径是否与写 共享锁? | 共享锁下阻塞读会拖死写操作,甚至死锁 | 是。Device.mutex / Library.mutex,必须绕开 |
| ③ 阻塞调用是否 可中断? | 无超时的阻塞会让退出 / 取消永远挂起 | 用 hid_read_timeout,超时只作收尾,不是采样周期 |
三问里只要有一个「否」,就别急着改——先把条件补齐(换传输、拆锁、加超时)。顺序很关键:先确认能不能,再动手改。这和我之前在 AI 干完了 8 成的活,我才发现需求提错了 里学到的教训一样——动手前先把问题定义清楚,比事后返工便宜得多。
六、实现:把读循环接到自己手里
改造的目标是把输入从 SDK 手里接过来,其余逻辑一行不改。核心就是直接拿 device_handle,绕开 SDK 的锁,用带超时的 hid_read_timeout:
import ctypes
import threading
from typing import TYPE_CHECKING, Callable

if TYPE_CHECKING:
    from StreamDeck.Devices.StreamDeck import StreamDeck

READER_TIMEOUT_MS = 250  # 仅用于退出时能醒来,不是采样周期


class BlockingReader:
    """Reads HID reports with hid_read_timeout, bypassing the SDK's mutexes.

    The SDK calls hid_read while holding Device.mutex and Library.mutex, so a
    blocking read there would stall image writes and deadlock shutdown. We read
    the raw handle directly instead: the device only raises a report on a key
    change, so the thread sleeps in the kernel while idle (~0 CPU).
    """

    def __init__(
        self, deck: "StreamDeck", on_key: Callable, log: Callable[[str], None]
    ) -> None:
        self._deck = deck
        self._on_key = on_key
        self._log = log
        self._stop = threading.Event()
        self._thread: threading.Thread | None = None

    def start(self) -> bool:
        """Takes over the reader; returns False if the transport can't do it."""
        device = self._deck.device
        library = getattr(device, "hidapi", None)
        handle = getattr(device, "device_handle", None)
        hidapi = getattr(library, "hidapi", None)
        if handle is None or hidapi is None or not hasattr(hidapi, "hid_read_timeout"):
            return False

        hidapi.hid_read_timeout.argtypes = [
            ctypes.c_void_p,
            ctypes.POINTER(ctypes.c_char),
            ctypes.c_size_t,
            ctypes.c_int,
        ]
        hidapi.hid_read_timeout.restype = ctypes.c_int
        self._library, self._handle = hidapi, handle

        # Stop the SDK poller only AFTER we know we can replace it, so the
        # polling fallback still works if this transport is unsupported.
        self._deck._setup_reader(None)
        self._thread = threading.Thread(target=self._loop, name="sd-reader", daemon=True)
        self._thread.start()
        return True

    def _loop(self) -> None:
        """Block on the handle until a key changes, then dispatch it."""
        key_count = self._deck.key_count()
        buffer = ctypes.create_string_buffer(1 + key_count)
        # Seed from the state the SDK poller last saw, so a key held across the
        # hand-over is still tracked and its release is delivered.
        last = list(self._deck.key_states()[:key_count])

        while not self._stop.is_set():
            result = self._library.hid_read_timeout(
                self._handle, buffer, len(buffer), READER_TIMEOUT_MS
            )
            if self._stop.is_set() or result < 0:
                break
            if result == 0:
                continue
            raw = buffer.raw[:result]
            for key in range(min(key_count, len(raw) - 1)):
                pressed = bool(raw[1 + key])
                if pressed == last[key]:
                    continue
                last[key] = pressed
                self._deck.last_key_states[key] = pressed  # keep SDK-side checks consistent
                self._on_key(self._deck, key, pressed)

    def stop(self) -> None:
        """Wake the blocking read with a timeout and join the thread."""
        self._stop.set()
        if self._thread is not None:
            self._thread.join(timeout=READER_TIMEOUT_MS / 1000.0 + 1.0)
# generated by hugo AI
有几个细节是「踩过才知道」的:
- 超时不是采样周期。250ms 超时只在退出时让线程醒来一次;空闲时它一直睡在内核里等,不产生轮询成本。有人会反驳「带超时的阻塞读还是轮询」——区别在于:轮询是没事也要主动去查设备,而超时是设备没事时内核让你睡着,超时只是兜底退出。
- 绕开锁,就要接受读写并发。框架加锁是为了状态一致,但 HID 的读走中断 IN 端点、写走 OUT 端点,本身不是同一份状态,加锁更多是为了省心。我在本机实测:读取线程长时间阻塞期间,主线程持续写画面无任何异常。前提是传输后端确实支持这一点——对不确定的后端,就用
--no-blocking-read回退。 - 要镜像键状态。SDK 的长按判定、熄屏记账都在读
last_key_states。你接管了读之后,必须同步维护它,否则手势逻辑会失忆。 - 要在启动时播种初始状态。如果你接管时某个键正被按住,直接开始读会把它当成「新按下」或漏掉它的松开。用切换前
key_states()的快照做基线。 - 要保留回退。我给命令行加了
--no-blocking-read:遇到不支持的传输后端或异常设备,就退回原来的轮询实现。改造不能把原有的可靠性一夜清零。
手势逻辑(短按翻页、长按熄屏、唤醒冷却、幽灵键过滤)全部留在原来的 _on_key 里,改造只换了「谁来读取、怎么读取」。这也是它能稳定上线的原因——只动数据来源,不动业务判断。
七、实测:同机对比
方法:在同一台 8 核 ARM 主机上,读取 /proc/<pid>/task/*/stat 逐线程累计 CPU 时间,跑 25 秒取平均,两次测量期间都不碰设备。
| 配置 | 空闲 CPU |
|---|---|
最初版本(全量重绘 + psutil 取温度,--interval 1 --poll-hz 30) | ~3% |
渲染优化后(只重绘变化 + sysfs 温度,--interval 1 --poll-hz 30) | ~1.85% |
--interval 1 --poll-hz 20 | ~1.55% |
--interval 2 --poll-hz 20 | ~1.20% |
--interval 5 + 15Hz 轮询(--no-blocking-read) | ~0.64% |
默认:--interval 5 + 阻塞读 | ~0.44% |
同样 5 秒的刷新间隔,阻塞读比 15Hz 轮询又省了约三分之一的空闲 CPU,而且按键是「立即」而不是「最多等 66ms」。
这些数字是 我这一台 ARM 小主机的实测,不是普适基准;换成 x86 或别的 HID 设备,绝对值会变,但「消除周期轮询」带来的量级差异应当是一致的。
最后
这次改造真正的收获,不是那个 0.44% 的数字,而是一个更一般的判断:
给常驻程序省 CPU,先别问「哪个参数能调小」,先问「它凭什么一直在醒着」。
轮询、心跳、定时刷新、Agent 的定时循环——它们的成本不在单次执行有多重,而在 唤醒次数 本身。把「每隔 N 秒主动问一次」换成「等事件发生再醒」,往往能同时拿到更低占用和更快响应。
但在动手之前,请先过一遍「改造三问」:设备是否事件驱动、读路径是否与写共享锁、阻塞调用是否可中断。我在 Stream Deck 上差点因为第二问栽进去——在 SDK 里改阻塞读,会死锁。
我在 StreamPi - 低成本快速响应系统监控工具 里第一次把 Stream Deck 用作监控面板;这次是在它的基础上,把「输入循环」这一层重新做了一遍。如果你也在用常驻小硬件跑服务,299 美金的个人知识库开发板 那篇里「常驻不关机」的成本账,其实和这里的空闲 CPU 是同一笔账。
你手上有没有那种「跑了很久、从没人看过它到底占多少 CPU」的常驻脚本?欢迎留言,我们算算它一年醒了几亿次。