我把自己写过的两篇长文丢进 inbox,然后让一块边缘 AI 板子慢慢嚼。21.7 分钟后,它交出 72 条论断、38 个实体、60 条关系,全部落进一个 SQLite 文件。整个过程没有联网,数据一寸都没离开那块板子。
板子上跑的是一个 4B 的本地模型。我拿它做的事,是给个人知识库当编译器:把非结构化的资料,持续编译成人和 Agent 都能直接用的 Context。同一套代码,我也接上云端的前沿模型跑了一遍做对照——两边跑完,结论有点出乎我的意料:慢 2.6 倍的那一边,质量只差一档;而它换来的是零成本、离线、数据不出板。
当 Muse 们把助理跑在云上,你的数据该放在哪里?
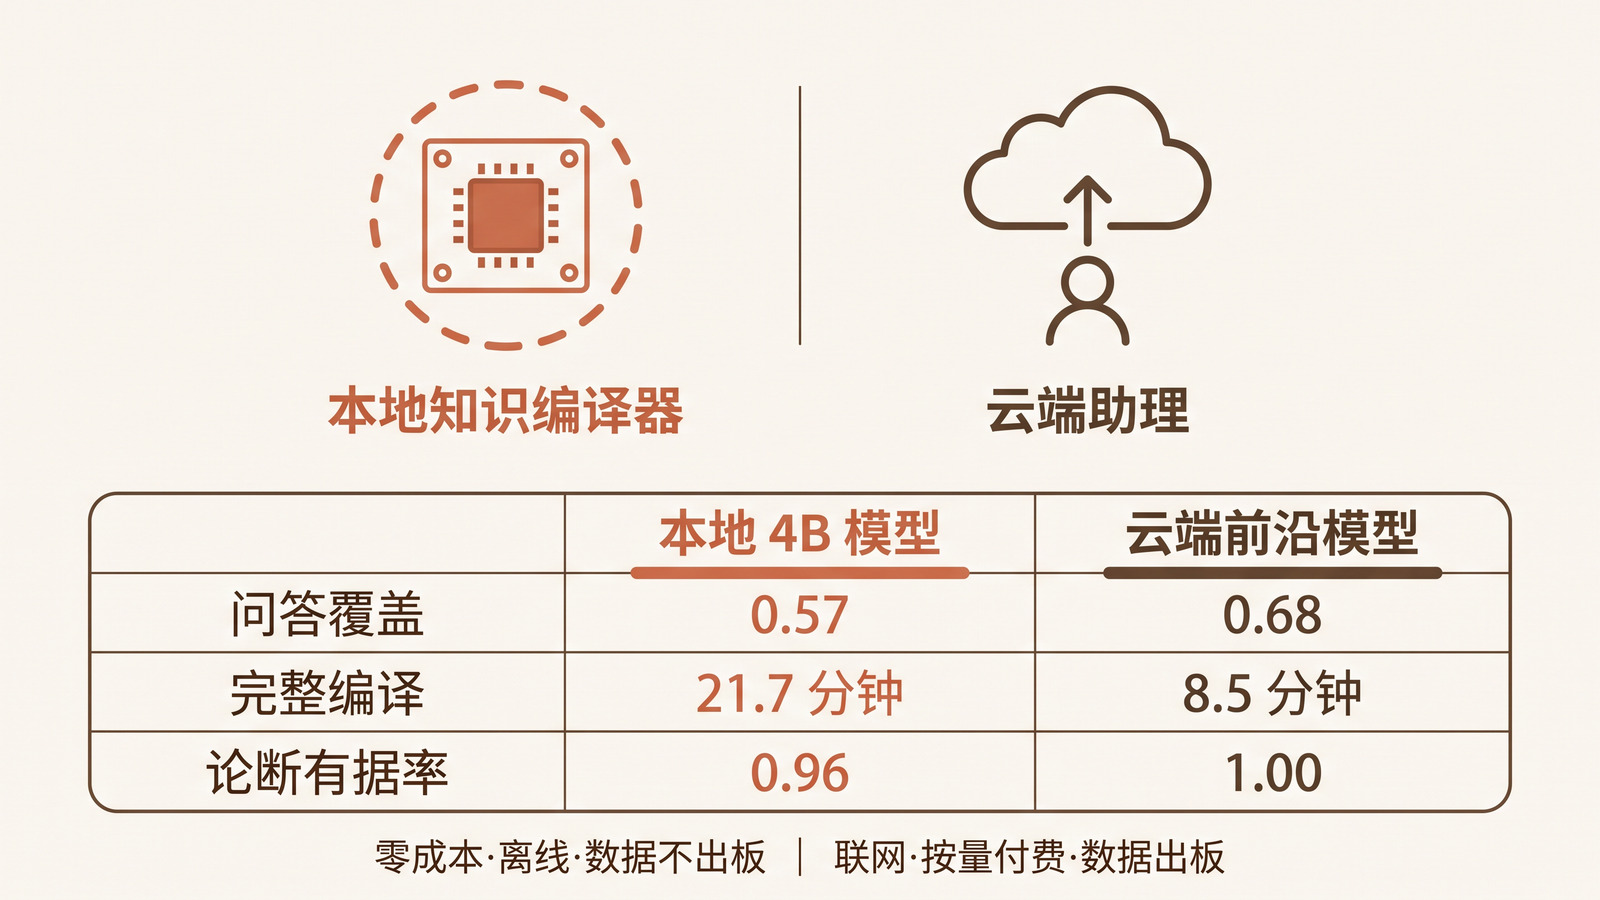
本地 4B 与云端前沿模型的三项对照:指标只差一档,代价却完全不对称——右列的每一分领先,都要用联网、按量付费和数据出板来换
一、Muse 很火,但火的方向有点让人不安
9 月 8 日,Meta 发布了个人 AI Agent Muse:能收发邮件、订机票、网购、管日程,几天内冲上美区 App Store 榜首,随后登陆 Mac。它背后是一整套云端架构——每个用户一个专属云虚拟机,模型是 Meta 的 Muse Spark。OpenAI 随即用 Dots 应战,Instinct 等新玩家也在猛冲融资。
热度之下,争议也在发酵:有用户发现 Muse 读取了自己没有授权的消息,有人被它在 Facebook Marketplace 上泄露了地址。更现实的是企业侧——「数据不出域」是硬约束,把邮件、日历、聊天记录交给云端 Agent,很多公司根本过不了合规那关。
于是形成了一个清晰的空档:云助理把能力做到了极致,但「数据留在自己盒子里」的版本,迟早会有人做。 我的判断是:带本地算力的「硬」桌面个人助理一定会出现,并且会流行。
问题是:本地算力够吗?我手里正好有一块 299 美金的 Arduino VENTUNO Q(Qualcomm Dragonwing IQ8,Hexagon NPU 40 TOPS,16GB 内存,跑 Ubuntu 24.04),于是拿它做了一个实测。
二、先想清楚:个人知识库不是 Wiki,而是「知识编译器」
很多人的第一反应是「做个 Wiki、装个笔记软件」。但那是上一代的思路——它要求你 在输入时就决定东西该放哪:这篇放哪个标签?那份归哪个目录?
我的设计目标不是 Wiki,而是一台 Knowledge Compiler(知识编译器):任何东西丢进 Inbox,系统自己解析、切块、抽取、建关联,最终生产出可以直接喂给 Agent 的 Context。它不是「存资料」,而是持续把「非结构化的世界」编译成「结构化的、可执行的知识」。
支撑它的是一组我认为不能妥协的原则:
- Inbox first:低摩擦入口。你只决定「值不值得进系统」,分类交给编译器。
- Raw immutable:原始资料永远保留、只读。AI 理解错了可以重编译,但不能污染源头。
- CPU first, LLM second:解析、切块、哈希、索引这些确定性工作交给程序,只有 语义抽取 才动用模型。
- Claim over Chunk:这是最关键的一条。管理的不是「我读过什么」,而是「我知道什么」——可独立理解的事实、观点、假设。
- Source always attached:每条知识都能一路追到原文段落。AI 可以总结,但 绝不能让来源消失。
- Knowledge ≠ Memory:稳定知识与个人动态状态(当前项目、偏好、待办)分开存放,后者可过期。
- Incremental compilation:按内容哈希只编译增量,知识库越大越要能持续增量演进。
- Hybrid retrieval:FTS + 向量 + 实体三路召回,缺一不可——不要迷信单一向量库。
- Don’t overbuild the graph:先用 SQLite,真实需求出现再上图数据库。
- KB produces Context:知识库的终点不是「搜索」,而是 为人和 Agent 持续生产高质量上下文。
前四条决定了知识「进得来、追得回、抽得准」;后六条决定了它「用得动、不塌缩、越用越值钱」。一句话:个人知识库不是备忘录,而是一台机器——它把信息编译成你的 Context。
三、工程实践:一台能跑起来的知识编译器
我把它实现成了开源项目 knowledge-compiler(https://github.com/hugozhu/knowledge-compiler),并让它跑在这块板子上:
inbox → parse → chunk → 本地 4B 模型抽取 → SQLite + FTS5
      → search / ask / context → 喂给人和 Agent
- 本地模型用 Qwen3-4B(w4a16),全程走 NPU,约 16 tok/s,整个项目 零第三方依赖;
- 支持 Markdown / 纯文本 / HTML / PDF / 图片 OCR,原始文件只读,按内容哈希增量编译;
- 在抽取之上还做了判重(重复/更新/矛盾/全新)、实体归并、知识演化链、日报周报;
- 对外提供 Web API 与 MCP,OpenCode 里的 Agent 可以直接调用
context / search / ask / note——知识库因此成为 Agent 的「长期记忆」。
复杂推理交给云端,确定性工作与个人数据留在本地:这就是它坚持的 Local First, Cloud When Needed。
四、实测:299 美金的板子,够不够?
光「能跑」没意义,我做了对照实验。用两篇 2026 的长文做语料,跑了三组编译:
| 组 | 模型 | 说明 |
|---|---|---|
| C1 | 本地 Qwen3-4B(NPU) | 被测对象 |
| C2 | deepseek-v4-flash(云) | 同一套代码,只换模型 |
| C3 | flash 整篇抽取 | 质量天花板 |
结果(对照天花板):
| 指标 | 本地 4B | flash |
|---|---|---|
| 论断召回 | 0.43 | 0.48 |
| 实体 F1 | 0.67 | 0.84 |
| 论断有据率 | 0.96 | 1.00 |
| 完整编译耗时 | 21.7 分钟 | 8.5 分钟 |
| 问答要点覆盖 | 0.57 | 0.68 |
在 14 道真实场景题(检索 / 问答 / 跨文档 / 负样本)上,本地 4B 的问答要点覆盖 0.57、云端 flash 0.68、把原文直接喂给 flash 则是 0.95;三组在「负样本」上都正确拒答,没有明显幻觉污染。
三个关键发现:
- 本地 4B 比想象中能打:论断召回只差 0.05,有据率 0.96——它极少编造,只是会漏。
- 瓶颈不在模型,在管线:两者的论断召回都只有 0.4–0.5,因为 2000 字分批 + 合并上限把细节截掉了;换更大的模型也救不回来,得改管线与检索。
- 成本与隐私的天平:flash 快 2.6 倍,但要联网、数据出板、按量付费;本地 4B 是 $0、离线、数据不出板。
五、结论
够用。 对「常驻个人知识节点」这个场景,299 美金的板子能撑起知识编译、检索和日常问答;复杂长文推理再交给云端——这正是 Local First 的意义。
完整代码、对照实验脚本与数据都在这里: https://github.com/hugozhu/knowledge-compiler
Muse 代表的是「能力上云」的极致效率;而下一波一定会有人做「数据留本地」的对照版本。这块 40 TOPS 的板子告诉我:这一天,可能比想象中来得更快。
附录 A:语料原文
本文的编译与评测基于我自己的两篇长文(均发布于 hugozhu.site):
- 《Agent = Model + Harness:从 Anthropic Managed Agents 看 Agent 架构演进》(下称「文章一」,约 1.6 万字)
- 《Loop Engineering:AI Agent 工程的第五层》(下称「文章二」,约 0.7 万字;正文引用了文章一,因此能测跨文档综合)
附录 B:评测集(14 题)
评测集覆盖精确检索、语义检索、实体、跨文档综合、事实、多跳、Context Builder 与负样本(防幻觉)八类。每题都带 期望命中文档 与 参考答案要点,完整机器可读版(含 expected_facts / gold_answer)见仓库。
| # | 类别 | 问题 | 期望命中 |
|---|---|---|---|
| S01 | 精确检索 | Codex 的 /goal 有哪五个状态? | 文章二 |
| S02 | 精确检索 | Anthropic Managed Agents 解耦后的三个核心接口是什么? | 文章一 |
| S03 | 语义检索 | 为什么针对旧模型写的 workaround 最终会变成死代码? | 文章一 |
| S04 | 语义检索 | Agent 长时间自主运行会出现哪两个致命问题? | 文章二 |
| S05 | 实体 | 设计 Agent Harness 的五个原则是什么? | 文章一 |
| S06 | 实体 | Ralph Loop 的核心观点是谁提出的?原话大意是什么? | 文章二 |
| S07 | 跨文档 | Loop Engineering 和 Harness Engineering 是什么关系? | 文章一 + 文章二 |
| S08 | 跨文档 | Agent = Model + Harness 公式与 Loop Engineering 如何互相补充? | 文章一 + 文章二 |
| S09 | 事实 | 解耦 Harness 和 Sandbox 后,TTFT 指标改善了多少? | 文章一 |
| S10 | 事实 | 钉钉差旅报销 Loop 案例的投入产出比是多少? | 文章二 |
| S11 | 多跳 | Codex 用什么机制防止 proxy signal collapse? | 文章二 |
| S12 | Context | 为「在 VENTUNO Q 上设计一个本地优先的 Agent Harness」准备背景资料 | 文章一 + 文章二 |
| S13 | 负样本 | 如何用 Airflow 配置 DAG 的调度重试策略? | 无(应明确拒答) |
| S14 | 负样本 | Transformer 多头注意力机制的计算复杂度是 O(n²·d) 吗? | 无(应明确拒答) |
相关文件(仓库内)
- 完整评测集:
bench/cases/eval_scenarios.json - 评测方法与全部指标:
bench/results/REPORT.md - 各题三组原始回答:
bench/results/appendix_answers.md
相关阅读
- 299 美金的个人知识库开发板——同一块 VENTUNO Q 的完整上手教程:把模型跑起来、变成常驻的 OpenAI 兼容服务,以及三个会让你白耗一下午的坑。本文的本地推理后端就是那篇里搭出来的。
- 我的知识编译器,把自己的源代码编译没了——第二节那条「Raw immutable」原则是怎么用一次真实事故换来的:编译器写回源头,把 122 行草稿清成了空字符串哈希。
- 数万名员工,是一块活的评测集——本文附录 B 那 14 道题的思路来源:评测集不是交付前的一次性验收,而是持续生产 Context 的模具。