OpenAI 负责 ChatGPT 与 Codex 的 Tibo Sottiaux(Codex 的创建者之一,现管 Core Products & Platform)在 The Pragmatic Engineer 的播客里描述了他自己现在的工作方式:开会开到一半想到一个问题,过去他会先记下来,回头找对应团队聊一聊;现在他直接拿起手机,把这个问题用语音说出去,扔给 agent 跑——用户反馈到底怎么样、哪些功能根本没人用可以砍掉、某个团队最近在忙什么。他说他遇到的大部分问题,三十分钟之内就能拿到第一版报告。
晚上没想完的事,他直接派 Codex 通宵去查,第二天早上起来看结果。周末做原型,用他自己的话说是「把想法从脑子里冲出去」,一天之内拿到反馈。
这些细节我核过一手字幕,都是真的。而真正让我停下来的是另一句——他说现在的情况是「突然有上百个 agent 在往同一个东西上贡献,而这可能在一个周末里就发生」。
这句话的份量不在 agent 数量,在于它意味着:对他个人来说,执行配额已经不存在了。 他不需要排期,不需要申请,不需要说服任何人这件事值得做——想到就发出去,半小时后有结果。
那问题来了:为什么在他这样的公司里成立的事情,放到绝大多数公司里,一个想法从冒出来到被处理,还是要等三个月?
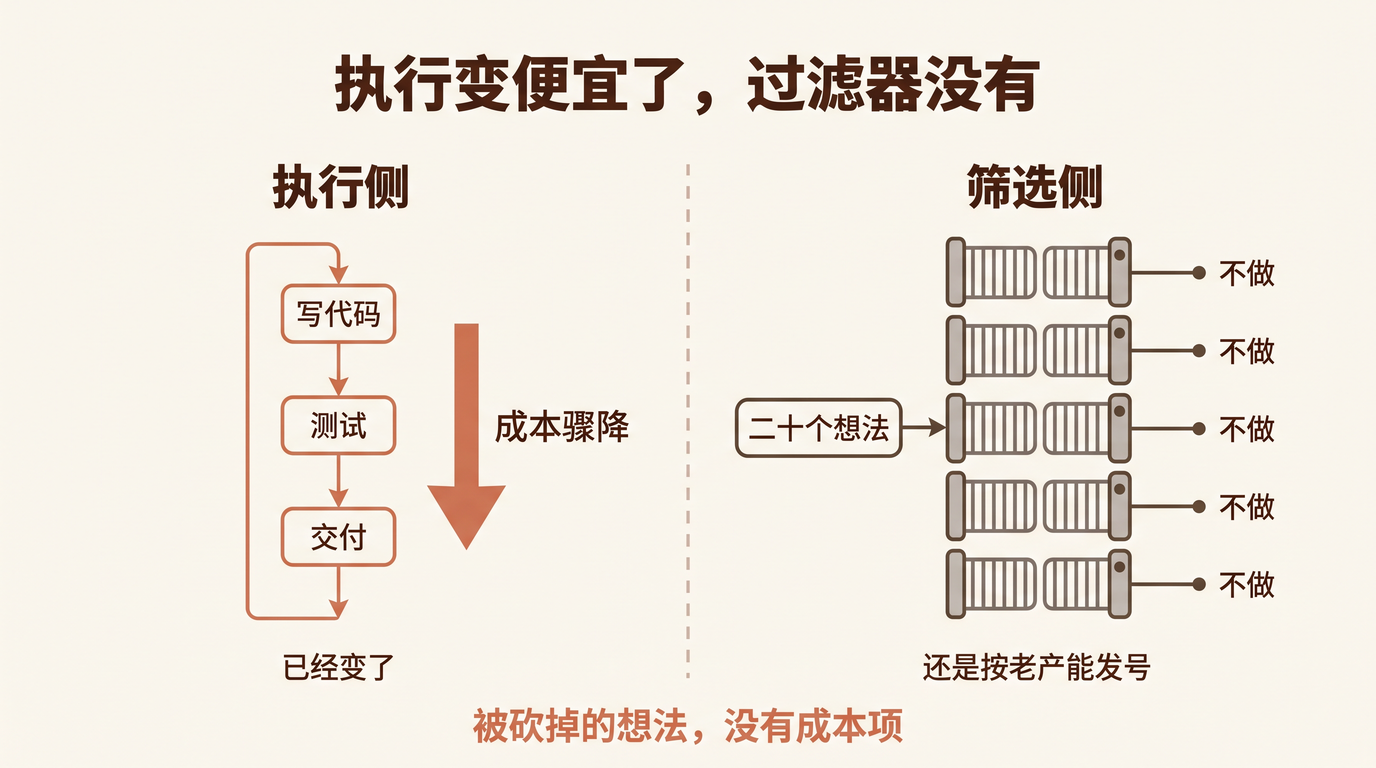
我的答案是:因为执行变便宜了,过滤器没有。
一、你的流程不是流程,是配额
先看一个我去年写过的真实链路。把组织当成产品来打造 里记过一个案例:一个做智能客服的团队算过,从客户提出需求到方案交付平均 14 天。拆开是这样的:
客户提需求 → 销售(1 天)
           → 解决方案团队(等 2 天)
           → 写 PRD 转产品(等 1 天)
           → 产品评审排期(等 3 天)
           → 技术实现(5 天)
           → 交付验收(2 天)
              ────────────────
              14 天里真正在干活的不到 5 天
              剩下 9 天全是等待
# generated by hugo AI
当时我算这笔账,算的是「交付慢」——9 天等待是效率损失。现在我想换个口径重算一遍:那 9 天不是浪费,那是过滤器在运行。
每一段等待背后都有一道关卡:销售要不要转、解决方案团队有没有空、PRD 能不能过评审、这一版排不排得进去、验收谁签。这些关卡不是官僚主义的产物,它们是一套 配额机制——在执行产能有限的年代,组织必须有个办法决定「谁能占用产能」。立项评审、排期会、优先级排序,全都是同一个东西的不同名字:发号。
我在 LLM 押注在 Coding Agent 上是正确的 里写过另一组数字:同一件事走公司正规 IT 流程——提需求、排期、开发、测试、上线——保守估计三个月,还不一定能排上。「不一定能排上」这六个字,就是配额机制在说话。
关键点在这里:配额机制的设计前提是产能稀缺。前提变了,机制不会自己变。
AI 把执行成本压低了一个数量级,但你的立项评审还在按去年的产能发号。它不会拒绝得更多,它只会 继续按老节奏拒绝——而拒绝的理由依然充分,因为流程就是这么设计的。这就是为什么很多公司的 AI 转型体感是「工具都买了,怎么没变快」:变快的是执行那 5 天,没变的是前面那 9 天。
二、它失效得无声无息,因为被砍掉的想法没有成本项
过滤器最麻烦的性质是:它的产出不出现在任何报表里。
那篇头条视频的作者在解读这场访谈时,有一句提炼我认为比访谈本身更值得琢磨(这是他的判断,不是 Tibo 的数据):一个老板一天可能冒出二十个问题,但最后真正落进组织、值得人力去调查和执行的,也许只有两三个。不是说另外那十几个没有价值,而是没有那么多人去做。
这句话描述的就是配额机制的日常运转。它每天都在工作,每天都在拒绝,而且拒绝得非常合理——「人手不够」「这季度排满了」「优先级不高」。
但请注意:那十几个死掉的念头,在账面上根本不存在。 它们没有成本项,没有工时记录,没有一行报表。做砸了的项目会有复盘,做慢了的项目会有周报,而 没做的项目什么都没有。它不是浪费——浪费至少还有个数字;它在你的财务口径里压根没有出生过。
所以过滤器从来没被审计过。不是因为大家觉得它对,而是因为 审计一个东西的前提是它能被计量,而它的产出恰好是「没有发生的事」。
这也是为什么「AI 让执行变便宜」这个好消息,会在组织里产生一个反直觉的结果:执行便宜之后,被过滤器挡掉的东西的价值第一次变得可观了。 过去一个想法被砍掉,你损失的是「反正也没人做」;现在一个想法被砍掉,你损失的是「本来半小时就能有第一版结果」。同样的过滤器,拦掉的东西变贵了。
三、过滤器审计:给每道关卡问三个问题
我把该做的事写成了一个可复用的审计。逻辑很简单:把所有会拒绝一件事的关卡列出来,对每一道问三个问题。
        每一道关卡,问三个问题
   ┌────────────────────────────────────────┐
   │ 1. 它当年是为哪一种稀缺设计的?        │
   │    执行稀缺 / 注意力稀缺 / 风险 / 合规 │
   ├────────────────────────────────────────┤
   │ 2. 那种稀缺今天还在吗?                │
   │    还在 → 保留,判据不动               │
   │    不在了 → 判据必须换                 │
   ├────────────────────────────────────────┤
   │ 3. 换成什么判据?                      │
   │    从「有没有产能做」                  │
   │    换成「有没有人为结果签字」          │
   └────────────────────────────────────────┘
              ↓
   同时补一个从未有过的指标:被拒绝数量
   (不是通过率——通过率高的关卡,
    拒绝的绝对量可能最大)
# generated by hugo AI
第三问是整套审计的核心,我会在第四节正面回答最强的反对意见时展开。先把它落成代码:
from dataclasses import dataclass, field
from enum import Enum


class Scarcity(Enum):
    """这道关卡当年是为哪一种稀缺设计的。"""
    EXECUTION = "execution"     # 没人手做 —— AI 冲击的正是这一种
    ATTENTION = "attention"     # 没人看得过来 —— 部分被 AI 缓解,未消失
    RISK = "risk"               # 出错代价高 —— 与执行成本无关,长期存在
    COMPLIANCE = "compliance"   # 法规硬约束 —— 不因技术变便宜而松动


@dataclass
class Filter:
    """一道会拒绝一件事的关卡。"""

    name: str
    scarcity: Scarcity
    still_scarce: bool
    rejected_last_quarter: int = 0        # 上季度拒绝了多少件(不是通过率)
    has_signer: bool = False              # 通过的事有没有人愿意为结果签字

    def should_keep(self) -> bool:
        """稀缺还在就保留。合规类关卡不因技术变化而松动,单列。"""
        return self.still_scarce or self.scarcity is Scarcity.COMPLIANCE

    def needs_new_criterion(self) -> bool:
        """为执行稀缺而设、且执行已不再稀缺的关卡:判据必须从产能换成归属。"""
        return not self.still_scarce and self.scarcity is Scarcity.EXECUTION

    def is_blind_spot(self) -> bool:
        """从没统计过自己拒绝了多少件的关卡 = 审计盲区。"""
        return self.rejected_last_quarter == 0


@dataclass
class FilterAudit:
    """对一条交付链路上的所有关卡做一次审计。"""

    filters: list[Filter] = field(default_factory=list)

    def add(self, f: Filter) -> None:
        self.filters.append(f)

    def report(self) -> str:
        keep = [f for f in self.filters if f.should_keep()]
        recut = [f for f in self.filters if f.needs_new_criterion()]
        blind = [f for f in self.filters if f.is_blind_spot()]
        unsigned = [f for f in self.filters if f.has_signer is False]
        total = sum(f.rejected_last_quarter for f in self.filters)

        def names(items: list[Filter]) -> str:
            return "、".join(f.name for f in items) if items else "—"

        return "\n".join([
            f"关卡总数:{len(self.filters)}",
            f"保留原判据:{len(keep)}({names(keep)})",
            f"判据必须换:{len(recut)}({names(recut)})",
            f"审计盲区(未统计拒绝数):{len(blind)}({names(blind)})",
            f"通过后无人签字:{len(unsigned)}({names(unsigned)})",
            f"上季度累计拒绝:{total} 件",
        ])
# generated by hugo AI
拿第一节那条 14 天链路跑一遍(rejected_last_quarter 是示意值,用于展示口径——真实审计要用你自己的工单系统数据填):
audit = FilterAudit()

# 客户提需求 → 销售:销售要不要转给解决方案团队
audit.add(Filter(
    name="销售转述",
    scarcity=Scarcity.ATTENTION,       # 解决方案团队看不过来,所以由销售筛一道
    still_scarce=True,                 # 注意力仍稀缺:AI 没有替销售判断客户意向
    rejected_last_quarter=18,
    has_signer=True,                   # 销售对「这个客户值得投入」是签字的
))

# 解决方案团队排队:等 2 天
audit.add(Filter(
    name="解决方案排队",
    scarcity=Scarcity.EXECUTION,       # 典型执行稀缺:人不够
    still_scarce=False,                # 方案原型现在可以由 agent 出
    rejected_last_quarter=7,
    has_signer=False,                  # 排队没有责任人,只有先后顺序
))

# PRD 评审:等 1 天
audit.add(Filter(
    name="PRD 评审",
    scarcity=Scarcity.EXECUTION,
    still_scarce=False,                # 评审的目的是防止开发白干;开发不再白干
    rejected_last_quarter=4,
    has_signer=True,
))

# 产品评审排期:等 3 天
audit.add(Filter(
    name="排期会",
    scarcity=Scarcity.EXECUTION,
    still_scarce=False,
    rejected_last_quarter=0,           # ← 从来没统计过排掉多少需求
    has_signer=False,
))

# 交付验收:2 天
audit.add(Filter(
    name="交付验收",
    scarcity=Scarcity.RISK,            # 出错代价高,与执行成本无关
    still_scarce=True,
    rejected_last_quarter=2,
    has_signer=True,
))

print(audit.report())
# generated by hugo AI
跑出来的结果是这样的:
关卡总数:5
保留原判据:2(销售转述、交付验收)
判据必须换:3(解决方案排队、PRD 评审、排期会)
审计盲区(未统计拒绝数):1(排期会)
通过后无人签字:2(解决方案排队、排期会)
上季度累计拒绝:31 件
# generated by hugo AI
三个观察,都是这份审计报告自己说出来的:
- 五道关卡里有三道判据过时——但不是所有流程都要拆。
Scarcity.RISK和COMPLIANCE这两类不会因为执行变便宜而松动,验收和安全评审该留。这也说明「AI native 就要砍流程」是个错误的口号。 - 「判据必须换」和「通过后无人签字」这两栏高度重合——解决方案排队、排期会,既是判据过时的,也是没人签字的。这不是巧合:配额机制天生不需要签字人,它只需要一个顺序。
- 排期会同时是审计盲区——
rejected_last_quarter=0。它是那条链路上等得最久的一段(3 天),却是唯一从来没有统计过自己拦掉多少需求的关卡。最贵的过滤器,往往是最没被计量的那个。
四、最强反方:执行便宜,不等于承担便宜
这个方案有一个很硬的反对意见,我得正面回答:过滤器不该拆,因为它防的不是产能浪费,是责任真空。
agent 可以在一个周末里贡献出上百个改动,但验收的人、上线后值班的人、出了事故担责的人、以及未来三年维护它的人,全都是人。放开配额的结果不是「一百件事都做完了」,而是「一百个需要长期维护的系统同时诞生了」——那不是资产,那是负债。执行成本下降的同时,承担成本一分钱没降。所以过滤器不但要留,还要留得更严。
这个反对意见我认为基本是对的,所以我不是要拆过滤器。我要换的是它的判据。
旧判据是「我们有没有产能做这件事」。新判据是「有没有人愿意为这件事的结果签字」。
这两件事在执行昂贵的年代是同一个问题的两面——产能稀缺的时候,能抢到产能的事,天然就有人愿意为它负责,因为占用产能本身就是承诺。所以过滤器只问前一个问题就够了,后一个问题是隐含的。
执行变便宜之后,这两件事分裂了:产能不再是约束,归属才是。 一个想法现在半小时就能有第一版结果,于是「能做」变得毫无信息量——什么都能做。真正稀缺的变成「谁愿意说这件事做得好不好、做得不对谁负责」。
所以新判据其实比旧判据更严,不是更松。它不问你有多少人力,它问你有没有一个具体的人肯把自己的名字放在结果旁边。而在我的经验里,大量被排期会放行的事情,恰恰是没人签字的——它们通过的方式是「大家都觉得可以做」,而不是「有人愿意为它负责」。
这跟我在 评测集是一份没人签字的文件 里写的是同一件事的两面:那篇说的是「好」的标准必须有人签字才算数,这篇说的是「该不该做」也必须有人签字才算数。没有签字的评测集无法验收,没有签字的立项无法负责。 而 私有 Eval 是终极护城河 讲的正是:签字之所以是护城河,因为它是最难被复制的东西——模型可以买,产能可以扩,愿意为结果担责的人不能。
五、这和「让 AI 看得见你的公司」是两堵不同的墙
回到那篇头条视频。它的三层框架——可读、可操作、可迭代——我认为第一层最扎实:Codex 在 OpenAI 内部默认接入了 Slack、全部文档和全部代码,新人遇到问题被教的第一句话是「你问过 Codex 了吗」,而团队是 刻意 在公开频道工作、刻意把文档权限放宽的。
那位作者由此得出的结论是:AI native 的第一步不是买账号让员工用起来,而是让整个组织变得机器可读。
这个判断我在 要 AI-native,我最想让大家停掉的不是手工劳动 里从另一个方向说过:一个组织有多 AI-native,首先取决于它的上下文有多机器可读;而那篇文章里最难的一节,是我给自己开的那张清单——把信息攥在手里当权力,要换成把上下文公开当默认,因为激励不变,Stop 清单永远执行不下去。
所以「可读」那堵墙是 产权墙:信息属人化本身就是权力,交出去就贬值。
而这篇讲的是另一堵墙,是 配额墙:即使信息全公开了、AI 全看得见了、执行也真的便宜了,一件事从被想到到被做出来,仍然要过那五道关卡。产权墙拆了,配额墙还在。
这两堵墙的区别很重要,因为它们卡的是不同的人:产权墙卡在 员工身上(他凭什么把五年的经验写进知识库),配额墙卡在 管理者身上(他凭什么承认自己那套发号机制已经过时)。前者要靠激励设计,后者要靠一次审计——而审计的前提,是先承认「被拒绝的数量」是一个值得统计的指标。
最后留一个我自己也没想清楚的问题:过滤器审计能找出判据过时的关卡,但 它找不出那些从来没有人提议过的事情。
排期会至少还有个队列,队列里的需求至少被人提出来过。可有一类东西连队列都进不去——那些从来没人觉得值得提的想法。执行昂贵的时候,这类想法在萌芽阶段就被自我审查掉了,员工自己就会想「这个提了也白提」。执行便宜之后,这层自我审查会不会自动消失?还是要花更长时间?
我不知道。我只知道 Tibo 那种「想到就发一段语音出去」的工作方式,最贵的部分不是三十分钟出报告,而是 他已经不再自我审查了。
你的组织里,上一次有人提出一个明显没人手做、但确实值得试的想法,是什么时候?它后来去哪了?欢迎留言聊聊。