Anthropic 在 10 月 7 日发布了 Claude Haiku 5.5。我盯着官方那张 benchmark 表看了一会儿,目光没停在新一代的分数上,而是停在了它旁边那一列——上一代 Haiku 4.5。
那一列有几个数字很刺眼:
                        Haiku 4.5    Haiku 5.5
Terminal-Bench 4.0        0.0%   →    39.2%
OSWorld 2.1(离线子集)    15.7%   →    72.4%
Humanity's Last Exam      10.2%   →    45.9%
Chartography               6.4%   →    46.4%
# generated by hugo AI
Terminal-Bench 4.0,0.0%。
这不是「差一点」。0 分意味着这个模型在 agentic 编码任务上 系统性失灵——不是偶尔做错,是几乎做不出任何一个能通过的任务。任何一个去年拿 Haiku 4.5 做过 agent 的工程师都知道,面对一个 0 分的模型,你不可能靠改 prompt 让它跑通。你只能靠工程去兜:把任务拆得更碎、加重试、加多轮自我修正、加输出校验、加人工检查点。
而这一次升级,那个 0.0% 变成了 39.2%。
我第一反应不是「新模型真强」。我第一反应是:过去一年里,所有人为「Haiku 做不到」而写的那些补偿代码,从 10 月 7 日起,集体变成了负资产——而且没有任何人会收到通知。
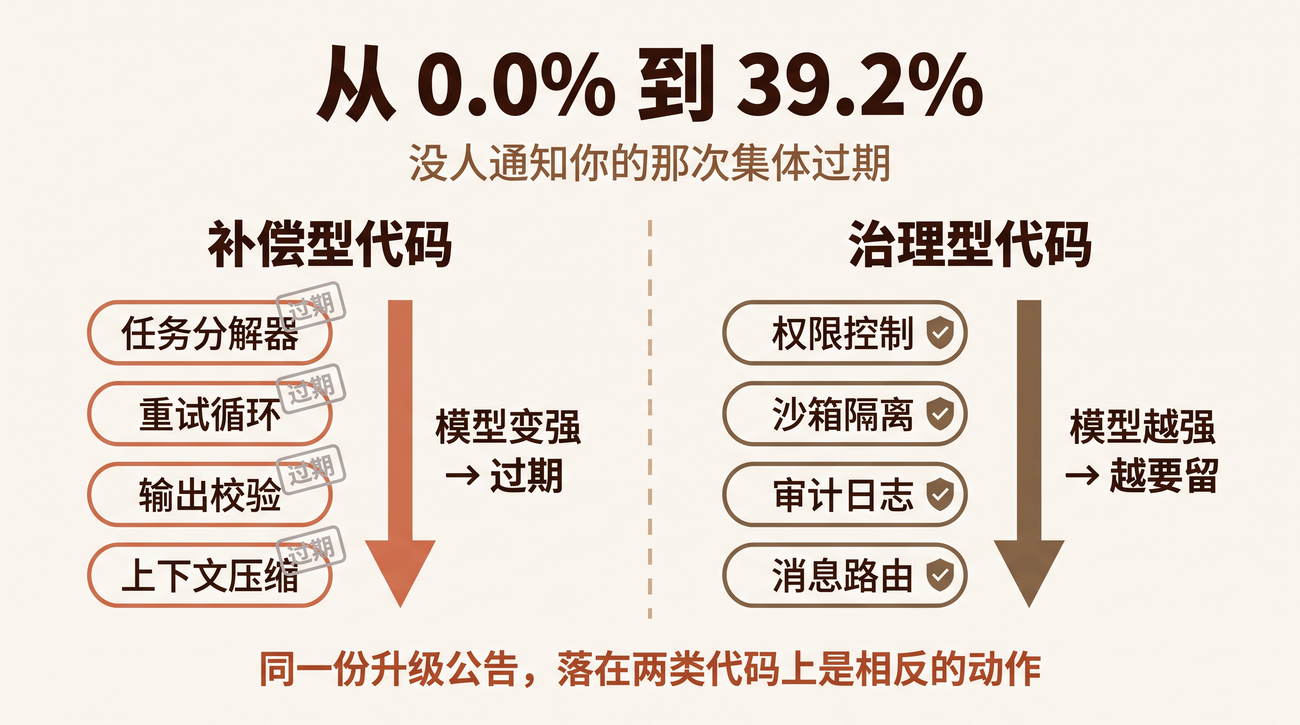
一、0.0% 是一个会「长代码」的数字
先说清楚为什么 0.0% 这个值特别值得盯着。
一个模型得 20 分,你的工程补偿是「帮它把对的部分做稳」;一个模型得 0 分,你的工程补偿是「替它把整件事做完」。这两种情况下长出来的代码,厚度差一个数量级。
面对 0 分,harness 里会不可避免地堆积这几类东西:
- 任务分解器:一个大任务它做不了,那就切成十个它也许能做的小步骤,一步一步喂
- 重试与自我修正循环:它一次做不对,那就让它做五遍,取通过的那遍
- 输出校验层:它的输出不可信,那就再加一个解析器 + 规则引擎去兜
- 人工检查点:校验也不够,那就在关键步骤插一个「等人确认」
这些代码有一个共同点:它们存在的唯一理由,是模型在那个能力维度上是 0。 它们不是在实现业务逻辑,它们是在给模型的短板打补丁。
现在短板补上了(0→39.2),补丁就成了赘肉。而且是最危险的那种赘肉——它不但没用,还 反过来有害:任务分解器还在把本来能一次做完的事切成十步(多花 token、多花延迟);重试循环还在让它做五遍(其中四遍纯属浪费);人工检查点还在打断一个本可以自动跑完的流程。
我在 模型正在吞噬 Agent 框架 里写过一句话:框架复杂度是负资产,模型每吞噬一项能力,你框架里对应的那层代码就开始计息。
但那篇讲的是 渐进 的吞噬——2023 的 ReAct、2024 的 Function Calling、2025 的 Native Tool Use,一层一层慢慢被内化,你有时间反应。Haiku 这次不一样:它是一次阈值跳变。 从 0.0% 到 39.2% 不是「又变强了一点」,是跨过了「完全不能用」到「勉强能用」那道坎。跨过去的那一刻,一整批补偿代码同时失去存在理由。
渐进的负债你可以边跑边还;跳变的负债是一次性计提的,而且计提那天没人给你发对账单。
二、把 harness 代码分成两类:补偿型,和治理型
要处理这笔负债,先得能识别它。我用一个二分法把我自己 harness 里的每一段代码分开——这个分类可以直接拿去套任何 agent 框架。
        你的 harness 代码,先问一句:
        「如果模型能力再涨十倍,这段代码还有用吗?」

   ┌─────────────────────────┬─────────────────────────┐
   │ 补偿型                  │ 治理型                  │
   │ COMPENSATING            │ GOVERNING               │
   ├─────────────────────────┼─────────────────────────┤
   │ 为「模型做不到 X」      │ 与模型能力无关,        │
   │ 而写的补丁              │ 为「不能出错」而写      │
   ├─────────────────────────┼─────────────────────────┤
   │ 任务分解器              │ 权限控制                │
   │ 重试 / 自我修正循环     │ 沙箱隔离                │
   │ 输出校验兜底            │ 审计日志                │
   │ 人工检查点              │ 消息路由                │
   │ 为省钱做的 compaction   │ 密钥 / 凭证管理         │
   ├─────────────────────────┼─────────────────────────┤
   │ 模型越强 → 越该删       │ 模型越强 → 越要留       │
   │ 有保质期                │ 永久保留                │
   └─────────────────────────┴─────────────────────────┘
# generated by hugo AI
判据就一句话:「如果模型能力再涨十倍,这段代码还有用吗?」
补偿型的答案是「没用甚至有害」——它防御的短板消失了。治理型的答案是「更有用」——模型越强、能调用的工具越多、能触达的系统越深,权限和沙箱就越重要。一个能自己写完整个项目的 agent,比一个只会补全一行的 agent,需要更严的权限边界,而不是更松的。
拿 #310 里我解剖过的那个钉钉 harness 重新切一遍。当时我说它的 600 行核心逻辑,三个月后五个模块可删、一个大幅简化,最后剩 80 行。现在用补偿/治理这把刀重新分:
| 模块 | 类型 | 为什么 |
|---|---|---|
| 轮询循环 | 补偿 | 因为「serve 端没推送」——SSE 上线后该删 |
| Session 管理 | 补偿 | 因为「serve 端无状态」——它开始维护会话后该删 |
| Abort 清理 | 补偿 | 因为「没有原生取消语义」——支持 abort 后该删 |
| 工具注册 / JSON 解析 | 补偿 | 因为「模型需要 JSON Schema」——原生 tool use 后该删 |
| 错误重试 / 降级 | 补偿 | 因为「模型不会自己重试」——内化 retry 后该删 |
| 上下文拼接 / 裁剪 | 补偿 | 因为「上下文窗口不够」——长上下文后大幅简化 |
| 消息路由 | 治理 | 钉钉 → serve 的转发,与模型能力无关,永久保留 |
| 权限控制 | 治理 | 谁能触发什么操作,模型越强越重要,永久保留 |
那 600 行里,剩下的 80 行——消息路由和权限控制——恰好全是治理型。这不是巧合。当模型把能力短板一个个补上,harness 里能活下来的,只有那些「与模型多聪明无关」的部分。
三、让 eval 决定补偿代码退休,而不是人
分类只是第一步。真正的问题是:怎么知道该删了?
靠人主动发现是不行的。补偿代码有个心理陷阱——它是「防御性」的,删它的心理成本远高于留着它。留着的理由是「万一还有用呢」,删掉的恐惧是「万一模型在某些边缘 case 还是不行呢」。于是理性选择永远是留着,负债只增不减。
而且模型升级 不会 diff 你的代码库。Anthropic 发布 Haiku 5.5 时,不会告诉你「你三个月前写的那个任务分解器现在可以删了」——它甚至不知道你的代码长什么样。升级公告里只有 benchmark 分数,没有「你的哪些 workaround 该退休」。
正确的机制是把退休判断交给 eval:给每一段补偿代码挂一个评测,评测的通过条件就是「它所防御的那个短板,模型现在能不能自己搞定」。 模型分数跨过阈值,eval 自动标记这段代码「可退休」。人只需要 review eval 的结论,不需要自己去盯每一次模型发布。
from dataclasses import dataclass
from enum import Enum


class ModuleKind(Enum):
    COMPENSATING = "compensating"   # 为「模型做不到 X」而写的补丁
    GOVERNING = "governing"         # 权限/沙箱/审计/路由,与模型能力无关


@dataclass
class HarnessModule:
    """harness 里的一个模块,带上它的退休判据。"""

    name: str
    kind: ModuleKind
    defends_against: str            # 它防御的模型短板(治理型留空)
    eval_score: float               # 当前模型在该短板 eval 上的分数(0~1)
    retirement_threshold: float     # 分数越过这条线 = 短板已补上 = 该退休
    retention_cost: str             # 留着它的代价(延迟/token/维护)

    def should_retire(self) -> bool:
        """治理型永不因模型升级退休;补偿型看 eval 是否越过阈值。"""
        if self.kind is ModuleKind.GOVERNING:
            return False
        return self.eval_score >= self.retirement_threshold


# 针对 Haiku 4.5(Terminal-Bench 0.0%)写的一批补偿模块,
# 在 Haiku 5.5 上的复审。eval_score 用官方 benchmark 归一化:
# Terminal-Bench 4.0 Haiku 5.5 = 39.2%(Sonnet 5.5 = 70.6% 作为满分参照)。
TERMINAL_BENCH_FULL = 0.706
haiku55_terminal = 0.392 / TERMINAL_BENCH_FULL      # ≈ 0.555,相对当前最强档
haiku45_terminal = 0.0 / TERMINAL_BENCH_FULL        # 0.0

modules = [
    HarnessModule(
        name="任务分解器(大任务切十步)",
        kind=ModuleKind.COMPENSATING,
        defends_against="Haiku 4.5 无法完成多步 agentic 编码(Terminal-Bench 0.0%)",
        eval_score=haiku55_terminal,
        retirement_threshold=0.4,          # 相对最强档达到 40% 即可尝试去掉分解
        retention_cost="每任务多花 ~10x token 与串行延迟",
    ),
    HarnessModule(
        name="重试 / 自我修正循环(做五遍取一遍)",
        kind=ModuleKind.COMPENSATING,
        defends_against="Haiku 4.5 单次成功率≈0",
        eval_score=haiku55_terminal,
        retirement_threshold=0.5,
        retention_cost="4/5 的推理纯属浪费",
    ),
    HarnessModule(
        name="为省钱做的上下文 compaction",
        kind=ModuleKind.COMPENSATING,
        defends_against="旧模型 cache read 贵($0.10/M)",
        eval_score=0.9,                    # cache read 已降到 $0.01/M,省钱动机基本消失
        retirement_threshold=0.6,
        retention_cost="压缩本身要跑一次模型,且可能丢信息",
    ),
    HarnessModule(
        name="权限控制(谁能触发什么操作)",
        kind=ModuleKind.GOVERNING,
        defends_against="",
        eval_score=0.0,                    # 治理型不看模型分数
        retirement_threshold=1.1,          # 永远够不到
        retention_cost="—(不该删)",
    ),
    HarnessModule(
        name="沙箱隔离",
        kind=ModuleKind.GOVERNING,
        defends_against="",
        eval_score=0.0,
        retirement_threshold=1.1,
        retention_cost="—(模型越强越要留)",
    ),
]

print("模块退休复审(Haiku 4.5 → 5.5)\n")
for m in modules:
    verdict = "→ 退休" if m.should_retire() else "→ 保留"
    kind = "补偿" if m.kind is ModuleKind.COMPENSATING else "治理"
    print(f"[{kind}] {m.name}")
    print(f"      eval={m.eval_score:.2f} 阈值={m.retirement_threshold:.2f}  {verdict}")
    if m.kind is ModuleKind.COMPENSATING:
        print(f"      留着的代价:{m.retention_cost}")
# generated by hugo AI
跑出来的复审结论是这样的:
模块退休复审(Haiku 4.5 → 5.5)

[补偿] 任务分解器(大任务切十步)
      eval=0.56 阈值=0.40  → 退休
      留着的代价:每任务多花 ~10x token 与串行延迟
[补偿] 重试 / 自我修正循环(做五遍取一遍)
      eval=0.56 阈值=0.50  → 退休
      留着的代价:4/5 的推理纯属浪费
[补偿] 为省钱做的上下文 compaction
      eval=0.90 阈值=0.60  → 退休
      留着的代价:压缩本身要跑一次模型,且可能丢信息
[治理] 权限控制(谁能触发什么操作)
      eval=0.00 阈值=1.10  → 保留
[治理] 沙箱隔离
      eval=0.00 阈值=1.10  → 保留
# generated by hugo AI
三个补偿型模块全部触发退休,两个治理型模块纹丝不动。这就是分类的意义:同一份 benchmark 公告,落在两类代码上是完全相反的动作。
这里有个细节值得单独说,就是那个 compaction。官方在同一篇发布稿里,一边把 cache read 价格打到 $0.01(Haiku 4.5 是 $0.10),一边仍然推荐用 Haiku 5.5 做 compaction。这两件事看起来矛盾——compaction 本来是为了省 token,可重读上下文已经近乎免费了,还压什么?
答案是:compaction 的动机正在从「省钱」变成「保上下文质量」(窗口再长,注意力也会被无关内容稀释)。但这两个动机的工程判据完全不同——省钱看 token 数,保质量看任务成功率。如果你的 compaction 代码当初是为省钱写的、按 token 数触发,那它现在就是一个动机已失效却还在跑的补偿模块。成本下降不会自动简化你的设计,它只会让你的旧判据失效,而你以为它还在工作。
四、最强反方:留着当保险不行吗
这个方案有一个很硬的反对意见:补偿代码是保险。模型 benchmark 是平均分,可我的真实任务不是平均任务——万一在某个边缘 case 上,5.5 还是不行呢?把分解器、重试循环删了,出了事谁负责?留着它们顶多是慢一点、贵一点,删了才是真风险。
这个担心有道理,而且它戳中了一个真问题:Haiku 5.5 是首个 effort 可调的 Haiku 级模型——同一个模型,Low 档和 Max 档的能力天差地别。39.2% 是某一档下的分数,不代表你实际用的那一档。所以「平均分过阈值」确实不能直接推出「你的补偿代码可以删」。
但我认为这恰恰是 支持 eval 触发退休、而不是反对它的理由。
第一,「保险」不是免费的。补偿代码的保费是三样,每一样都在天天付:延迟(每步多余分解)、成本(多花的 token)、以及最贵的一样——认知负债。新人读到那段任务分解器,会以为「这个任务就是得分十步做」,于是他不会去质疑它,只会在它之上继续叠加。错误的假设一旦被代码固化,就会自我繁殖。
第二,「万一边缘 case 不行」的正确解法,不是永久保留补偿代码,而是 把那个边缘 case 写进 eval。如果你担心某类任务 5.5 还搞不定,那就给这类任务建一个评测集,让它在每次模型升级时自动跑——分数够就退休补偿代码,分数不够就保留。这比「因为怕万一,所以全都留着」精确得多。
第三,也是关键:保留补偿代码不是「零风险」,它只是把风险从「显性故障」换成了「隐性劣化」。 删错了,任务失败,你立刻知道,回滚就行。留错了,任务照样成功,只是慢三倍、贵三倍,而且没人会报警——因为它「还能用」。我在 未来的员工,有两份成本单 里说过,token 单价趋零之后,账本的价值不在绝对金额而在归因。补偿代码就是那笔最难归因的成本:它不报错,它只是让你所有的 agent 都比该有的样子慢一点、贵一点,而你查不出是哪一段。
所以我的结论是:反方说的「怕万一」是对的,但应对方式错了。不是用「全都留着」来防万一,是用「给每段补偿代码挂一个能证伪它的 eval」来防万一。保险要买在评测集里,不要买在代码库里。
这也接上了我在 私有 Eval 是终极护城河 和 评测集是一份没人签字的文件 里反复讲的同一件事:eval 不只是用来验收模型好不好,它还是你 管理自己代码保质期的仪表盘。没有 eval 的 harness,在模型跳变那天就是瞎的——你不知道哪批代码已经过期,只能靠某天性能莫名其妙变差了才回头去查。
五、把它变成一个例行动作
最后落到可执行的部分。我建议每个维护 harness 的团队做三件事:
- 给现有代码打标签:逐段问「如果模型能力再涨十倍,这段还有用吗」,分成补偿型和治理型。这一步本身就会让你惊讶——很多你以为是「业务逻辑」的代码,其实是某个早已被补上的模型短板的补丁。
- 给每段补偿代码挂一个 eval:评测内容就是它所防御的那个短板。阈值设在你愿意「冒险去掉补丁」的那条线上。
- 把「模型升级」变成一个触发器:每次上游发新模型(或你切换 effort 档、切换供应商),自动跑一遍所有补偿代码的 eval,输出一张退休清单。人只 review 清单,不主动盯发布。
第三件事是最重要的,因为它把「被动负债」转成了「主动管理」。今天的现状是:模型升级公告发出来,benchmark 分数很漂亮,你点个赞,然后继续用你半年前针对上一代模型写的补偿代码——升级的收益你拿到了,升级的负债你没清。 而负债不会自己消失,它只会在新模型的能力之上,继续拖着你,直到某天你发现「为什么我们用了最强的模型,agent 还是又慢又贵」。
答案通常是:因为你还在为一个已经不存在的短板付钱。
留一个我自己也没完全想清楚的问题:治理型代码真的「永久保留」吗?
我今天把它定义成「与模型能力无关」——权限、沙箱、审计。但模型越强,治理的形态可能也会变。一个只会补全一行的模型,你防的是「它写错代码」;一个能自己写完整个项目、还能自己造工具的 agent,你要防的是「它做了一个你没授权的决定」。后者的治理,可能不再是静态的权限表,而是某种运行时的意图审查——那又是另一套代码。
所以也许没有真正「永久」的治理型代码,只有「保质期更长」的。补偿型代码的保质期以月计,治理型以年计,但没有哪段代码能逃脱 #310 那句话:不是问它能不能跑,是问它还能跑多久。
你的 harness 里,有没有那种「明明模型早就能自己做了,但因为没人敢删所以还留着」的代码?你是怎么发现它该删的——靠 eval,还是靠某天性能突然变差?欢迎留言聊聊。