写给正在做企业 IM 场景 Agent 的工程师。你已经能让一个 Agent 在钉钉里回消息、调工具、查制度。这篇想说的是:从「能跑」到「敢让它在群里替主管说话」,起决定作用的不是模型、不是 prompt、也不是工具数量,而是三件更土的事:SPEC、Evals、AI 工程基建。
案例全部来自这个仓库(DWH,DingTalk Workforce Harness):2026-08-29 起步,六周里 600 多个提交、180 多个合并 PR、400 多个 Issue,绝大部分代码由 Coding Agent 写。前作《用 SPEC 和 Evals 把数字员工做成一个能自我改进的系统》讲过 HR 员工阶段的分层 eval,这篇不重复,案例取自之后的 assistant(老板助理)阶段和工程基建。
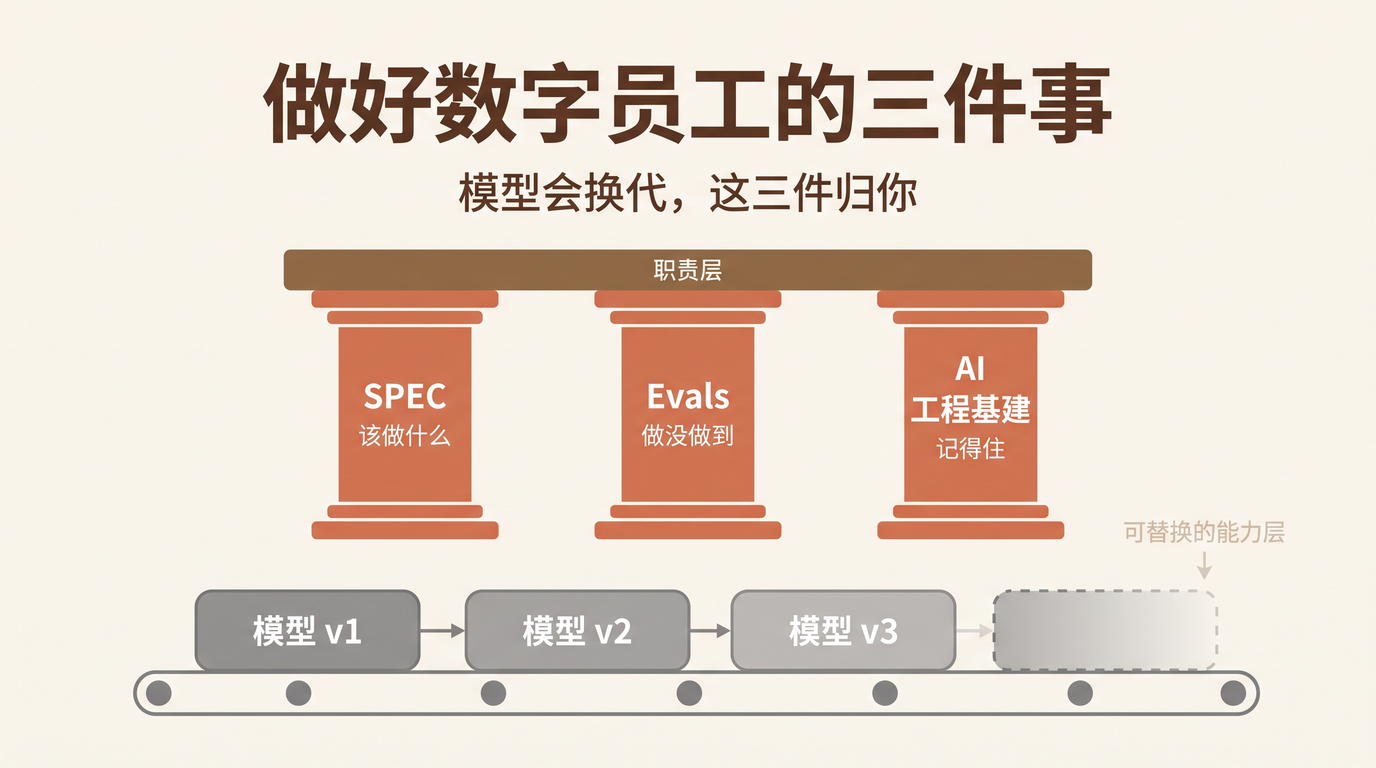
一、先论证:为什么是这三件
1. 数字员工和 Coding Agent 不是一种东西
Coding Agent 的产出有人逐行看:diff 摆在面前,不对就不合。数字员工没有这道人工审核:
- 它常驻 IM、持有组织凭据。 能代主管发消息、建日程、处理审批、操作远端终端。
- 它面对的是一群人,不是一个人。 群里没人 @ 它的时候开不开口、主管随口一句「不错」要不要回,这类问题没有标准答案,只有合同里的约定。
- 它出错的形态是「在群里说错话」。 不报错、不崩溃,日志全绿。前作里那个「同一会话只有第一个问题有回复、之后永远沉默」的 bug,单测、健康检查、
make check全绿地活了很久。
所以数字员工的质量问题,本质是 「它该做什么」和「它实际做了什么」之间的差。要管住这个差,你需要:
- 一份写清楚「该做什么」的东西 → SPEC
- 一套能判定「实际做了什么」的东西 → Evals
- 一套能让这两样东西 持续被维护、不腐烂、不漂移 的东西 → AI 工程基建
2. 模型和框架会变,这三件不会
模型每几个月换一代,框架会被模型吞噬(我在 模型正在吞噬 Agent 框架 里论证过:今天要写插件做的事,明天可能是模型的默认能力)。我们在这个项目里换过模型、升过运行时、从目录进程迁到容器,每一次换,留下来没动的都是这三样:员工 SPEC 照旧是行为的唯一事实来源,eval 用例照旧拿来判新旧版本谁退化,Issue / PR / runbook 照旧回答「为什么现在是这样」。
模型是可替换的能力层;SPEC、Evals、基建是 职责层。职责层不归模型厂商,归你。
3. 三条腿,缺一条的失败形态各不相同
| 缺了什么 | 失败形态 | 本项目里的真实样子 |
|---|---|---|
| 没有 SPEC | eval 没有判据,标签只能拿「过去它怎么做」或「模型现在怎么判」当答案 —— 循环论证 | speak-gate 评测集明令禁止用 observed(历史行为)和模型判决当标签,判据只认 SPEC |
| 没有 Evals | SPEC 是愿望清单;改一句判据,副作用看不见 | 一条更「完整」的发言判据让误开口从 6 例涨到 17 例,只有全集对比才看得出来 |
| 没有基建 | SPEC 和 eval 靠人记得同步,几十个提交后就漂了 | CLAUDE.md 从 557 行砍到 175 行,30 多个提交后又长回 276 行,因为收敛判据只写在 commit message 里 |
最后一行是最容易被低估的。当写代码的是 Coding Agent,瓶颈就从「写代码」移到了「判据和合同」;而判据和合同能不能活下来,取决于基建。
二、SPEC:行为合同,而且是唯一的那一份
实践 1:SPEC 是权威,计划和历史不代表现状
本仓库的交付规则第一条:改行为就在同一 PR 改对应 SPEC 段落;员工与插件 SPEC 是权威,计划和历史记录不代表现状。
employees/assistant/SPEC.md 600 多行,几乎每个小节标题都挂着 Issue 号:「日程与约会(issue #322)」「深度调研(issue #348)」「群内未点名消息的攒批应答(issue #185)」。这不是装饰,它让 SPEC 的每一段都能回答两件事:现在的行为是什么(正文),为什么是这样(Issue)。
反面是设计文档、计划、runbook 里的旧结论。它们按当时事实保留,不追改;一旦 Agent 把计划当现状读,就会照着一个已被推翻的方案去写代码。所以根指令里把这条写死:现状只看 SPEC。
实践 2:SPEC 要被机器读,不只被人读
speak-gate(群里没人点名时,数字员工该不该开口)是最好的例子。「什么时候闭嘴」的行为判断我在 数字员工的活人感,一半是知道什么时候闭嘴 里写过,这篇讲的是把它工程化。它的判据写在 assistant SPEC 里,而 运行时插件和离线评测用同一个读取函数现读这段 SPEC。于是:
- 标注与 SPEC 冲突时,以 SPEC 为准;觉得 SPEC 不对,就改 SPEC(同一 PR 改对应真机用例),不在标注里另立规则;
- 判据只有一份,运行时、评测、人读到的永远是同一句话。
只给人读的 SPEC 迟早和代码分家。被运行时和评测共同消费的 SPEC,分家的那一刻测试就红。
实践 3:把「触发」和「授权」分开写
数字员工的 SPEC 要写清楚哪些交给模型判断、哪些必须由代码确定性判定。
先看一个日常的例子(issue #32)。SPEC 规定:群里收到的任务先提交计划、主管单聊批准后,才把答复发回原群。persona 里写了,模型也确实调用了 submit_plan,但它顺手把「已提交」写成了一段答复,原样发进群里。主管还没批,答复内容已经全群可见。 继续改提示词没有用:把「提交」表述成「回答」,是模型再自然不过的措辞选择。最后的修法是一道确定性门控 shouldSuppressDirectReply:本回合新提交了计划、且消息来自群,就在回合末撤下对原会话的直接回复。它是纯函数,可以离线穷举,于是能进单测。
措辞约束是锦上添花,不是承重墙。谁能在群里说话,由「本回合干了什么」这个可枚举的事实决定,不由模型怎么措辞决定。
远端终端(issue #266)把同一个原则推到了更危险的场景:
- 要不要调用:交给模型(看描述、persona、上下文,不确定、可调);
- 能不能执行:代码按事件桥登记的发信人判(主管 + 单聊 + 对话回合),不满足直接拒绝,连 ssh 都不起。
模型判错只影响「会不会去试」,门禁决定「能不能成功」。
防提示注入也落在同一个思路上(issue #269):终端写入的文字 必须逐字出现在主管本回合亲手写的正文里,而不是给回合打「被污染」标记。前者与内容从哪来无关,后者挡不住已进入会话历史的网页内容。还没解决的那部分(按键白名单仍可能被诱导按 enter)写进了 SPEC 的残余风险,没有假装已解决。SPEC 写「残余」是诚实,也是下一个 Issue 的起点。
实践 4:每个行为都写「判不出来时怎么办」
本项目硬红线第 1 条:配置缺失、JSON 损坏、资源未登记、角色查不到,全部拒绝。这条在 SPEC 层的映射是:每个行为都要写「判不出来时怎么办」。主管批复没反馈就沉默;speak-gate 调用超时按 SILENT 计;审批状态机全文精确匹配,匹配不上不猜。写不出缺省行为的 SPEC,等于把这个决定交给了模型当场发挥。
但缺省不总是「不做」。模型一个字没吐出来时(网关断了、上游协议错),兜底文案该发给谁?SPEC(issue #93)的答案是分角色:群里一字不发、只通知主管并写明来自哪个群;同事单聊对方侧静默、把消息标回未读、通知主管;主管没配置时,退回原样就地回复。最后这条是刻意的 fail-safe:配置缺失、人却在等回复时,「谁也不告诉」是最坏的一种 fail-closed,多说一句的代价远小于静默。
所以判据不是「一律拒绝」,而是 先问失败的代价落在谁身上:越权的代价落在组织上,就 fail-closed;沉默的代价落在正在等回复的人身上,就 fail-safe。两种方向都要在 SPEC 里写明,不能让实现者临场选。
实践 5:SPEC 写「不承担什么」
Issue 驱动开发 SPEC 里有张表,列了六种记录(Issue 正文、Issue 评论、SPEC/EVAL、Feature/Plan、PR、RunBook)各管什么,同时列了各自不承担什么。理由在 runbook 里写得很直白:载体职责一重叠,人就挑最顺手的那个记,其余自动荒废。员工 SPEC 同理:「代理口径」那一节写了助理能替主管做什么,也写了哪些必须回到主管本人。
三、Evals:多套彼此独立的判据,而不是一个分数
前作讲了 HR 阶段的三层(权限单测 / 检索 eval / persona eval)。到了 assistant 阶段,判据又长出了两类:模型判断类(该不该开口)和 回归对比类(新版本比线上差没差)。整体分层如下:
| 层 | 例子 | 速度 | 能判什么 |
|---|---|---|---|
| 离线单测 / 合同 | make test,两千七百多条 | 秒级 | 确定性逻辑、结构闸门、泄漏断言 |
| 离线 evals | 制度问答 golden set、persona、dev 管理、speak-gate 用例集 | 秒级(不调模型的部分) | 交给模型的东西对不对、说出来的话破没破规则 |
| 模型 bench | make speak-gate-bench REPEAT=5 | 分钟级,要网络 | 模型在判据下的命中率、误开口数 |
| 回放回归 | scripts/replay-assistant.mjs:线上真实回合脱敏注入隔离运行时 | 单条约 11 秒 | 候选版本相对线上基线有没有退化 |
| 真机 e2e | /regress 链路,层 × 类 × 环境画像 | 分钟到小时 | 钉钉链路今天通不通、内容对不对 |
硬红线第 8 条把边界钉死:evals 离线、秒级、可单跑一条;真机 e2e 刻意不叫 eval。 名字不同,是为了让人不会拿 e2e 的绿去冒充 eval 的绿,反过来也一样。
案例:一句「不错 你都做对了」是怎么变成一组判据的(#409 / PR #410)
这是本项目里 SPEC + Evals + 基建咬合最完整的一个小样本,值得完整走一遍。
现象。 2026-10-09,demo 群。助理分析完主管分享的文章和图,4.5 分钟后主管没 @ 它,说了句「不错 你都做对了」。它一个字没回。
定位。 两层都在拦:
- 发言门控按 SPEC 判据「对我说谢谢、好的、收到之类的客套 → 不开口」判 SILENT,旧判据 10 次 0 次 SPEAK,稳定复现;
- 即使门控放行,出队回合规则也写着「客套一律不接」。
改法。 SPEC 判据加第 5 条,只有一句:我刚回答完,主管紧接着夸我这次做得好 —— 简短道谢一句。客套那条注明「第 5 条除外」。出队回合规则加同义例外,并用测试锚住「两处同改」。
用例。 真实样本 sg-fb-praise(脱敏,出处记在 labels.jsonl)+ 合成反例:纠错要接;只回「好的」、夸同事刚发的、第三人称提到它,都不接。反例比正例重要,它们定义了这条新判据的边界。
量副作用。 这一步决定了这个 PR 能不能合:
| 判据版本 | 全集准确率(162 条 × 3) | 误开口 | sg-fb-praise |
|---|---|---|---|
| 旧 | 94.4% | 6 | 0/10 |
| 第 5 条长版(评价好坏 + 指错 + 反例说明) | 88.9% | 17 | 10/10 |
| 第 5 条短版(采用) | 95.7% | 5 | 10/10 |
长版把目标用例修好了,同时把误开口翻了近三倍:模型把主管其它带「你」的话(「你说怎么解决吧」「报数到 100」)也判成该接。只跑目标用例,长版是完美的修复。 只有全集对比才看得见它的代价。
落档。 弃用长版的过程写进 evals/speak-gate/README.md 和 SPEC;PR 里写「未覆盖」:出队回合的模型在真实群里会不会只道谢一句,要真机看;门控单次调用仍有抖动。
这个案例里能抽出四条可复用的做法:
① 标签只认 SPEC。 评测集用了一个群 1016 条真实人机对话、最初切出 157 个未点名判断点(之后随事故陆续补入真实样本)。两个诱人的偷懒法都被明文禁止:用 observed(当年它回没回)当标签,测的是「像不像过去」而不是「对不对」;用某个模型现在的判决当标签,是拿被测者当答案。
② 失败方向的代价不对称,就分开计数。 fail-open(该沉默却开口)意味着用户看到它在编;fail-closed(该开口却沉默)只是漏答。bench 把 fail-open 例数单列。工程上只在 fail-closed 一侧兜底(判不出来一律 SILENT),fail-open 要靠数据暴露,不能用工程手段压掉。
③ 模型不确定,就必须重复采样。 实测同一请求体 20 次:不传参数 4/20 SPEAK,temperature=0 4/20,再加 seed=42 5/20。这两个参数在这个模型上不起作用。所以 bench 必须带 REPEAT,严格多数,平票落 SILENT,并列出「不稳定」用例。单次跑出的命中率是噪声。
④ 判据要短。 长版判据想把边界说全,结果模型把边界读宽了。对模型判据,多写一句话就是多一个被误读的入口,加句子之前先在全集上证明它值。
回放:拿线上真实回合判「新版本有没有变差」(PR #391)
dev 员工会依据执行轨迹去改 assistant 的运行时 persona,这是自我改进的外圈。外圈必须有退化闸门:把线上真实回合脱敏成用例,注入一个隔离的 assistant(真运行时 + 真模型 + 假钉钉),候选与线上各跑一遍再对比。
实跑的第一次就证明了它载荷:给候选 persona 追加一句「日程问题不要调用 calendar_ 工具」,基线 7/7,候选 5/7,replay-compare 判「critical 用例退化,净退化 2 条」,退出 1。
比较器的规则值得抄:critical 用例退化直接判负;候选缺用例也判负(删用例不能让候选变好);用例只增不删、先红后绿、判行为不判措辞。实跑中还补了一个判据缺口:「X 点提醒我」是引擎确定性登记的承诺,不经任何工具,只看工具调用会把它误判成「口头答应」,于是加了 commitment 判据。判据缺口往往是第一次实跑才暴露出来的。
全绿证明不了行为:两个静默降级
数字员工最难抓的故障是:每一层都说自己没问题,只有行为变了。下面两个例子决定了本项目 eval 判据的形状。
识图:「没报错」什么都证明不了(issue #82 / #236)。 主管发来截图,助理的回答看起来像是模型能力不行。实际上模型根本没收到图:模型配置里没声明 inputModalities,运行时缺省按纯文本处理,把 image block 静默替换成 [image omitted] 占位符。请求成功、日志正常,所以判据只能落在 可观测的中间量 上:离线测试直接断言「模型这一轮拿到了几个 image block」。
两周后它又发生了一次。为绕开网关的流式故障,模型协议切到了兼容模式,消息通了,主管发图时助理却说「图片我这边看不了内容」,而同一时刻日志写着「已附上 1 张图给模型」。原来的守卫只管 DeepSeek 协议那条路,兼容协议是另一条代码路径,模型条目自己写、不声明就是纯文本。两条教训:
- 「有守卫」不等于「这条路有守卫」。 同一能力有两条配置路径时,守卫按路径各写一条。
- 日志和模型的说法互相矛盾时,矛盾本身就是结论。 别在两句话之间挑一个信:图确实送到了,送到的形状模型读不了。
运行时升级:persona 被丢掉,一切照常(issue #94)。 一次 dsh 升级里,persona 配置键被拆成了 personaPrefix / personaSuffix,旧键被当成未知键静默丢弃。四个员工在 没有 persona 的状态下运行:build 绿、make check 绿、进程起得来、端口有响应,--dump-config 还照样打印那段文本。唯一的症状是模型不再守任何措辞和工具纪律。
从这次起,升级的验证链固定成三段,每段抓的东西不同:
| 段 | 证明什么 | 抓不到什么 |
|---|---|---|
make check(干跑组装配置) | 配置能组装,禁用的插件 id 都还在 | 插件树能不能激活 |
| 真的起一次进程 | 插件树能激活,没有卡在 pending | 运行时行为变没变 |
| 真机回读(persona 生效、并行工具、识图) | 行为没有静默退化 | — |
同一条记录里还有一个反方向的发现:之后一次升级本身很干净,顺手追问「新版本默认打开了什么」,翻出两条 一直默认开着 的会话外发通道(反馈上报、会话日志随模型请求外发),正踩在「真实对话不出本机」那条红线上。安全裁剪清单只覆盖「已经知道要裁的」,它不会提醒你还有没裁的。
真机 e2e:失败方向往往是「绿」
真机回归从散落脚本收成一条链路之后,一天内长出了近 20 处加固,共同点是 失败方向都是「绿」:只测一问,测不出「第二问起永远沉默」;只数回复数,「应了但答错」也算过;选了 0 条用例照样 exit 0;按正文比对回读会被钉钉的 Markdown 重渲染静默打破。每一条都变成了显式判据:同会话连问两条写进 SPEC 验收表,--expect-match / --reject 做内容断言,空用例集拒绝通过,回读用发送回执关联真实消息 id。
E2E 也是 Eval 资产
Coding Agent 改行为时,只补新功能的测试,旧用例会在无人察觉中失去意义。所以本项目要求:改动 命中 e2e 用例时,同一 PR 写一份 .github/eval-impact/<编号>.json,逐条说明受影响的用例、为什么修订或保留;无对应用例要写 noCaseReason。现在已经积累了 70 多份。
两个演化细节:
- 「命中」只有两种可机械判定的情形:改动路径匹配用例的
touches,或直接改了用例资产。早期还把「合同来源命中」算进来,结果改一行 dev SPEC 就牵出 31 条用例,记录越写越长、信息量越来越低,于是收窄。 - 收窄前有一个更基础的错误:用例条数是 grep 出来的,把步骤 id 也数了进去,报出 118 这种数字;改用加载器重数是 39 条。统计结构信息必须走解析器。grep 出来的数字看起来精确,数的却是字符串出现次数。
SPEC 里还有一句很重要:静态检查证明关联存在,不证明理由正确。 一份格式完美、引用齐全的 json,读起来非常像已经评审过。
四、AI 工程基建:让 Coding Agent 能持续、可审计地交付
到这里,SPEC 和 Evals 讲的都是「该怎么做」。但上面每一条实践都有一个隐含前提:有人(或 Agent)在每一次改动时都记得去做。 在一个六周 600 多提交、主要由 Coding Agent 写代码的项目里,「记得」不是可依赖的机制。AI 工程基建要解决的就是这个问题:把「记得」换成「结构」。
我说的「AI 工程基建」不是 CI 服务器。它指的是 一个 Coding Agent 进入仓库时,所能看到、被约束、被验证、能留下记录的全部环境。在本项目里,它分成五块:
| 块 | 解决什么 | 本项目里是什么 |
|---|---|---|
| GitHub(Issue / PR / CI) | 需求、纠正、验证证据的持久记忆;独立于模型和会话 | Issue 驱动开发 SPEC、PR 模板、eval-impact 门禁、发布证据协议 |
| 根指令(AGENTS.md / CLAUDE.md) | Agent 每轮必读的最小决策集 | 90 行索引 + 硬红线 + 「改了什么 → 跑什么」表,行数由测试卡住 |
| Docs 分层 | 深水区知识按需读,不占每轮上下文 | 「症状 → 文档」索引表,docs/ 深水区,docs/runbook/ 决策与弯路 |
| Coding Agent 工作台 | 把高频多步操作变成可复用、可审计的单元 | hooks(runbook 抄录)、skills(e2e 回归)、commands(重建部署) |
| 命令面 | 每类改动都有一条最窄的验证入口 | make help、make test-quick NAME=x、make ci、make eval-* |
逐块说踩过的坑。
4.1 GitHub 是职责层,不是代码托管
需求和人的纠正落在 Issue,不落在会话里。 需求和纠正是开发依据里最贵、最不可再得的部分,而它曾经只活在长会话的上下文里,会话滚出窗口就没了。现在 Issue 正文固定回答三问:问题与需求是什么、打算怎么做、怎么验证。几条判据都冲着具体事故写:
- 人的修正不能被摘要抹掉。 概括天然丢语气和边界条件。Agent 改正文前重读评论,「原方案 → 新方案及原因」追加成评论。
- 人没说过,就绝不写「用户已确认」。 这是最贵的一句谎,它让下一个人跳过本该做的确认。宁可标成假设。
- 评论是证据,不是授权。 把一句评论读成批准,是最容易发生、也最说不清的越权。
PR 写「未覆盖」。 本项目每个 PR 都有「修改 / 验证 / 未覆盖」三段。前面 #410 的「未覆盖」写了「真实群里会不会只道谢一句要真机看」;#391 写了「代发、OA 审批代办还没有用例」。部分交付用 Refs,完整交付且验收满足才用 Closes。PR 已创建、CI 通过、模型说「完成」,都不能独立证明需求满足。
不自动合并,也要承认合错过。 PR #184(一批语气相关的 skill,23 个文件 +1887 行)合并三小时后,用户发现「不应该合并」。功能本身没错,错的是它进 main 的时机。「PR 过了、检查绿了、合并了」这一串信号 都不包含「这个东西该不该在 main 上」,而这恰恰是最贵的判断。
规范也要能被执行环境否证。 Issue 驱动 SPEC 最初要求 Agent 发的评论首行写 [Agent]。落地后查实 GitHub 没有任何评论级字段能承载来源,同一账号用 gh 发帖与人手发帖在 API 上同构。标记只在正文里、又没有机械消费者,它就是噪音。于是规范推翻了自己(#186)。判据:一条元数据规则,先问「这里谁在读它」。
CI 红先看 annotation。 2026-09-29,Docker workflow 一连几个 PR 都是 fail、各 2 秒,点开是账单问题,job 根本没启动。「没跑」和「跑了没过」不能混:前者不能当代码问题修,也不能当 CI 通过写进 PR。处理方式是本地对试合并结果跑完整 make ci,PR 里如实写「GitHub CI 无结论」。
4.2 根指令:索引,不是百科
根指令(AGENTS.md,CLAUDE.md 是它的符号链接)每轮都注入。它的大小直接是每轮的固定税。本项目在 85 个本机 Coding Agent 会话上实测过:模型生成占活跃时间 83%,测试与门禁只占 1%,每回合平均上下文 225K token。慢在每轮重读上下文,不在跑测试。
三轮收敛的教训:
- 557 → 175 行:拆成「索引 + 深水区」。拆时做的是「搬运 + 去重」,不是「精简」,156 条加粗结论逐条 grep 确认在新位置存活。引用深水区一律用普通 markdown 链接,不用
@docs/xxx.md:@会被当成 import 全量加载,抵消了按需读的全部意义。 - 又长回 276 行:因为收敛判据只写在 commit message 里,没人看得到。修法是 把判据写进文件顶部:「只装 agent 不知道会做出明显更差决定的东西」。
- 再收到 90 行,由测试卡住(#161):
tests/agents-md.test.mjs断言行数上限,并校验「改了什么 → 跑什么」表里引用的测试文件和 make 目标真实存在,防漂移。「现状」一节挪出去:现状会过期,根指令不该装。
两个不显然的点:
- 过期断言比冗余行数危险。 一句「真实容器钉钉链路尚未验收」在已验收之后还留着,会让 Agent 做出「还没验过、可以随便改」的判断。
- AGENTS.md 是唯一源,CLAUDE.md 做符号链接。 曾经以为两份读者不同就该分开写,后来发现 Codex 只读 AGENTS.md,把交付规则放进 CLAUDE.md 等于另一个 Coding Agent 看不见它们。被种进员工运行时的那份操作手册另起名字,不撞名。
4.3 Docs:按症状索引,把「为什么」写进版本库
根指令里那张表的左列是 症状,不是主题:「钉钉不回、丢一半、前缀寻址不生效」→ 读哪篇;「检索答错、加语料」→ 读哪篇。Agent 遇到问题时手里有的是症状,按症状找文档最快。
docs/runbook/ 是另一类文档:它记的不是现状,是 被推翻的方案和弯路。每轮交互由 Stop hook 自动抄进 gitignored 的 raw/,会话结束时后台提炼成三份签入稿(时间线 / 决策与教训 / 提示词),人读过再提交。这套管线的价值,是把「代码为什么是现在这样」从某个人的脑子里搬进版本库,并用 git log 对照审计覆盖缺口(细节见 Runbook:把「代码为什么是现在这样」写进版本库)。
它对 Coding Agent 的意义在于:Agent 没有记忆,它每次进仓库都是新人。新人最容易做的事,就是把一个看起来奇怪、实际有血泪原因的写法「顺手改回正常」。 runbook 里一百多条「为什么」,就是挡这个的。
4.4 Coding Agent 工作台:hooks、skills、commands
- Hooks 管「每次都必须发生」的事。 runbook 抄录挂在 Stop / SessionEnd 上,纯 node、毫秒级、不调模型,因为它必须每轮都成。提炼要调模型、可能失败、可以重跑,所以分成另一个脚本。失败代价不同的两件事,不塞进同一个进程。
- Skills 管「多步、有判断、容易做错」的事。 「最新代码回归一下」由 e2e-regression skill 接住:造/重置环境、体检、按层/类/改动挑用例、逐条跑、出报告。热身、互斥锁、清收件箱这些加固都沉淀在 skill 背后的脚本里,不靠 Agent 每次想起来。
- Commands 管「固定动作」。
/redeploy-assistant本机重建并重启 router 与 assistant。
Hooks 还有一种更重要的用法:约束 Coding Agent 自己的行为。 检索优化那个 issue(#5)是个 5 阶段方案。做完第 2 阶段时,基线刚量出来(answer 44.1%),四个数字齐全、测试全绿,看起来非常像一个可以交付的节点,Agent 准备收工。而真正要抬的那个数,一个百分点都还没动。拦住它的是一个 session 级 Stop hook(/goal):每次想结束时对着目标检查,它当场指出「5 个阶段只做完 2 个,任务清单第 3 条还是 in_progress」,把活顶了回去。最后 answer 从 44.1% 抬到了 100%。
阶段性成果看起来像终点。越是把前两阶段做扎实,越容易觉得已经交付了东西,靠自觉挡不住。
用法上的关键是 把验收条件写进目标,而不只写任务名:「issue #5 五个阶段全部完成」比「fix issue #5」拦得住更多东西。这和 Issue 里写「怎么验证」、PR 里写「未覆盖」是同一件事:完成的判据要在动手之前写下来,而且写在 Agent 收工时一定会被检查的地方。
一条反面教训:曾经有个只有 56 行、跑不出任何结论的 skill,后来被删了。半截能力比没有更误导,调用它的人会以为分析做过了。
另一条:派发无头 Coding Agent 前,要实测它 默认读什么。无头 claude 在 --setting-sources=project 下读不到 user 作用域的登录态;OpenCode 默认不读工作区 README,把模拟工作区说成「测试夹具」,e2e 断言落空。症状都像「模型答错」,根因是读取路径没对齐。
4.5 数字员工自己也站在这套基建上
本项目里,dev 员工本身就是一个能在钉钉里被 !dev 召唤、派发 Coding Agent、改其它员工的数字员工。它用的是同一套基建:
employee-evolution插件的工具链是list / inspect取证 →propose保存方案 →get回读 →apply应用,方案落成 SPEC / EVAL / personaExtra 的完整版本,带事件证据和乐观锁;- 应用记录里写着
behaviorVerification: not_run:保存配置和行为验收是两件事; - 行为验收交给前面的回放回归:候选 vs 线上,退化就拦。
也就是说,当 Agent 开始改 Agent,SPEC、Evals、基建这三件事没有变,只是执行者从人换成了另一个 Agent。这是这三件事最强的论据:它们不依赖执行者是谁。
五、三者怎么咬合:一次改动的完整路径
把前面的东西串起来,一次行为改动在本项目里走的是这条路:
真实现象(群里一句没回 / 轨迹里一次违规)
   │
   ▼
Issue:问题与需求 / 打算怎么做 / 怎么验证       ← 基建:人的需求和纠正有持久载体
   │
   ▼
SPEC 段落改一句(同一 PR)                     ← SPEC:唯一判据,运行时和评测共同读
   │
   ▼
EVAL 用例:真实样本(脱敏)+ 合成反例           ← Evals:反例定义边界
   │
   ▼
实现 + make test-quick → make ci                ← 基建:最窄验证 → 全量门禁
   │
   ▼
全集 bench / 回放对比:量副作用,不只看目标用例   ← Evals:误开口单列,REPEAT 多数
   │
   ▼
eval-impact 记录 + PR「修改 / 验证 / 未覆盖」    ← 基建:既有资产影响面显式化
   │
   ▼
人评审、人合并;真机验未覆盖的那部分             ← 基建:不自动合并
   │
   ▼
runbook 提炼弯路(长版判据为什么弃用)           ← 基建:「为什么」进版本库
# generated by hugo AI
#409 / #410 一个 PR 改了 8 个文件、+70 行:SPEC 5 行、eval 用例与标注 7 条、eval README 12 行、实现 3 行、测试 6 行、 eval-impact 记录 39 行。实现只占 3 行。 这个比例不是偶然,它就是数字员工工程的真实形状:行为改动本身往往很小,大部分工作量在「说清楚该做什么」和「证明确实这么做了、且没弄坏别的」。
六、落地清单
SPEC
- 每个员工一份 SPEC,进版本库,是行为的唯一事实来源;每节挂 Issue 号
- 改行为必须在同一 PR 改 SPEC;计划和历史文档不代表现状
- 判据让运行时和评测共同读取,不各写一份
- 每个有副作用的能力,分开写「触发(模型)」和「授权(代码,fail-closed)」;措辞约束不当承重墙
- 每个行为写「判不出来时怎么办」,并按失败代价落在谁身上选 fail-closed 还是 fail-safe;残余风险写出来
Evals
- 分层,永不合并成一个分数;离线层秒级可单跑,真机层不叫 eval
- 标签只认 SPEC,不用历史行为、不用模型判决
- fail-open 与 fail-closed 分开计数
- 模型判据类评测必须重复采样;先验证
temperature/seed在你的模型上起不起作用 - 改判据跑全集,不只跑目标用例;每条新判据配反例
- 回放回归:候选 vs 基线,删用例不能让候选变好
- 依赖模型「看到了什么」的能力,断言可观测的中间量(如 image block 数),守卫按代码路径各写一条
- 运行时升级走三段验证:配置组装 → 真起进程 → 真机回读;反向核对上游新默认值
- e2e 检查「失败方向是绿」的情形:空集、只测一问、只数回复数
- 改行为时显式说明既有用例受不受影响;统计用例走解析器,不 grep
AI 工程基建
- 需求、纠正、验收落在 Issue;不写「用户已确认」,除非人真说过
- PR 写「未覆盖」;
Refs与Closes分开用;不自动合并 - 根指令是索引:判据写在文件顶部,行数和引用由测试卡住,主动清理过期断言
- 一份根指令,其余做符号链接,让所有 Coding Agent 读到同一份
- 文档按症状索引;深水区用普通链接,不用
@自动展开 - 弯路和被推翻的方案进版本库(runbook),由 hook 自动抄录
- 多阶段任务用 Stop hook 写下验收条件,挡住「阶段性成果像终点」的收工
- 高频多步操作做成 skill,跑不起来的半截 skill 删掉
- CI 红先分清「没跑」和「跑了没过」
结语
回到开头的问题:做好一个钉钉数字员工,最重要的是什么?
模型会越来越强,框架会被吞掉,今天的很多插件明天会变成模型的默认能力。但下面三个问题永远需要有人回答,而且答案要能存下来、能被检查、能被下一个 Agent 读懂:
- 它该做什么? —— SPEC
- 怎么知道它做到了,而且没弄坏别的? —— Evals
- 怎么让上面两个答案在第 600 个提交之后仍然是对的? —— AI 工程基建
前两个决定了数字员工今天好不好;第三个决定了它下个月还好不好。
案例细节已脱敏,数字取自仓库当时的提交、PR 与 runbook 记录。