先说一类很常见的翻车现场。一个数字员工被问「把这份报销单转给张三的直属主管审批」,它很自信地查了通讯录,拿到一个名字,发过去了。结果那个人三个月前就调岗了,张三现在的主管是另一个人。报销单卡在一个已经不管这摊事的人那里,没人报错,日志全绿——只是这件事从此没人推进。
问题不在模型笨。模型很聪明,它把「查主管」这个动作完成得干净利落。问题在于,它查的那个「通讯录」,根本不是一份能被 Agent 可靠依赖的事实——它是一张随时会过期、没有版本、说不清哪个字段是权威的人员列表。
几个月前我在 Palantir 从本体长到 Agent,我们从 Agent 长回本体 里下过一个判断,下得很痛快:
Ontology 最难建的那个稳定核心——身份、关系、权限边界、审计证据——组织平台手里本来就是现成的:工号是身份,组织图谱是关系,审批链是权限边界的活体实现,审计日志是决策证据。
那篇讲的是路线:为什么组织平台可以反着走,先让 Agent 以数字员工的身份上岗,再从它的日常工作里长回本体。但路线讲完,有个工程问题被我一笔滑过去了——从钥匙串到本体,中间那道编译,具体怎么做?
「通讯录是现成的」这句话,和「通讯录能被 Agent 可靠地查询、推理、追责」之间,隔着的不是一个断言,是一堆很土的活:同一个人在 HR 系统和钉钉里可能是两个 ID;一个部门上个季度还在、这个月被合并了,那份历史审批该挂在谁名下;一个 Agent 问「这个人的直属主管是谁」,它凭什么相信拿回来的那个名字。开头那张卡住的报销单,就死在这堆活里。
这篇就把这道编译拆开写。核心判断只有一句:企业知识不是检索出来的,是编译出来的;而且要从最土的那一层开始编译——可验证的事实。
一、为什么这不是再来一次知识图谱项目
先划清界限,因为「企业本体」这四个字,很多企业听了会条件反射。
我在 企业知识库新范式:从一亿预算到人在回路 里算过传统知识图谱项目的成本结构:数据采集 10%、清洗 15%、知识标注 40%、图谱构建 15%、应用开发 10%、持续维护每年 10%。那 40% 的标注是持续性成本——新产品上线、新流程发布、新政策出台,图谱就要更新,标注团队不能解散,得长期养着。项目死在这里,不是死在技术,是死在知识获取瓶颈。
编译和标注的区别,恰好就在这个瓶颈上:
| 传统知识图谱 | 企业知识编译器 | |
|---|---|---|
| 结构化事实怎么进来 | 人工标注、人工校验 | 代码和规则编译,源系统就是权威 |
| 非结构化知识怎么进来 | 人工抽取、人工录入 | LLM 提取候选,人只审不写 |
| 质量靠什么保证 | 标注员的一致性 | 来源、时间、版本、权限四个字段 + Evals |
| 更新靠什么触发 | 项目排期 | 源系统变更事件 + 回归评测 |
所以这套基础设施可以有个更准确的名字:Enterprise Knowledge Compiler(企业知识编译器)。
它的目标不是产出一张漂亮的图。目标是把分散在钉钉、HR 系统、文档、审批和业务系统里的信息,编译成 Agent 可以查询、推理、执行任务,并通过反馈持续修正的组织上下文。
我在 我的知识编译器,把自己的源代码编译没了 里为个人知识库付过一次学费:编译器每拿走一样东西(正文、出处),系统就少一样能验证自己的东西。企业版的教训会更贵,因为个人编译器错了只坑自己,企业编译器错了会让一个持有组织凭据的 Agent 拿着错的事实去做事。所以下面每一层的设计,都在回答同一个问题:这条知识凭什么可信,出错了能不能追回去。
二、企业知识编译的分层模型
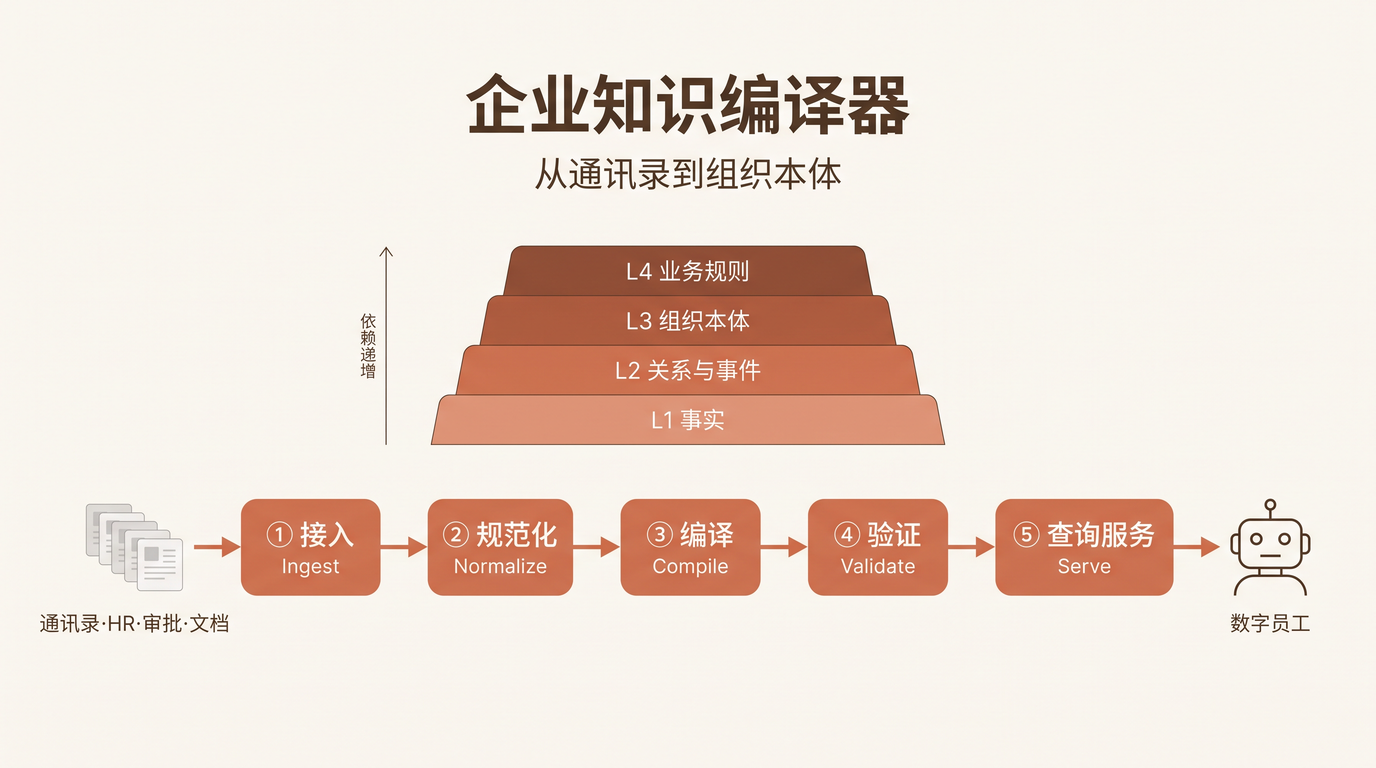
从事实层开始,先编译企业中可验证的事实,再逐步编译关系、事件、本体和业务规则。
L1 · 事实层(Facts)
回答:哪些实体存在?它们有哪些可验证的属性?
例子:
- 员工 ID、姓名、在职状态
- 部门 ID、组织 ID
- 岗位、汇报关系
- 客户 ID、项目 ID、合同状态
事实层不是简单地存数据,而是把数据编译成有类型、有来源、有时间语义、可验证的事实。
例如:
subject:
  type: Person
  id: E123
predicate: member_of
object:
  type: Department
  id: D456
valid_time:
  from: "2026-01-01"
source:
  system: HR
  record_id: "hr-987"
# generated by hugo AI
生产实现还应补充采集时间、版本、权限标签、来源可信度及失效时间等字段。
L2 · 关系与事件(Relations & Events)
回答:实体之间有什么关系?关系或状态何时发生变化?
例子:
- 员工加入或离开部门
- 汇报关系调整
- 员工入职、离职、转岗
- 审批发起、通过或拒绝
- 项目成员变更
需要区分 当前状态 和 历史事件。只覆盖当前值会丢失历史;只保存事件又会让常见查询变复杂。通常应保留事件记录,并维护可查询的当前状态或时间点投影。
L3 · 组织本体(Ontology)
回答:企业里有哪些实体类型、关系类型、角色和业务概念?它们之间允许什么关系?
例子:
Person member_of DepartmentDepartment belongs_to OrganizationPerson reports_to PersonPerson holds_position PositionPerson owns Project
本体不是简单的知识图谱,而是企业领域的类型系统和语义契约:它定义概念、关系、约束,以及不同系统的数据如何映射到这些概念。
L4 · 业务语义与规则(Business Semantics & Rules)
回答:为什么这么做?在什么条件下应该采取什么行动?
例子:
- 岗位职责和任务边界
- 商机升级规则
- 审批策略
- 业务 SOP
- 风险判断与升级机制
规则应尽量保留来源、适用范围、生效时间、版本和审批状态。不能把模型根据文档推测出来的规则直接当成已批准的企业制度。
底层事实支撑上层语义。所有层都应尽可能保留来源、时间、版本和权限信息。
这四层是依赖关系,不是并列关系。L4 的一条「商机金额超过 50 万必须二级审批」,要能追到 L3 里 Approval requires_approver Position 的约束,追到 L2 里那次审批实际发生的事件,最后追到 L1 里那个人当天在不在职。断在哪一层,那一层以上的知识就从「我知道」退化成「我记得好像是」。
三、第一批应该编译什么?
建议从 组织事实底座 开始,按依赖关系逐步扩展。
| 顺序 | 数据域 | 首批需要编译的内容 |
|---|---|---|
| 1 | 组织通讯录 | 员工、部门、组织、岗位、汇报关系 |
| 2 | 身份与权限 | 账号、组织身份、角色、数据访问范围 |
| 3 | 工作事实 | 消息、日程、待办、审批、会议 |
| 4 | 业务对象 | 客户、商机、项目、合同、产品 |
| 5 | 组织知识 | 岗位职责、SOP、制度、业务规则 |
| 6 | 组织决策 | 决策依据、决策记录、执行结果 |
第一阶段最关键的是把 人、组织、角色、关系 编译清楚。
通讯录不仅是人员列表,它是企业本体的第一张骨架图。后续才能把客户、项目、任务、审批等业务对象可靠地关联到员工和组织上。
这也是 #358 那句「钥匙串是现成的本体」的工程含义:不是说要拿通讯录当本体用,是说通讯录提供了本体最难获取的那部分——已经在被组织日常使用、因此不会过期的身份与关系事实。业务对象可以自己建,但一个人到底向谁汇报,只有组织系统说了算。
四、知识编译器的五个阶段
1. Ingest · 数据接入
从钉钉通讯录、HR 系统、审批、文档等系统获取原始数据。
要求:
- 保留原始记录与来源标识
- 支持全量导入和增量变更
- 记录采集时间与源系统版本
- 明确每个数据源的访问授权
2. Normalize · 规范化
统一不同系统中的 ID、实体类型、字段、时间格式、枚举和身份映射。
要求:
- 尽可能使用稳定的业务 ID,而不是姓名作为主键
- 识别跨系统重复实体
- 处理字段缺失和不同系统的枚举差异
- 对无法确定的身份映射保留待确认状态
3. Compile · 编译
根据类型定义和编译规则,把数据转换成事实、关系、事件,并逐步映射到企业本体。
建议采用混合方式:
- 确定性数据: 用代码和规则编译,例如部门 ID、员工状态、组织归属。
- 非结构化知识: 用 LLM 提取候选,例如岗位职责、SOP 中的规则。
- 复杂语义关系: 让 LLM 提出候选关系,由规则、来源证据或人工审核确认后发布。
LLM 的输出应被视为候选结果,而不是自动成为权威事实。
                  Compile 阶段的三条路
  ┌────────────────────────────────────────────────────────┐
  │ 确定性数据(部门 ID、员工状态、组织归属)               │
  │   → 代码 + 规则编译,直接成为权威事实                   │
  ├────────────────────────────────────────────────────────┤
  │ 非结构化知识(岗位职责、SOP 里的规则)                  │
  │   → LLM 提取候选,带来源与置信度,等人审                │
  ├────────────────────────────────────────────────────────┤
  │ 复杂语义关系(谁实际负责这个客户)                      │
  │   → LLM 提候选 + 规则/来源证据/人工确认后发布           │
  └────────────────────────────────────────────────────────┘
     候选 ≠ 事实。越过人审直接入库,等于把模型的推测
              变成企业的制度。
# generated by hugo AI
这条分工线和我在 做好一个钉钉数字员工,只有三件事:SPEC、Evals 和 AI 工程基建 里讲的是同一件事:哪些交给模型判断、哪些必须由代码确定性判定。 那篇讲的是单个数字员工的行为边界,这篇讲的是喂给它的事实从哪来。同一个原则的两个尺度——模型判错只影响「会不会去试」,确定性的那部分决定「能不能成功」。
4. Validate · 验证
检查:
- 实体引用是否存在
- 关系类型是否符合 Schema
- 组织归属和汇报关系是否冲突
- 时间区间是否一致
- 来源是否可信、是否可追溯
- 数据是否允许被当前用户或 Agent 访问
- 本体升级是否破坏既有查询和规则
发现冲突时应保留来源与冲突状态,不要让模型随意选一个答案作为真相。
5. Serve · 查询服务
为 Agent 提供统一查询能力:
- 实体查询:某员工当前属于哪个部门?
- 关系查询:某员工的直属主管是谁?
- 聚合查询:某部门有多少在职员工?
- 时间点查询:截至某个日期,员工属于哪个部门?
- 语义检索:某岗位的职责和相关 SOP 是什么?
- 权限过滤:当前用户是否有权查看目标信息?
注意最后一条不是可选项。一个能查到全公司组织信息的 Agent,本身就是一个越权面——权限过滤要做在查询层,不能指望调用方自觉。这和数字员工的授权门禁是同一条纪律:能力可以有,放行必须判。
五、事实、本体和知识存储如何分工?
这些是逻辑职责,不一定需要部署成五套独立系统。
| 层次 | 核心职责 | 可选技术形态 |
|---|---|---|
| 原始数据层 | 保留原始记录与来源 | 数据库、对象存储 |
| 事实层 | 存储规范化、可验证的实体与事实 | 关系数据库、版本化事实表 |
| 本体层 | 定义类型、关系、约束与语义 | Schema、类型系统、关系索引 |
| 知识层 | 存储文档片段、解释、SOP 和非结构化知识 | 文档存储、全文索引、向量索引 |
| 查询层 | 统一执行事实查询、关系遍历、语义检索 | API、查询引擎、检索服务 |
关于 OpenViking 这类上下文数据库
市面上已经出现一批面向 Agent 的上下文数据库,比如字节火山引擎开源的 OpenViking——把记忆、资源、技能统一成 viking:// 虚拟文件系统,支持 L0 / L1 / L2 分层加载和目录递归检索。可以评估用它承载知识层的存储与检索。但有一条判断要先立住:不要假定向量检索本身能够保证事实准确性、一致性或权限正确性。
向量检索擅长的是「找相似」。它回答不了「这个人现在到底在哪个部门」——因为正确答案不取决于语义相似度,取决于哪条记录是权威的、在哪个时间点有效、当前查询者有没有资格看。这三件事都是确定性的,都得有明确的数据模型、权威来源、版本策略和查询规则。
所以分工是:事实层用确定性的方式编译和查询,知识层可以用语义检索。 OpenViking 是否适合某一层,应通过实际查询需求、过滤能力、更新机制和一致性要求做 PoC 验证,而不是按技术热度选。
有意思的是,OpenViking 团队为了解决「Agent 记得太多、新旧矛盾」的问题,据其技术文章,把记忆拆成了两层:Event 像日记,逐条记下每次变化(三个月前定预算 50 万、上周改成 40 万);Entity 像档案,从日记里整理出这件事现在的样子(当前预算 40 万)。这几乎就是我 L2 层说的「保留事件记录 + 维护可查询的当前状态投影」——连一个专门做上下文数据库的团队,为了让 Agent 记得对,也收敛到了同一个结构。这不是巧合:只要你想让一个系统既答得出「现在是什么」,又追得回「怎么变成现在这样」,就绕不开事件流 + 状态投影这个组合。 差别只在于,OpenViking 用它管对话记忆,我们用它管组织事实——而组织事实一旦记错,代价是一张报销单发给了不再管事的人。
六、通讯录 PoC:最小本体定义
以下 Schema 是起点,实际实现需要按组织系统的数据模型补充约束。
entities:
  Organization:
    id: string
    name: string

  Department:
    id: string
    name: string
    parent_department_id: string

  Person:
    id: string
    name: string
    status: string

  Position:
    id: string
    title: string

relations:
  - member_of: [Person, Department]
  - belongs_to: [Department, Organization]
  - reports_to: [Person, Person]
  - holds_position: [Person, Position]
# generated by hugo AI
Schema 本身不难,一天就能写出来。真正决定这个 PoC 成不成的,是下面这些边界条件——它们全都不是技术问题,是组织现实:
- 多组织、多租户和员工跨组织身份
- 兼任、矩阵汇报和代理关系
- 部门合并、拆分与历史组织树
- 员工离职后历史记录的保留
- 字段和关系的权威来源
- 哪些事实可以被哪些角色或 Agent 查询
第三条最容易翻车。一个部门被合并,如果只有当前状态,那上个季度挂在这个部门下的审批、会议、项目就集体失去归属;如果只有事件流,「现在有多少人」这种最常见的查询就得每次重放历史。所以 L2 那句「保留事件记录 + 维护可查询的当前状态或时间点投影」不是架构洁癖,是被这类问题逼出来的。
七、用 Evals 验证编译结果
第一版完成后,建立固定的评测集:
- 「张三属于哪个部门?」
- 「销售部有多少在职员工?」
- 「张三的直属主管是谁?」
- 「截至上个月月底,张三属于哪个部门?」
- 「当前用户是否有权查看张三的组织信息?」
评测不仅检查答案是否正确,还要检查:
- 是否能追溯到来源记录
- 时间点查询是否正确
- 数据缺失或冲突时是否明确表达不确定性
- 未授权查询是否被拒绝
- 数据更新后结果是否及时变化
- 本体或 Schema 升级后,既有用例是否仍然通过
真正的验收标准不是成功生成了一张知识图谱,而是 Agent 能稳定、可追溯、符合权限地回答这些问题。
这五条问题看着朴素,但它们各自守着一个失败方向:第 1 条守事实正确性,第 2 条守聚合,第 3 条守关系遍历,第 4 条守时间语义,第 5 条守权限。少任何一条,都有一整类故障是绿的。 这和 私有 Eval 是终极护城河 里说的判据分层是同一个道理:判据不能合并成一个总分,否则出了问题分不清是哪一层退化。
上面那六条附加检查里,最容易被漏掉、也最贵的是最后一条——「本体或 Schema 升级后,既有用例是否仍然通过」。本体升级会静默改变既有查询的语义:字段拆了、关系换了方向、枚举加了值,编译器和 Schema 都不会报错,只有跑一遍评测集才知道哪些用例已经悄悄失效。所以 Evals 不只是验收工具,它是本体版本的回归闸门——这和 做好一个钉钉数字员工,只有三件事 里「改判据跑全集」是同一条纪律,只不过这里跑全集的对象从行为换成了本体。
八、建议的落地路线
Phase 1:组织事实底座
- 接入通讯录和组织架构数据
- 统一员工、部门、组织和岗位 ID
- 定义最小本体与事实格式
- 保留来源、有效时间、版本和权限
- 实现当前状态与历史时间点查询
- 建立第一批 Evals
Phase 2:工作事件
- 接入日程、待办、审批、会议等事件
- 统一事件类型和参与者关系
- 将事件关联到员工、组织和业务对象
- 支持事件回放与当前状态投影
Phase 3:业务对象与组织知识
- 编译客户、商机、项目、合同等业务实体
- 从文档和 SOP 中提取知识候选
- 建立业务对象、岗位、任务和规则之间的关系
- 为 LLM 提取结果增加审核、版本和回归评测机制
Phase 4:组织学习闭环
- 记录 Agent 的任务、依据、执行结果和人工反馈
- 将反馈转化为待审核的知识或规则变更
- 通过 Evals 验证变更是否提升任务质量
- 经授权发布新版本,支持回滚
四个阶段的顺序不能倒,因为它们的信息价值密度是递增的,而可信度要求也是递增的。Phase 1 错了,Agent 答错一个部门;Phase 4 错了,一条被自动提炼出来的「规则」可能变成整个组织的制度。越往后,人审的位置越不能省。
Phase 4 也就是 #358 说的那条反向路线真正闭合的地方:数字员工日常工作里的驳回、例外、权限申请,经过审核变成知识变更,再经过 Evals 验证才发布。开模费不用驻场付,但验收这道关一分不能少。
结语
先把通讯录编译成可靠的组织事实底座,再逐步扩展到工作事件、业务对象、组织知识和决策规则。
核心工程原则:
- 事实优先: 先确保数据可验证,再追求语义丰富。
- 确定性优先: 结构化事实用代码编译,LLM 负责理解与提出候选。
- 来源优先: 每条关键事实都应可追溯,冲突不能被静默覆盖。
- 时间与权限是一等属性: 不能只存一个当前值,也不能脱离访问控制提供知识。
- Evals 驱动演进: 每次编译规则或本体变更,都要验证 Agent 的真实查询与任务表现。
最终要构建的不是一次性的知识图谱,而是一套能够持续吸收企业数据、演进企业本体,并为数字员工提供可靠上下文的 企业知识编译基础设施。
回到开头那句被我滑过去的判断。「钥匙串是现成的本体」是对的,但它只说对了原料。原料到本体之间那道编译,才是组织平台真正的工程量所在——而且这道工程量,模型厂商替不了你,因为它编译的是你这家企业「实际上怎样工作」。
一个问题留给你:你的组织里,「这个人的直属主管是谁」这个问题,今天有几个系统能答,答案一致吗?如果不一致,Agent 该信哪一个——这个决定,现在是谁在做?
欢迎留言聊聊。