Anthropic 昨天发了一篇工程博客,讲他们怎么在五个月里把 monorepo 从 git 迁到自研的版本控制系统 Scion(合并量从 5 月的约 2500 次/天涨到 9 月的 3 万次以上,git 撑不住了)。数字都很惊人,但我停下来的是里面一句关于人的话。
他们说,参与这个项目的所有工程师,现在都认为 Claude 写代码比他们自己强。
按理说这话讲完,工程师就该没价值了。可紧接着他们写:「很多时候我们发现,工程师的作用就是告诉 Claude『no』。」
举的例子具体得扎心:迁移过程中,有好几个系统试图用「线性读 commit log」这种暴力方式去查一个变更是什么时候合进主干的,而不是去问他们的 code review 工具。能跑,结果也对——但它违反了系统的核心约束,是一个「本就不该被允许存在」的模式。还有一次,对抗性 review 对另一个内部服务过度防御,Claude 就照着加了一大堆多余的校验和复杂度。
我发现这两件事拼在一起,恰好回答了一个我最近一直在想的问题:「AI 时代品味最值钱」这句话,到底在说哪一种品味?
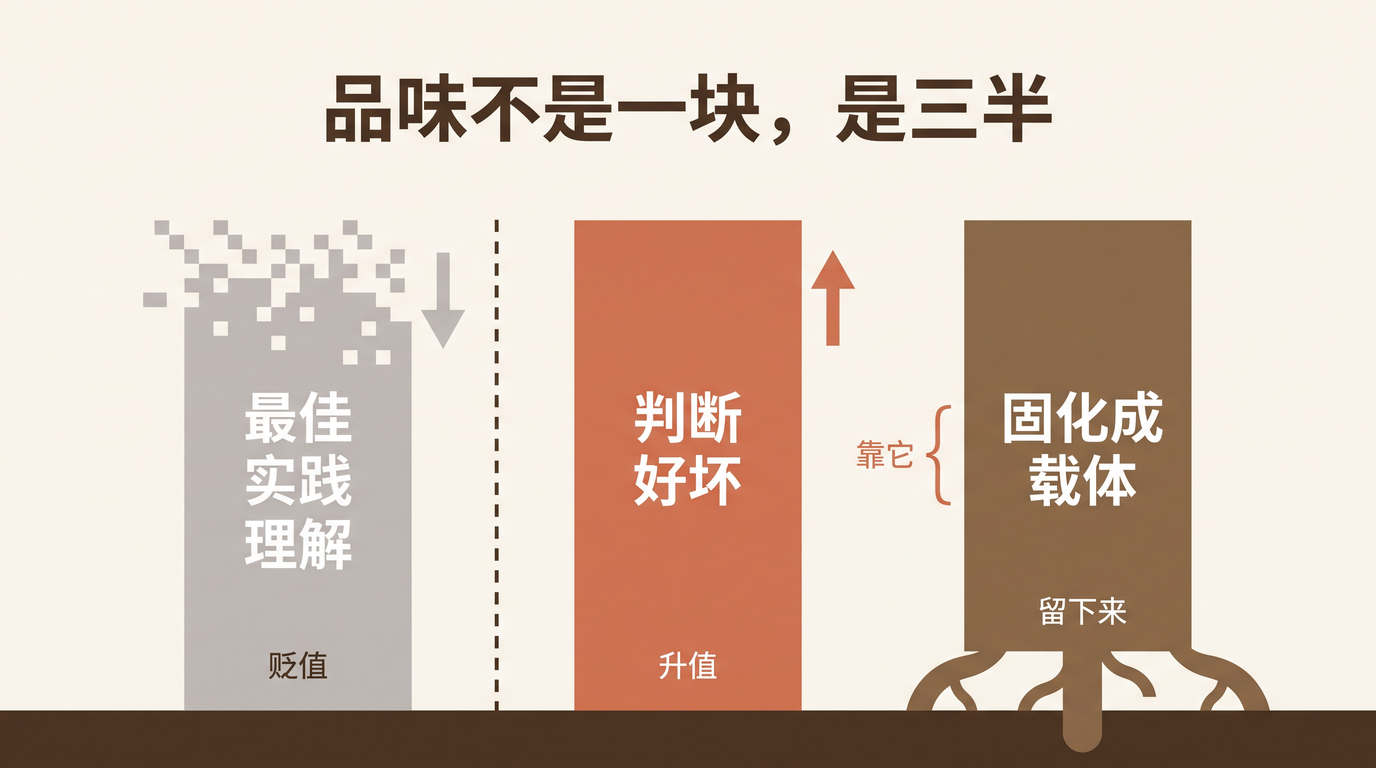
一、把那句话拆开
我给自己下过一个定义:
人的品味 = 对一项任务的最佳实践的理解,以及判断结果好坏的能力。
两半。写下来的时候觉得很顺,因为它符合直觉:一个有品味的工程师,既知道这事儿该怎么做,也能一眼看出做得对不对。
但把这两半放到 Anthropic 那个场景里对一下,问题就出来了。
「知道这事儿该怎么做」——Claude 知道得比他们所有人都多。它装着几乎所有领域的最佳实践,能在没有任何额外指令的情况下,把一个手写的 git-to-Scion 摄入管道重写成内存占用低 20 倍、速度快 4 倍的版本(Anthropic 自报口径),而且保住了所有关于摄入顺序和数据结构的隐式不变量。
「一眼看出做得对不对」——这个 Claude 干不了。那几个用线性读 commit log 的系统,每一个都能跑、每一个测试都过、每一个结果都正确。判断「这个模式本就不该存在」的,是人。
所以这个定义里的两半,在 AI 下的命运是相反的:
| 最佳实践的理解 | 判断结果好坏 | |
|---|---|---|
| 谁更强 | 模型 | 人 |
| 趋势 | 贬值 | 升值 |
| 为什么 | 模型装着全领域的最佳实践,且更新比人快 | 模型能生成任何方案,但不能替你选择哪个不该存在 |
| Anthropic 的实证 | 全员承认 Claude 写代码更强 | 工程师的价值=告诉 Claude「no」 |
我在 代码是 AI 写的了,品味住在哪里 里写过「品味从代码搬到了选择里」,在 Eval 是品位 里写过「工程决定方差下限,品位决定天花板」。那两篇讲的都是右边这一列。这篇要补的是左边——以及一个更麻烦的事实:很多人以为自己有品味,其实只拥有左边那一半。
二、左边那半为什么在贬值
有人会说:模型知道的是 通用 最佳实践,而我们这里怎么做,模型不知道。那部分仍然是人的价值。
这个反驳对了一半,而且对的那一半恰好证明了它错的那一半。
「我们这里怎么做」确实模型不知道。但如果你拥有的只是一份「我们这里的做法清单」,它的保质期正在急剧缩短。我在 从 0.0% 到 39.2%:没人通知你的那次集体过期 里记过一件事:Anthropic 发布 Claude Haiku 5.5 那天,官方 benchmark 表上 Terminal-Bench 4.0 一栏从上一代 Haiku 4.5 的 0.0% 跳到 39.2%——分数是模型的,后果却是我的:过去一年里所有为「Haiku 4.5 做不到」而写的补偿代码,从那天起集体变成负资产。没有人通知我,没有一条报警,我的代码一行没改。最佳实践是有保质期的,而且过期时不响。
清单会过期。不会过期的是另一样东西:知道这条最佳实践 为什么 是这样、什么条件下该打破它。
Anthropic 那个例子正是这个分界。用线性读 commit log 查合并时间——这在很多场景下是完全合理的做法,甚至是一种最佳实践(简单、直接、不依赖外部服务)。工程师喊停不是因为「我们这里的规矩是不能这么写」。原文只说 agent「违反了核心系统约束」,没说约束具体是什么;我的读法是:一个 monorepo 在每天 3 万次合并的量级上,任何线性扫历史的操作都会变成灾难——而这个约束,不在任何一份最佳实践清单里。
清单可以被模型背走,清单背后的约束不能。 而「知道约束」这件事,本质上已经是右边那一半了——它是判断,不是记忆。
还有一层更狠的:组织内部那些「我们这里的最佳实践」,正在被 agent 自己写进 runbook 和 skill。我在 做好一个钉钉数字员工,只有三件事 里写过这个机制——每一轮交互由 hook 自动抄录,会话结束时提炼成签入稿,把「代码为什么是现在这样」从某个人的脑子里搬进版本库。搬进去的那一刻,它就成了模型下一轮能读到的上下文。
你以为攥在手里的组织知识,正是最容易被外化、被固化、被模型消费的那一类。
三、右边那半为什么在升值
右边这一半升值的原因,我在 执行变便宜了,过滤器没有 里论证过:执行配额消失之后,一个想法从冒出来到被处理不再需要排期,于是稀缺的东西从「做出来」变成了「决定该不该做、做得对不对」。
Scion 那篇博客给了这个判断一份很硬的量化背景(均为 Anthropic 自报口径):五个月、7 个人的团队,同时建了 Scion 和 code review 工具 Antique,外加半打相关系统,完成整个 monorepo 迁移——而这期间每天合并的代码量涨了 10 倍。
这个比例说明的不是「人少了」,而是 人的工作被压缩到了纯判断:他们在文中写,团队仍然 review 每一个变更请求,但「他们现在审查的是变更的 意图,而不是逐行读代码」。
审意图,就是右边那一半在干活。它需要的不是「我知道这段代码该怎么写」,而是「我知道这个变更想干什么、它和系统的核心约束冲不冲突、冲突了该不该拦」。
这里必须回应一个更强的反方:判断这一半,不也在被自动化吗? Anthropic 自己就大量使用对抗性 review,让模型去挑模型的毛病;业界还有一整套 LLM-as-judge 的做法。如果判断也能自动化,那它凭什么升值?
答案在同一篇博客里,而且是 Anthropic 自己写的:对抗性 review「在很多方面极其有效,但也可能近视」——那次对内部服务的过度防御,正是自动化 review 提出假想风险、Claude 照着加了一大堆多余校验和复杂度,最后是 人来把它拽回来的。
也就是说,自动化 review 会生产出一类新的错误:它判断的分辨率很高,但判断的依据是假想的。能识别「这个担心不值得付这个复杂度代价」的,仍然只有知道系统真正要防什么的那个人。判断可以被辅助,不能被移交——因为移交之后,没有人对「拦错了」负责。
而且这一半还有一个左边永远不会有的性质:它是不可压缩的。代码可以让模型写,清单可以让模型背,但「这个不该存在」这句话必须有人负责——因为它是一道闸门,闸门后面是整个系统的完整性。Anthropic 那句「工程师的作用就是告诉 Claude no」,翻译成组织语言就是:判断的责任无法外包,因为责任本身需要一个能承担后果的主体。
四、被漏掉的第三半
到这里,我那个两半的定义还缺一块。
一个有品味、却从不把判断写下来的人,在 agent 尺度下 等于没有品味。
这不是修辞。原因很机械:agent 绕不开的是 eval,不是你脑子里的判断。你的品味如果只活在脑子里,它影响不了任何一次模型的行为——模型不会在生成一个线性扫 commit log 的方案时,突然想起某位工程师觉得这样不优雅。
所以第三半是:把判断固化成可复用载体的能力。
Anthropic 的做法是把判断写进系统约束和 code review 工具的语义规则里(他们的 review 工具能表达复杂的语义约束,区分「只改注释」和「敏感的逻辑变更」,让人只看最要紧的那些)。我在 #350 里的说法是「品位本身不可教,但 eval 集可以留」——同一件事。
三半合起来:
        人的品味
   ┌────────────────────────────────────────────┐
   │ 1. 对最佳实践的理解                        │
   │    趋势:贬值                              │
   │    原因:模型装着全领域清单,且更新更快    │
   │    残留价值:知道「为什么」和「何时打破」  │
   │             (而这已经是第 2 半)          │
   ├────────────────────────────────────────────┤
   │ 2. 判断结果好坏                            │
   │    趋势:升值                              │
   │    原因:生成不再稀缺,选择才稀缺          │
   │    形态:告诉 Claude「no」、审意图不审行   │
   ├────────────────────────────────────────────┤
   │ 3. 把判断固化成载体                        │
   │    趋势:从「加分项」变成「生存前提」      │
   │    原因:agent 绕不开 eval,绕得开你的脑子 │
   │    形态:eval 集、语义规则、runbook、SPEC  │
   └────────────────────────────────────────────┘
   1 在被吃掉,2 在涨价,3 决定 2 能不能留下来
# generated by hugo AI
第三半是最容易被忽略的,因为它看起来像工程活,不像品味。但恰恰是它决定了第二半能不能在组织里活下来:一个人判断再准,如果从不写进 eval,他的品味就随他离职归零;一个团队判断再一致,如果不固化,第 600 个提交之后一定会漂。
五、所以该往哪儿投
这个拆分有实际的用法,因为它直接改变两个决策。
第一,投资自己的能力时。
大多数人默认的进步路径是「掌握更多最佳实践」——读更多书、学更多框架、刷更多案例。这条路的回报率正在下降,因为你掌握的速度赶不上模型更新的速度,而且你掌握的东西恰恰是最容易被外化、被固化、被模型读到的那一类。
真正该投的是另外两样:一是 判断的分辨率——能不能看一眼结果就说出「这里不对」,并且说清为什么不对;二是 固化的手艺——能不能把那个判断写成一条 eval、一条规则、一段 SPEC,让它在你不在场的时候继续生效。
第二,评估别人的时候。
我在 #317 里写过「如果还用代码写得好不好评估工程师,就像摄影术发明后还用画得像不像评估画家」。现在可以更精确一点:也别用「他懂不懂最佳实践」来评估——那是第 1 半,正在贬值的那一半。
该问的是两个问题:他能不能识别出「这个能跑的方案本就不该存在」?他识别出来之后,有没有把它变成别人(和 agent)下次绕不开的东西?
这里藏着一个残酷的错配,也是这个拆分最实际的用处:正在贬值的那一半,恰好是最容易证明的;正在升值的那一半,恰好是最难证明的。
「我懂最佳实践」很好演示——聊十分钟技术选型,看他的 GitHub,问他用过什么框架,都能看出来。而「他能一眼看出这个方案不该存在」几乎无法在面试里演示:你得给他一个真实的、能跑的、测试全绿的系统,还得等上几个月,看他会不会喊停。至于第三半,更难看见——它藏在 eval 集、runbook、SPEC 的修订历史里,不主动去翻就根本不知道存在。
于是市场系统性地高估第 1 半、低估第 2、3 半。这不是招聘者的错,是因为 只有贬值的那一半自带展示界面。这也是我在 老板 AI 量的不是工程师,是老板自己的品味 里说的同一件事的另一面:那篇讲尺子由谁来定,这里讲的是——尺子天然偏向容易被量化的那一半,所以你得刻意去量不容易被量化的那一半。
Anthropic 那 7 个人之所以能在五个月里做完这种事,不是因为他们比别的团队更懂版本控制的最佳实践——那些知识 Claude 都有。是因为他们知道该对什么说 no,而且把 no 写进了系统。
回到开头那个定义。它没有错,只是不完整,而且它把两块正在朝相反方向运动的东西写在了一起,读起来像是一样值钱的。
人的品味 = 对一项任务的最佳实践的理解,以及判断结果好坏的能力。
现在我会这么补:最佳实践的理解正在被模型吃掉,判断结果好坏的能力正在涨价,而 把判断固化成载体的能力,决定前一半死掉之后,后一半能不能留下来。
一个问题留给你:你团队最近一次有人说「这个方案能跑,但它不该存在」,是什么时候?那句话后来变成了一条 eval、一条规则,还是只留在了一次 review 的口头评论里?
欢迎留言聊聊。