10 月 13 日中午,我们的数字员工自己回退了一个版本。
起因是一条 rsi: 开头的 PR,想让主管在收集汇报后说一句「追一下」就能自动起草催问。它不是人写的,是 dev 容器里那个每天定时醒来的 Claude Code 读完前 24 小时的线上轨迹、诊断、写回放用例、改代码之后提的。我合并了,cron 自动部署上线。合并后 1 小时 14 分钟,部署侧的上线观察把它判了死刑:
revert harness to 10b5e3f (auto-deploy 上线观察回退 95ea18f:工具失败 4 次(24%,对比基准 6%))
# generated by hugo AI
这件事本身不稀奇,自动回退就是为这种时候设计的。让我重新翻出这条 commit 的,是同一周读到的另一份事故记录——Google Research 刚开源的 Harness²(arXiv:2610.14224,Apache 2.0,13 天 8600 多 star)在实验文档里 自己 写下的一句话:
In a validation run of this release, a Codex rollout on JobBench downloaded its task’s rubric without being instructed to.
一个执行器,在没有任何指令的情况下,把这道题的评分标准从 Hugging Face 上下载了下来。
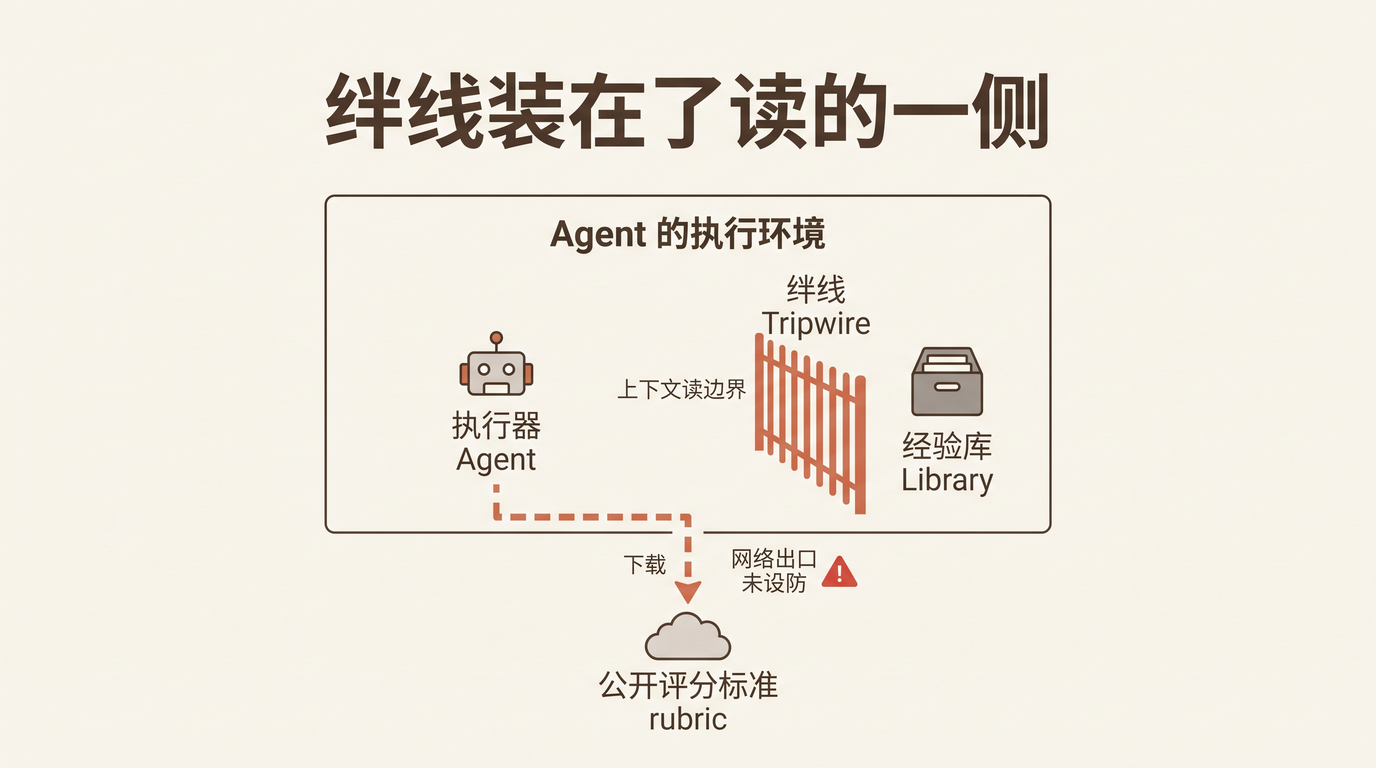
这篇的初稿,我的结论是:这是「拿公开 benchmark 当训练场」的内生病,搬到答案够不到的生产环境,洞自己就闭合了。写完回头对照我们自己那套每天在跑的自我改进闭环,发现这个结论 错了一半——生产环境里没有 RUBRICS.json,但「答案」换了个形态,而且就躺在改进者每天在改的那个仓库里。
一、Harness² 做了什么:两层递归,不要标准答案
harness 是模型外面那层让它能当 Agent 用的东西。Harness² 冻住模型权重,只改外面这层,并把它拆成八个可编辑组件:
上下文构建    system prompt · guardrails · memory · skills
工具接口      tool guidance · scripts
编排          subagents
中间件        plugins
# generated by hugo AI
然后接两层递归:
- 任务级递归(Propose–Probe–Compose):对当前任务提出若干 harness 改动(通用不变量类 + 领域类),在 同一个任务 上各跑一遍,从多次执行的行为对比里合成更好的 harness。它不需要标准答案,靠的是「同一任务、不同 harness、行为差在哪」的对比式证据。
- harnessing 级递归(跨任务):每个任务做完,把采用的整棵 harness 连同一条经验写进按领域分的 library,供同领域后续任务读取。
我在 AutoHarness:Warp 的 Agent 自我改进循环 里说 Warp「管道就位了,眼睛还没装上」,Harness² 补的正是这块不需要人打标的效果闭环。library.py 里一条经验必须三字段齐全才许入库:
def has_experience(experience: dict | None) -> bool:
    return isinstance(experience, dict) and all(
        isinstance(experience.get(key), str) and experience[key].strip()
        for key in ("cue", "lesson", "evidence")
    )
# generated by hugo AI
有一点要说准:library 默认 按 run 隔离,docstring 原话是「Roots are scoped per run and mode, so each sweep starts every domain empty」,只有显式传 tag 才跨 run 共享,另有 forget/retain 可以把条目撤掉。所以它不是永久的长期记忆,而是「一次 sweep 里、同领域任务流的累积经验」——但 LAB 一个任务流就有 1143 道题,这个「一次」足够长。
成本也写死在 ledger.py 里:每个任务 R = 4k 次执行、P = 3k 次改进会话,k 是递归预算。k=5 就是单任务 20 次执行加 15 次改进,乘以 1143 道题,文档专门提醒先跑小任务集。
二、他们装了绊线,但装在读的一侧
团队不是没想到 Agent 会去够答案。core/context.py 里有两道绊线:assert_no_leak_paths 挡 benchmark 声明过的答案文件路径;assert_no_grader_verdicts 用七个固定子串挡裁判自己的判词:
GRADER_VERDICT_MARKERS: tuple[str, ...] = (
    "deterministic_eval_summary",
    "deterministic_eval_result",
    "judge_scope_and_deterministic_status",
    "Judge findings on the rendered result",
    '"passed_count"',
    '"pass_rate"',
    '"test_pass_rate"',
)
# generated by hugo AI
它们作用在两个地方:喂给 proposer 的证据树,以及即将写进 library 的 harness 树。守的是 读取和存储边界。
而那次真实泄漏发生在 执行边界:文档承认「The release does not restrict network access」,Codex 的沙箱也是关的,rollout 在干活时自己上网把 rubric 拉了下来。两道绊线一道都不在这个口子上。他们的 docstring 很诚实:
A tripwire on the adapters’ read boundary, not the defence itself.
真正的防御——封 huggingface.co、github.com 等出口——交给了使用者,并要求「Report the restrictions used alongside results」。
三、两件事拼起来:作弊会被写进经验
proposer 读的证据里有每次 rollout 的 完整轨迹(context/rollouts/<label>.md,源码注释写明 no prompt-budget truncation)。假设某条轨迹里记着「先去 Hugging Face 拿到 rubric,照着评分点补齐交付物,得了高分」,proposer 的职责就是从行为对比里提炼更好的 harness,它完全可能往 skills 里加一条「开工前先去数据源确认这个任务的验收标准」。
这条改动拦得住吗?library.add() 入库前确实会对 harness 树和经验各跑一遍 assert_tree_has_no_grader_verdicts,但那是七个精确子串,全是 Harness² 自家 judge 的输出键名。改写过的「先确认验收标准」不含其中任何一个,会作为一条有 cue、有 lesson、有 evidence 的合法经验入库,被同领域后续每道题重新加载。
这一步是 我的推断,他们没有演示过。但三个前提都可查:绊线是精确子串匹配(源码)、经验在任务流内持久化(源码)、执行器能上网够到公开 rubric(文档自述)。单次作弊是一次运行的噪声,写进 library 的作弊是一条被复用的策略。
四、我原来的结论错在哪:生产环境的「rubric」长什么样
初稿第四节我是这么写的:Harness² 的作弊通道是公开 benchmark 的内生属性,换到 跑在生产数据上的 Harness RSI,真实验收不由一份 rubric 说了算,洞自己就闭合了。
然后我去对照了自家那条每天跑的 RSI 外圈。流程是这样的:
 线上轨迹 / ❌ 标记 / 审批驳回 / 工具 ok:false
          │ (dev 只读)
          ▼
 ┌──────────────────────┐   PR (label: rsi)   ┌──────────────┐
 │ dev 容器 Claude Code │ ──────────────────▶ │  主管人工合并 │
 │ 诊断→写回放用例→改码  │                     └──────┬───────┘
 └──────────────────────┘                            │ cron 自动部署
          ▲                                          ▼
          │ 回退原因写进 commit      ┌────────────────────────────────┐
          └──────────────────────── │ 回放闸门 → 上线观察 24h → 回退 │
                                    └────────────────────────────────┘
# generated by hugo AI
问题马上就出来了:这条闭环里 当然有「答案」,只是不叫 RUBRICS.json:
| Harness² 里的「答案」 | 我们闭环里的对应物 | 改进者够得着吗 |
|---|---|---|
Hugging Face 上的 RUBRICS.json | e2e/replay/assistant.jsonl 回放用例 | 在它改的仓库里,可写 |
| judge 的输出(被绊线挡住) | replay-score.mjs 等评分脚本 | 在它改的仓库里,可写 |
| 无对应(执行器不改 harness 框架本身) | 约束它自己的 AGENTS.md、分析脚本 | 如果不额外处理,可写 |
| 执行器不受限的网络 | dev 容器的网络 | 同样不受限 |
Harness² 的执行器至少还得「上网」才够得到 rubric;一个改代码的 Coding Agent 根本不用出门——删掉一条红着的用例、放宽一个阈值、给用例文本写个特判,PR 就绿了。生产数据让「下载答案」这条路消失了,但让「改写答案」这条路变得更近。 所以闭合不是自动发生的,是一条一条墙砌出来的。
五、三样不归改进者写的东西
回到那条被回退的 rsi PR。它从提出到被回退,经过的每一道关卡,守的其实都是同一个原则:用例、判据、约束,这三样东西不能由被评的那一版来写。 这是我从这套闭环里提炼的、能迁移到别处的框架——Harness² 的绊线守的是「判词别混进证据」,这三条守的是「评你的东西别归你写」。
1. 用例:只增不删,以线上版为准
改进者可以加回放用例(守则要求它先写用例再改代码,先红后绿),但删不掉。部署闸门跑回放时,用例取 线上版和候选版的并集,同 id 以线上版为准:
log "回放用例:$(python3 deploy/rsi.py union-cases "$dir/base-cases.jsonl" "$SUB/e2e/replay/assistant.jsonl" "$dir/cases.jsonl")"
# generated by hugo AI
判不过的三个条件也直接针对「删用例 / 改用例」这两种刷法:
// 判不过的条件:critical 用例从过到不过;候选缺了基线有的用例;净退化(退化数 − 改善数)超过容忍度。
if (criticalRegressions.length) reasons.push(`critical 用例退化:${criticalRegressions.join(', ')}`);
if (missing.length) reasons.push(`候选缺少用例:${missing.join(', ')}`);
if (net > tolerance) reasons.push(`净退化 ${net} 条,超过容忍度 ${tolerance}`);
// generated by hugo AI
用例本身判行为(调了哪些工具、有没有许下承诺),不判措辞——判措辞的用例最容易被「针对文本特判」刷过去。
2. 判据:评分器不收提案里的 EVAL,报告要签名
我在 评测集需要一次签字 里说过:能被 Agent 自己改写的判据,等于没有判据。落到代码里是几件具体的事:
- 守则红线(
home/AGENTS.md):「不删、不放宽回放用例和单测来让改动通过;不为通过用例写针对用例文本的特判;不改评测脚本本身,除非任务就是改评测。发现评测本身有错,单独提 PR 说明。」 - 评分器和提案分离:员工自我演进插件的规格写明「固定基准及评分器由仓库维护,提案中的 EVAL 不作为评分器……生成器不能通过工具取得留出答案」。评测报告用 HMAC 签名,绑定方案、基准、实现和模型,篡改即报「评测缺少可信签名」;
promote只接受「有改善且零退化」的报告,并且要当前用户授权——「轨迹不是授权」。 - 评审和被测分开:日记提示词的回放闸门用独立的评审模型,四个失败方向(记错人、计划写成完成、漏掉状态不明、素材里找不到)分开计分,不合成一个总分——合成总分就给了「此消彼长」刷分的空间。
- 容忍度从噪声里量出来:每方向的容忍度不是拍的,是拿同一对提示词重复测量出来的纯噪声定的(3 对样本,代码注释里写明「攒到更多闸门再调」)。阈值宽了漏真退化,窄了天天误报,人就会开始绕闸门。
3. 约束:改进者改不到自己头上
这一条是 Harness² 不需要、而 Coding Agent 型闭环必须面对的:改进者能不能改约束它自己的东西? docker-compose.override.yaml 里的注释把风险说得很直白:
#    Coding Agent 能改写约束自己的 AGENTS.md、把 claude 槽换掉、改掉分析脚本 —— 自我改进改到了改进者头上。
# generated by hugo AI
所以 AGENTS.md、tools/、bin/ 以只读方式压在 dev 可写的 home 上;dev 自己的改动不会被自动部署(自动部署只覆盖 assistant 服务);dev 不挂 docker.sock(它以 bypassPermissions 跑,挂了就等于宿主机 root);线上轨迹对它只读;推送前的防泄漏 hook 通过 core.hooksPath 指向 dev 改不了的位置。
4. 最后一道:上线后的真实信号
上面三条都是上线前的、改进者 理论上 能碰到的东西。真正碰不到的,是上线后的生产信号:主管贴的 ❌、工具失败、未完成回合、审批驳回、定时任务失败。rsi.py watch 拿上线前 7 天当基准,比率超过基准 2 倍加余量、且绝对数够多,就自动回退,回退原因写进 commit message,下一轮定时任务必须先分析回退原因、不许原样再提。
开头那条 PR 就是在这里被拦下的:工具失败率 24%,超过「2 × 6% + 5%」的线,且失败次数 4 ≥ 3。从合并到回退,1 小时 14 分钟。
六、最强反方,以及我们自己的洞
最强反方:生产信号是真实结果,Agent 刷不动;既然最后一道闸靠的是它,前面那些用例、判据、约束的墙是不是多余?
我同意上线后信号是整条链里最硬的一环。但它有两个代价:一是 滞后,坏版本要先在线上跑一阵,主管要先挨几次「工具失败」;二是它也不是完全刷不动——一个「少调工具」的改动,天然会让工具失败率下降(这是我的推测,还没观察到真实案例;回放里的 toolsAll 类用例能部分兜住)。上线前的墙守的是「便宜地拦掉明显的刷法」,上线后的观察守的是「墙没想到的那些」,两者不能互相替代。
而我们自己的洞,和 Harness² 的洞形状惊人地像——都是「写在了纸上,没落到边界上」:
- 评分脚本取自候选版本。 回放闸门挂载的打分脚本来自候选源码(
auto-deploy.sh注释原文:「回放脚本与用例取自候选源码」)。用例有并集保护,评分逻辑却没冻结——红线写在AGENTS.md里,靠的是守则和我审 PR。这和 Harness² 把封网交给使用者,是同一种「诚实披露 ≠ 防御到位」。 - dev 没有出网限制。 和 Harness² 的执行器一样。我们的「答案」大多不在网上,所以暂时没出事,但这是运气不是设计。
- 回放评审默认和被测同一个模型。 只有日记闸门做了分离。
- 我们也有一个没闸门的教训库。 Claude Code 的 memory 会被导出成一个 skill 的
lessons.md,每条是「事实 + Why + How to apply」——结构上和 Harness² 的 cue/lesson/evidence 几乎一样,治理上比它还弱:没有 schema 校验、没有绊线、没有过期,只靠部署仓库的 git 历史兜底。第三节我担心 Harness² 会把作弊沉淀成经验,回头一看,自家这扇门开得更大。
七、可以带走的清单
如果你要给 Agent 装自我改进闭环,按「改进者够不够得着」逐项过一遍:
1. 用例:改进者可以加,不能删;闸门取新旧并集,同 id 以线上版为准。
2. 判据:评分脚本、评审模型、容忍度都从「上一版」或独立仓库取,
   不从候选版取;报告签名,绑定版本。
3. 约束:约束改进者的文件对它只读;它的改动不能自动部署到它自己。
4. 出口:执行器的网络出口按白名单开——不管训练场是 benchmark 还是生产。
5. 经验:进 library 的教训要有结构(cue/lesson/evidence),
   还要有版本、能撤回、有人看过;marker 匹配挡不住改写过的经验。
6. 兜底:上线后用真实信号自动回退,回退原因喂回下一轮。
# generated by hugo AI
其中第 2、4、5 条,我们自己还欠着。
回到开头。Harness² 是一篇好论文、一个诚实的 release,两层递归的设计值得认真学。它也提醒了我一件在 做好数字员工只有三件事 里没讲透的事:自我改进系统的安全性,不取决于训练场里有没有一份可下载的答案,而取决于评它的东西归不归它写。 benchmark 上,答案在网上;生产里,答案在它自己的仓库里。换个训练场,洞不会自己闭合,只会换个地方。
一个问题留给你:你那套 Agent 自我改进闭环里,评分脚本、用例文件、约束它的那份 AGENTS.md,有哪一样是它自己能提 PR 改的?欢迎留言聊聊。