前几天,我对自己的工作助理打了一个 ❌。
它推过来一张「工作事项提醒」:🔴 等别人交付——某同事今天要把一件事弄好。问题是,这件事我 7 分钟前还在和那位同事单聊。我问他要不要先做,他回「今天弄好」,助理把这句话记进了台账,5 分钟后就把它当成急事推给了我。截止时间是当晚。
信息本身没错,每个字都对得上原话。错在 时机:我正在处理的事,它又来提醒我一遍。这一个 ❌ 让我意识到,我给这个助理(下文叫它 Muse)定的目标——「主动帮我管理钉钉上的工作信息流」——难点从来不在「主动」,而在主动之前那一步:它得先知道哪件事是谁的、现在是什么状态、我此刻在干什么。
这三件事,靠一个更聪明的模型现场去翻聊天记录是翻不出来的。它们得被 编译 出来。
先说清楚名字。Meta 也有一个叫 Muse 的个人 Agent,我在 智能提案,权威拍板 和 299 美金,够不够把数据留在本地? 里都拿它当过参照。两者方向几乎相反:Meta Muse 是跑在云上、 替你办事 的 C 端助理;我这个 Muse 是长在组织 IM 里、 替你看清楚 的工作助理——它的原料是我所在组织的工作流,数据不出私有部署仓库,能做的事被代码一条条框死。
这篇写给两类人:一人公司(OPC)的老板,客户群、供应商群、合作方单聊全压在一个人身上;以及每天被几十个群淹没的管理者。你们缺的大概率不是一个更会聊天的 AI,而是一台能把信息流编译成「可被 AI 使用的个人上下文」的机器。
一、问题不是信息太多,是没人编译
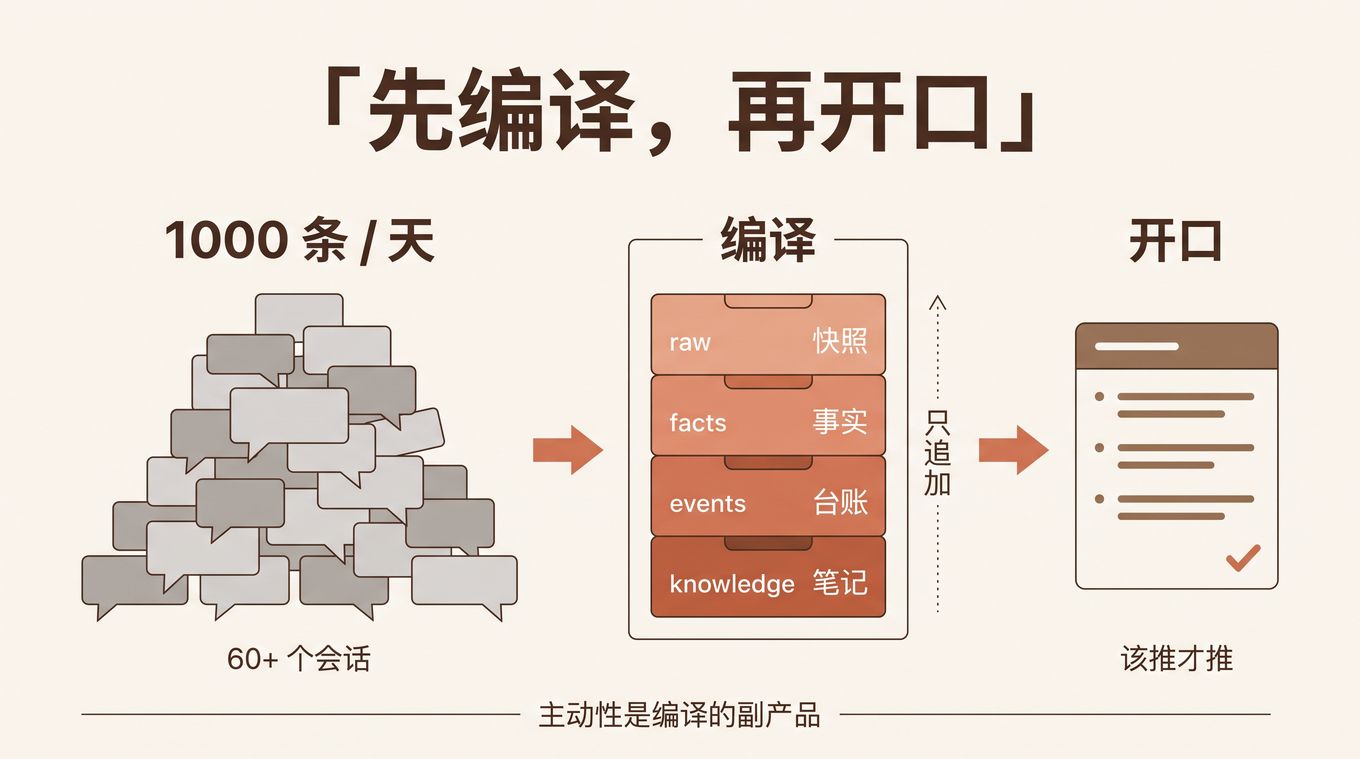
先看一组我自己账号的实测数字(2026-10-14):一天约 1000 条消息,分布在 60–76 个会话 里;按「跟我有关」的口径筛,35%–45% 算有效素材,折下来一天 6–9 万字。
6–9 万字,相当于每天读一本薄书的三分之一。没人读得完,所以每个管理者都在用同一个土办法:只看红点、只看 @我、只看老板。剩下的靠记忆和运气。
传统的 AI 方案是「搜索 + 问答」:信息都在那,你想知道什么就问。它解决了「找得到」,没解决「想得到」——你不知道该问什么的那件事,才是会出事的那件事。 所以「主动」是刚需。
但主动有个前提。我在 数字员工的活人感,一半是知道什么时候闭嘴 里写过四道闸,拦的是「无话可说时的发言」;那篇最后留了一个没想清楚的问题:有话可说,但此刻不值得打断人,该攒到什么时候说?
做了两周 Muse 之后,我的回答是:这个问题在「说话」这一层是回答不了的。它的答案藏在更下面——你得有一份持续维护的、知道每件事状态的账本。没有账本,「紧急度」和「累积效应」都无从判断,模型只能每次从零猜。
主动性不是模型的能力,是编译的副产品。
二、工作上下文编译栈:四层,每层只有一个写入者
我在 我的知识编译器,把自己的源代码编译没了 里把个人知识库看成一台编译器:Capture → Compile → Retrieve → Use。那篇编译的是「我读过的东西」——文章、笔记。
Muse 编译的对象换了:我的工作流本身。 人和关系、会话、文档、会议、还开着的事项、每天的日记。原料长在组织系统里,不在我的笔记软件里。这一换,编译器的结构就得跟着变——因为原料里混着别人的话、机器人的话、甚至 Muse 自己代我发出去的话。
最后收敛出来的结构是四层:
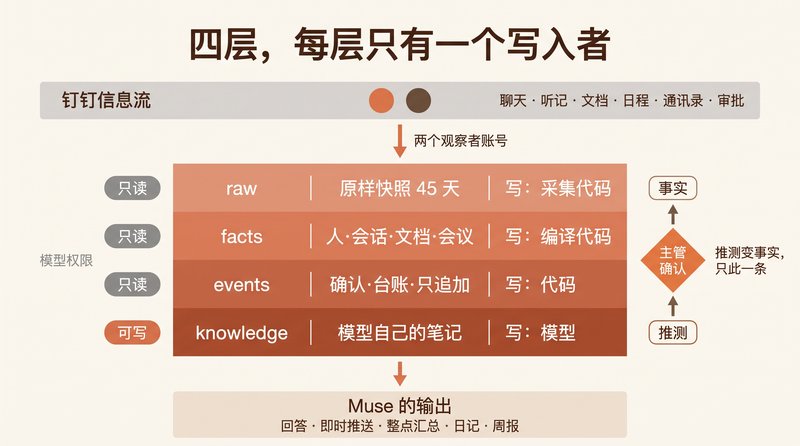
图里为简洁省掉几处细节:第三层实际是两个目录,events/ 存主管确认、台账变更和推送记录(只追加,不可重编),state/ 存工作事项台账、推送状态和注意力;raw/ 只用来回放,不用来回答;facts 层还包含关系、项目和日记出处卡。
这张图里最重要的不是层数,是三条规矩:
- 每个文件只有一个写入者。 谁写坏了,一查就知道是谁。
- 模型推测不能直接成为事实。 模型觉得「张三是这个项目的负责人」,只能写进自己的笔记;要进
facts/,得我在单聊里确认,或者代码核对过它引用的原话。 - 编译是确定的。 同样的快照加同样的确认记录,一定编出同样的结果。这样出了错能回放,改了规则能对比。
为什么要这么较真?因为我在 429 那篇里已经吃过亏:编译器把自己的状态写回了源文件,把源代码「编译没了」。那次的教训是「原始资料只读,必须靠挂载方式保证,不能靠提示词」。Muse 把这条推得更远:模型能写的地方只有一个目录,而且这条边界由代码里的文件闸门守着——dsh 运行时自带的文件工具本身不设任何路径边界,闸门一摘,模型就能写任何地方。
这套结构是可复用的。判断标准是:你能不能把它拿去解决一个我没写到的问题? 比如给销售做客户跟进助理——客户聊天是 raw,客户档案是 facts,销售确认的成交阶段是 events,模型对客户的揣测是 knowledge。四层、单写入者、推测要过确认,原样适用。
三、编译器最难的一步是「谁」
做之前,我以为难点是「理解这条消息在说什么」。做完才发现,最难的是 「这条消息是谁说的、关于谁的」。Muse 上线两周,三次大错全出在身份上。
第一次:助理被并进了主管本人。 编译规则里有一条看上去天经地义的推理——「同一个单聊里的对方,是同一个人」。但 Muse 有两个观察者账号(它自己和我),我和它之间的单聊,两边看到的「对方」互为对方。这条规则只在两个观察者是同一个人时成立。结果是台账和我的语气包都把 Muse 说的话当成了我说的。
第二次:Muse 吃到了自己的输出。 Muse 有时会用我的账号代发消息。钉钉里这类消息的发送类型仍然是「用户」,只有一个不起眼的 AI 代发标记能区分。一周 69 条代发里,有 35 条混进了普通群素材,其中 1 条它代我写的方案说明,被它自己记成了「主管要做的事」——自己给自己派了活。
第三次:助理被算成了我的下属。 把助理从我本人里拆出来之后,它在通讯录里的「部门主管」字段指向我,于是被推成我的下属。我和它的单聊来回 578 轮,亲密度直接排第一:1310 分,第二名才 692。我的「核心协作圈」里,排第一的是我自己的助理。
三个错有一个共同点:每一条单独看都没错。 消息内容是真的,发送人字段是真的,部门主管字段也是真的。错在推理链上那个隐含假设——「一个人一个账号」「用户发的就是人发的」「部门主管就是直属上级」。后来实测,通讯录相关的三个基本假设(组织内 userId 唯一、openDingTalkId 按组织分配、部门主管等于直属上级)全部被推翻。
这也是我在 通讯录不是人员列表,是企业本体的第一张骨架图 里坚持「先编可验证的事实」的原因。修法也都很朴素:助理自己的账号编成单独的 kind: assistant,不算同事、不算下属、不进亲密度;校验阶段加一条报错——主管本人那条记录里如果混进了助理的账号,编译直接失败。
个人 Agent 的第一道坎不是理解力,是身份。 模型再聪明,也纠正不了编译层喂给它的「这句话是你说的」。
四、主动性从台账里长出来
有了编译栈,「什么时候开口」就从一个玄学问题变成了一个工程问题。Muse 的主动推送分三档,全部从同一本工作事项台账里读:
| 档位 | 节奏 | 推什么 | 谁决定推不推 |
|---|---|---|---|
| 即时推送 | 每 10 分钟查一次 | 新变成 P0 的事;有人找我 15 分钟没回 | 代码,不调模型 |
| 整点汇总 | 每小时兜底 | 台账这一小时的变化 | 没变化就不调模型;模型回 SILENT 就不发 |
| 日记 | 收工后 30 分钟 | 今天定了什么、完成什么、谁欠谁什么 | 我在单聊里说「确认」才存档 |
注意最后一列。「该不该推」这件事,交给了代码,不交给模型。 模型负责的是把一件事说清楚——依据、下一步、出处原话;什么时候说、要不要说,由规则决定。
回到开头那个 ❌。修法是给即时推送加了一个「先压一压」的判断。下面是简化后的逻辑(真实实现在 push.cjs,这里用 Python 写清楚意图):
from dataclasses import dataclass
from datetime import datetime, timedelta
from typing import Optional, Protocol


@dataclass(frozen=True)
class WorkItem:
    """台账里的一件事。owner 为 None 表示负责人不明确。"""
    title: str
    priority: str                 # "P0" / "P1" / ...
    owner: Optional[str]          # 谁来做
    source_chat: str              # 出处会话
    deadline: Optional[datetime]  # 截止时间,只写了日期的按当天下班时间算


class AttentionLog(Protocol):
    """主管最近在哪些会话里说过话(来自注意力记录 + 本轮新消息)。"""

    def last_spoke_at(self, chat_id: str) -> Optional[datetime]: ...


def hold_reason(
    item: WorkItem,
    supervisor: str,
    attention: AttentionLog,
    now: datetime,
    in_work_hours: bool,
) -> Optional[str]:
    """返回压下这条 P0 的原因;返回 None 表示现在就推。

    压下只是推迟、不丢:每轮再看一次,整点汇总照常兜底。
    """
    if not in_work_hours:
        return "offHours"
    spoke = attention.last_spoke_at(item.source_chat)
    if spoke is not None and now - spoke < timedelta(minutes=30):
        return "chatting"  # 主管正在这个会话里处理,别再提醒他一遍
    is_others = item.owner is not None and item.owner != supervisor
    if is_others and item.deadline is not None:
        if item.deadline - now > timedelta(hours=1):
            return "notYet"  # 别人交付的事,截止前 1 小时才推
    return None
# generated by hugo AI
规则改完,我用 10-21 到 10-26 的真实台账只跑代码回放:旧规则会即时推 18 件,新规则推迟其中 15 件——正在聊 4 件、没到截止前 4 件、下班时间 7 件;而这 15 件里有 2 件,在新的推送时间到来之前我已经自己关掉了。
这就是 434 那个问题的一个具体答案:「该攒到什么时候说」,取决于你知不知道这件事现在是谁的、到哪一步了、主人是不是正在处理。 这些都不是模型现场能判断的,是台账编出来的。
还有两个小坑,都是「主动」特有的:
- 上线那一刻,它把已有的 6 条 P0 一次全推了一遍。 对它来说这些都是「新发现」,对我来说全是旧闻。后来规定:第一次运行只记不推。
- 游标推进早于调用模型。 有一轮汇总因为超预算被跳过,但游标已经往前走了,那一小时的变化(包括其中的 P0)就这么静默丢了,即时推送也以为「已经说过」。主动系统最怕的不是说错,是 以为自己说过。
推送卡片本身也按「少打扰」设计:分「你要办」和「等别人交付」两组,每件带编号、依据、下一步、出处原话,末行写一句「为什么现在推」;按钮是「找 XX」「去会话」,一点就跳过去。我回「1 已办」「除了 2 全完成」,由代码解析,不过模型。
五、一个月后,还能问出「这条是从哪来的」
10 月 20 日我问了 Muse 一个问题:「一个月后我问某个任务是什么时候、从哪下的,你能准确找出来吗?」
答案是不能。日记正文不带出处,原始快照只留 45 天,而且没有消息 ID。
于是加了一步「日记溯源」:日记经我确认后,由代码把每一条对回出处,编成长期保存的事项卡。出处有优先级——台账事项(会话 + 消息 ID + 原话)优先,其次是原消息、当天快照、听记;都找不到就如实写「没找到」,不编。这一步不调模型。
用 10-08 到 10-20 的真实日记回填:171 条里,69 条找到了出处。 不到一半。其中 10-08 到 10-10 那几天还没有快照,天然找不到;剩下的缺口,主要是日记里那些「打包式」的总结句,对不回任何一条具体消息。
我选择把这个数字原样写出来。一个「什么都答得上来」的助理,比一个「答不上来就说没找到」的助理危险得多——前者会让你在一个月后,基于一条编出来的出处去追责。
六、主动性的另一半:它也在主动改自己
写到这里,前面说的「主动」都是 对我 的:替我盯事、替我判断该不该打扰。但 Muse 还有另一半主动性,是 对它自己 的——开头那个 ❌,很快就变成了一条规则、一组单测和一次回放。
这件事我在 数字员工的自我进化 和 自我改进的 Agent,会先学会怎么拿到评分标准 里写过方法论,这里不重复。这一篇想补的是一个之前没看清的关系:让 Muse 看清我的那套编译栈,恰好也是让它看清自己的那套。
具体是三个环,从快到慢:
  环             节奏        信号从哪来(全在编译栈里)            谁拍板
 ─────────────────────────────────────────────────────────────────────────
  ❌ 反馈标记     即时        events:这个 ❌ 对应哪次推送、哪几件事   不改任何东西,只记账
  语气包周检     每周一      raw:我本人亲手发的消息(剔除代发)      我逐条采纳,可回滚
  工程迭代       每天        raw 回放 + held 记录 + 线上轨迹         PR 合并前跑回放,人审
# generated by hugo AI
❌ 只记账,不改东西。 我对一条推送或回复打 ❌,事件桥用代码把它登记成一条反馈标记:这次推送是什么时候发的、包含哪几件事、出自哪个会话。不调模型,也不立刻改任何规则——「贴个表情要做什么」是设计决定,不是模型判断。它的价值是让下一次改进有据可查。讽刺的是,开头那个 ❌ 当时其实对不上——代码直接发的即时推送不在发出索引里,只能记成「出处查不到」;修推送时机的同一个 PR,顺手把推送也纳入了登记,此后打 ❌ 能对上是哪几件事。
语气包周检,宁可慢也不自动上线。 Muse 代我回消息时用一份「语气包」,学的是我九月份的说话习惯。每周一早上,代码先统计我这一周亲手发的消息(剔掉 Muse 代发的——又是第三节那个身份问题),算 16 个风格指标;连续两周同向漂移超过 2 个标准差,才调一次模型提改动建议,最多 5 条、每条至少附 3 条原话作证。建议到我单聊里,我逐条采纳才写回,随时可以撤。之所以这么保守,是因为更早有一次语气相关的改动合了又撤:语气没有客观对错,不能让它自己说了算。
工程迭代,靠编译栈当评测集。 这是最大的一环。10 月 11 日以来,这个仓库合了 271 个非合并提交,其中 103 个落在台账、日记、通讯录、推送和语气这几块(按 git log 统计)。大部分起点就是我在单聊里的一句话或一个 ❌——「一个月后能找出来吗」「推得太快了」。其中一部分,是 dev 容器里每天定时醒来的 Coding Agent 读完前 24 小时线上轨迹之后自己提的 rsi: PR。
能这么快改、又不至于越改越乱,靠的是编译栈里那几样东西:
- raw 快照留 45 天,就是为了回放。 开头那条推送规则,合并前先拿 10-21 到 10-26 的真实台账「只跑代码」重放一遍,才有了「18 件推迟 15 件」这个数字。没有快照,每次改规则都只能上线赌一把。
- 被压下的推送也记账。 每条没推的候选都记下原因(正在聊 / 没到点 / 下班)。我明确决定 不做随机对照组——不为了验证效果故意少推几条——这份「压下记录」就是天然的对照。
- 只追加的确认记录,让改动可以对账。 规则改了,我过去的确认不会丢;编译重跑一遍,对比前后差异就知道改动影响了谁。
这和我在 让钉钉机器人自己开发自己 里写的那种「一句话改代码」相比,多出来的正是这一层:改得快不难,难的是知道改对了没有。 而「知道改对了没有」,需要的恰好是一份能回放、能对账、能区分谁说了什么的上下文。
对外的主动和对内的主动,吃的是同一份编译结果。 编译得好,它既能看清你的一天,也能看清自己昨天哪里做错了。
七、最强反方:上下文窗口越来越长,编译是过度工程
这是我被问得最多的反驳,也是最有分量的:模型上下文已经 1M 了,还在涨。把原始消息直接喂给模型,让它现场检索、现场判断,不就行了?编译这一层,迟早被更强的模型吃掉。
我认真算过这笔账。
第一,钱。 Muse 的日记最早就是让模型带着工具自己翻素材(工具循环),每次约 83 万 token——同一份上下文被重发了约 9 次。改成「代码先采齐、模型只调一次」之后,每次约 6 万 token,耗时差不多,都是 3 分钟左右。工作事项整理也一样:线上一天约 700 万 token,改成代码打包、一次调用后,回放只要 18–24 万。上下文窗口变大,不会让重复读同一份素材变便宜。
第二,长窗口修不了身份错误。 第三节那三个错,喂给再强的模型也一样会犯——因为错误在「这条消息署名是谁」这一层,模型看到的输入本身就是错的。
第三,长窗口不提供记忆和确认。 「一个月后这条从哪来」「我上周确认过张三是负责人」——这些需要一个持续存在、只追加、能回放的账本。窗口再长,会话结束也就没了。
但反方也有说对的地方,我得承认:
- 编译有质量代价。 日记从工具循环改成一次编译后,6 天回放里「记错人」从 4 次升到 5.5 次(取两次平均)。工作事项整理改成一次调用后,覆盖率从 60%/79% 升到 93%/90%,但准确率从 90%/79% 降到了 76%/63%(两组数字分别是 10-19 和 10-20 两天)。新版没达标就上线了,因为花费降了一个多数量级,而多提出来的三类错误(会议改期、已办完的操作、同一件事重复提)可以靠自查清单逐步收。这是一个取舍,不是免费的午餐。
- 编译规则会过时。 钉钉的数据结构变了,编译规则就得跟着改。这是持续成本。
还有一个反驳来自另一个方向:让 AI 读我的账号,是不是在监视自己、也监视同事? 我的回答是边界要靠架构,不靠承诺——这和我在 智能提案,权威拍板 里的立场一致:
- 主管账号只读,能跑的命令写死在白名单里,按参数逐个比对;
- 所有改台账、查通讯录的工具,只在「主管本人 + 单聊 + 对话回合」时可用,群里任何人问都拒;
- 配置缺失、文件损坏、角色查不到,一律拒绝(fail-closed);
- 真实数据只进私有部署仓库,推送前用编译结果现场生成黑名单扫一遍。
八、如果你想给自己搭一个:从「谁」和「还开着的事」开始
写给 OPC 和管理者的务实建议,按我踩过的顺序:
1. 先编「谁」。 把你最常打交道的人编成一张表:是谁、在哪个组织、和你什么关系、最近在忙什么。Muse 最早是手工编了 24 个人,逐个经我确认的。别一上来就全量——全量通讯录 131 人,真正有往来的 43 人,密切的 11 人。先把那 11 个人搞对。
2. 再编「还开着的事」。 一本工作事项台账:什么事、谁负责、截止什么时候、出处原话。这是所有主动性的地基。
3. 别直接导入钉钉待办。 这是反直觉的一条。我的账号里未完成待办约 300 条,其中 139 条已经逾期好几个月,而且接口翻页不可靠。待办系统里的噪声远大于信号,把它当事实源,你的台账从第一天就是脏的。
4. 让代码决定「何时」,让模型决定「怎么说」。 即时推送的判断全部写成规则,模型只负责把一件事讲清楚。规则可以回放、可以对比;模型的「我觉得现在该说」不行。
5. 每条输出都要能对回出处。 哪怕现在只有一半对得上。对不上的,就让它说「没找到」。
6. 给自己留一个 ❌。 每条推送都让你能一键打叉,并且记下这个 ❌ 对应哪件事、哪条规则。Muse 不少规则,是被我的 ❌ 逼出来的,第六节说的那几个环也是从这里起步。
至于成本,粗略的体感是:贵的不是模型调用,是 回放。有一天我连跑了 5 轮回放调规则,晚上 11 点额度用完,线上的 Muse 跟着一起停了。从那以后,回放要单独申请额度。
九、往前看:AI-ready 的个人上下文,会变成一种可携带的资产
我在 数字分身和数字员工的分界线 里写过:数字分身围绕个人上下文,数字员工围绕工作上下文。Muse 恰好站在这条线中间——它服务的是我个人,原料却全部来自组织。
这让我对未来一两年有一个推测(只是推测,没验证过):个人工作 Agent 真正的资产,不是它用的模型,而是它编译出来的那份上下文。 模型每半年换一代,Muse 背后本来就配着主备两套模型;但那份「谁是谁、什么事还开着、我确认过什么、每一条出自哪里」的上下文,换任何模型都能接着用。它可以喂给写代码的 Agent,喂给帮你写周报的 Agent,喂给下一个你还没想到的 Agent。
这也和我在 过去只有富人和大公司买得起的服务,正在变成默认配置 里写的那条线接上了。过去,只有大老板才有一个替他盯住所有事、知道每件事出处的幕僚长。现在,这份幕僚长的「记忆」可以被编译出来——对一人公司的老板,这可能是第一次拥有它。
所以如果只记一句话:
先编译,再开口。 一个不知道「谁」和「何时」的主动 Agent,只是一个更勤快的噪声源。
最后留一个我还没想清楚的问题:Muse 现在只编译「我」的工作流。但一件事往往横跨好几个人——我的台账里「等别人交付」的那件事,在对方的台账里是「我要办」。如果团队里每个人都有一份编译好的个人上下文,它们之间该不该对账? 对账了,就离「组织数字员工」只差一步;不对账,每个人的 Muse 都只看到半件事。
你在用 AI 管理工作信息流时,卡在哪一步——是「谁」,是「何时」,还是「出处」?欢迎留言聊聊。