昨天那篇 每天 1000 条钉钉消息,我让一个 Agent 先编译再开口 是从一个 ❌ 开始的:我在单聊里问一位同事某件事要不要先做,他回了四个字「今天弄好」;5 分钟后,我的工作助理 Muse 把这句话当成急事推给了我——而我 7 分钟前就在和他聊这件事。
那次修的是推送时机。但这四个字之后一直在我脑子里,因为它暴露了另一个问题:同一件事,在我的台账里是「等别人交付」,在他那边是「我要办」。 Muse 只编译了我这一半。他那一半在他脑子里、在他的待办里,或者哪儿都没有。
把一个人的工作流编译成 AI 能用的上下文,444 那篇已经跑通了。这篇往上走一层:一个组织的工作流,能不能像程序一样,被一台编译器编成 AI 可以执行的上下文?
我的回答是能,但前提是把「编译器」这个类比当真——不是借个名字,而是把词法分析、符号表、中间表示、链接、增量编译一一对上,再老实承认它在哪里不成立。恰恰是不成立的那几处,决定了这台编译器该怎么设计。
一、「今天弄好」这四个字,AI 缺了什么
对我来说,这四个字足够明确。我知道他是谁、「弄好」指的是我上一条问的那件事、「今天」意味着下班前、这是一个承诺而不是客套。
一个只读到这条消息的 Agent,这些全都不知道:
- 「弄好」的是哪件事? 指代在上一条消息里,而且是我发的。
- 「今天」几点算到期? Muse 后来定的规则是:只写了日期的,按当天下班时间算。
- 谁负责、谁在等? 说话的人负责,我在等——但这层关系没有写在任何字段里。
- 这是承诺、建议还是客套? 「今天弄好」和「我看看」在台账里是两种东西。
- 他后来说「好了」,这件事在谁的账上关掉? 如果只关了他那边,我这边还会继续催。
这不是模型语言理解能力不够。问题在于,企业的真实状态并不以 AI 能可靠使用的形式存在。人靠社会关系和持续沟通,在脑子里实时维护一份组织状态;协同软件保存的只是沟通留下的记录。
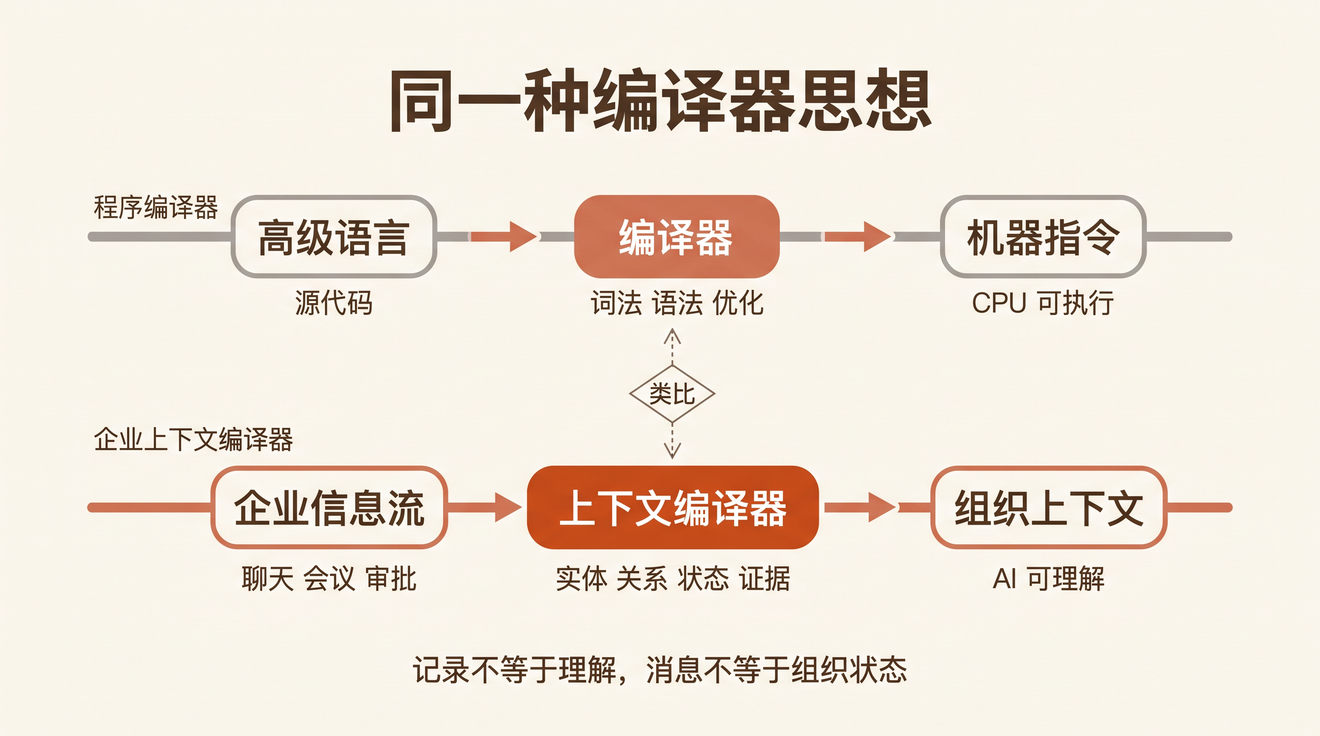
记录不等于理解,消息也不等于组织状态。
所以我们缺的可能不是一个更大的企业知识库——传统知识图谱项目为什么反复死在「知识获取瓶颈」上,我在 企业知识库新范式:从一亿预算到人在回路 里算过那笔账——而是一台 企业上下文编译器:把自然发生的工作过程,编成带语义、关系、状态和出处的组织模型。
二、把类比当真:一张对照表
高级语言经过编译器,变成 CPU 能执行的指令;人不用直接写机器码。企业里,人通过单聊、群聊、会议、文档、审批和待办工作;如果有一台编译器把这些编成组织上下文,人也就不用一遍遍向 AI 解释背景。
类比到这里还只是修辞。把编译器的每个阶段拆开,拿「今天弄好」走一遍,它才变成设计:
| 程序编译器 | 企业上下文编译器 | 「今天弄好」在这一步变成什么 |
|---|---|---|
| 源代码 | 单聊、群聊、会议、文档、审批、待办 | 一条单聊消息,加上它前面我的那句提问 |
| 词法分析 | 切分消息,识别发信人、时间、实体;判断这条是不是人发的(AI 代发、机器人) | 发信人是同事本人,不是代发;「今天」解析为当天下班时间 |
| 语义分析 | 消解指代,判断言语行为:承诺、决定、建议、客套 | 「弄好」指向上一条我问的那件事;这是一个承诺 |
| 符号表 | 通讯录编译出的人员与关系 | 他是谁、和我什么关系、能不能对这件事拍板 |
| 中间表示(IR) | 带证据的工作对象 | 一件事:他负责,我在等,截止当晚,出处是那条消息 |
| 链接 | 把不同人、不同系统的编译结果对上同一个对象 | 我的「等别人交付」和他的「我要办」是同一件事 |
| 增量编译 | 新消息只重编受影响的对象 | 他说「好了」,这件事在两边同时关闭 |
| 调试符号 | 每个字段都能对回原话 | 会话 + 消息 ID + 原话 |
| 代码生成 | 按读者的权限,给每个 Agent 生成它该看的上下文 | Muse 的推送卡片:「等别人交付」,截止前 1 小时才推 |
这张表是这篇的框架。它可以搬到我没写到的场景:销售的客户跟进(客户说「下周给你答复」)、项目的跨团队依赖(研发说「接口周三提测」),走的是同一条流水线,只是符号表和权威数据源不同。
这里要强调一个区别:编译不是把所有消息总结成一篇更长的文档。摘要的产物是给人读的一段话;编译的产物是一个可以被更新、被追溯、被确认的对象。原始消息仍然在,结构化对象随新消息变化,不确定的字段进入确认流程,而不是被模型的猜测填上。
这才是编译,而不只是摘要。
三、类比在哪里不成立
程序编译器能成立,靠的是几个前提:源代码无歧义、作者确定、只有一份源码、编译完不再变、产物对谁都一样。企业里这五条全都不成立。每一条不成立的地方,都对应一条设计约束。
1. 源代码没有歧义,工作消息有。 编译器遇到歧义就报错。企业编译器不能每条都报错,也不能靠猜。所以 IR 里的每个字段要分别标注把握程度:模型推测的只能当线索,代码核对过原话的算验证过,当事人确认过的才算事实。Muse 的规矩是 模型推测不能直接写进事实层,要么我在单聊里确认,要么代码核对过它引用的原话。在这台编译器里,人扮演的是类型检查器——不是每条都查,只查置信度不够、又会影响行动的那些字段。
2. 源代码的作者是确定的,消息的作者不一定。 Muse 上线两周,三次大错全出在「谁」上:助理被并进了主管本人,Muse 把自己代我写的话记成了我的待办,助理因为「部门主管」字段被算成了我的下属。每一条单独看都没错,错在「一个人一个账号」「用户发的就是人发的」「部门主管就是直属上级」这几个隐含假设。符号表本身也要被编译,这正是我在 通讯录不是人员列表,是企业本体的第一张骨架图 里坚持「先编可验证的事实」的原因。
3. 程序只有一份源码,组织没有单一事实来源。 承诺在聊天里,审批状态在审批系统里,合同金额在 CRM 里,库存在 ERP 里。链接器得知道每类字段以谁为准:审批状态以审批系统为准,承诺以原话为准。钉钉并不因为承载了沟通就自动拥有全部事实。
4. 程序编译完就不变,组织每分钟都在变,而且历史要留。 「截止时间从周三改到周五」不能简单覆盖旧值——一个月后有人问「当初到底定的哪天、谁改的」,答案得还在。所以组织上下文只能追加、带版本,不能原地改写。
5. 编译产物对谁都一样,组织上下文不行。 同一件事,负责人、等待方、他们的主管、一个旁观的项目数字员工,该看到的东西不一样。权限必须是代码生成的一部分,在上下文交给模型之前就裁好,而不是让模型读完全部再「注意别说出去」。
这五条约束,比「编译器」这个名字本身更值钱。
四、中间表示:每个字段都带着出处
现代编译器有 IR,是为了不让 M 种语言 × N 种 CPU 写出 M×N 套转换逻辑。企业里也是一样:群聊、会议纪要、审批、文档、待办是 M 个信息源,未来还会接 CRM、ERP;需要上下文的 Agent 有 N 个。如果每个 Agent 都自己去读原始数据、自己理解,就会出现每个 Agent 重复识别人和项目、对同一件事理解不一致、权限边界在不同执行链路里各管各的。
这还是一个成本问题。444 那篇里,Muse 的日记最早让模型带着工具自己翻素材,一次约 83 万 token;改成「代码先采齐、模型只调一次」之后约 6 万 token。一个人、一个 Agent 就有十几倍的差距;组织里 N 个 Agent 各自从原始消息读起,这笔重复阅读的账只会更大。
IR 的设计重点不在有哪些字段,而在每个字段是什么形状。我的做法是:IR 里没有裸值,每个值都带着证据和确认状态。 下面是「今天弄好」那件事在 IR 里的样子(示意,不是现有代码):
from dataclasses import dataclass
from datetime import datetime
from enum import Enum
from typing import Generic, Optional, TypeVar

T = TypeVar("T")


class Status(Enum):
    INFERRED = "inferred"    # 模型推测,只能当线索
    VERIFIED = "verified"    # 代码核对过原话
    CONFIRMED = "confirmed"  # 当事人确认过


@dataclass(frozen=True)
class Evidence:
    """一个字段凭什么这么写:出处会话、消息 ID、原话。"""
    chat_id: str
    message_id: str
    quote: str
    at: datetime


@dataclass(frozen=True)
class Fact(Generic[T]):
    """IR 里的每个值都带证据和确认状态,而不是一个裸值。"""
    value: T
    status: Status
    evidence: tuple[Evidence, ...] = ()


@dataclass(frozen=True)
class WorkItem:
    """组织上下文里的一件事。每次变更生成新版本,旧版本只追加不覆盖。"""
    item_id: str
    version: int
    title: Fact[str]
    owner: Fact[str]                  # 谁来做
    requester: Fact[str]              # 谁在等
    deadline: Optional[Fact[datetime]]
    state: Fact[str]                  # open / done / dropped

    def view_for(self, user_id: str) -> Optional[str]:
        """同一件事,在 owner 那里是「我要办」,在 requester 那里是「等别人交付」。"""
        if user_id == self.owner.value:
            return "我要办"
        if user_id == self.requester.value:
            return "等别人交付"
        return None
# generated by hugo AI
view_for 只有几行,却是「台账」和「组织上下文」的分界:台账是一个人的视图,组织上下文是那件事本身。
把 IR 的内容展开,至少有六类:实体(人员、部门、项目、客户)、关系(汇报、协作、负责、依赖)、事件(决策、承诺、变更、审批、交付)、状态(进展、截止、阻塞、下一步)、规则(制度、授权边界、执行条件)、证据(出处、时间、版本、确认记录)。前五类知识图谱也有;第六类,才是企业上下文和普通知识库、向量检索的根本区别——检索给你一段相关的话,IR 告诉你一个事实、为什么相信它、谁确认过、什么时候该重新确认。
五、链接:从个人编译单元到组织上下文
这是 444 那篇结尾留下的问题:我的台账里「等别人交付」的那件事,在对方的台账里是「我要办」——它们之间该不该对账?
用编译器的语言说,每个人的 Muse 编出来的是一个 编译单元,里面有大量「外部符号」:我等的那个交付、我答应别人的那件事。单独看每个编译单元都完整,合起来才是组织。把它们对上的那一步,就是链接。
   我的信息流              同事的信息流             审批 / 待办 / CRM
       │                       │                         │
       ▼                       ▼                         ▼
  编译单元:我             编译单元:同事             系统事实源
  「等他交付」             「我要办」                 审批状态、合同金额
       │                       │                         │
       └───────────┬───────────┘                         │
                   ▼                                     │
   链接器:按出处消息 ID 对上同一件事  ◀─────────────────┘
           字段冲突时按权威源裁决,裁决不了就去问人
                   │
                   ▼
   组织上下文:共享 IR,带证据、带版本
                   │  按读者权限生成视图
       ┌───────────┼───────────────┐
       ▼           ▼               ▼
   我的 Muse     同事的助理      项目数字员工
# generated by hugo AI
链接的键,我倾向于用出处消息本身。「今天弄好」这条消息,我和同事都在那个单聊里,两边的编译单元引用的是同一个消息 ID——这是比「标题相似度」可靠得多的对齐依据。
444 那篇里有个反面例子:Muse 有两个观察者账号(它自己和我),同一个单聊两边看到的「对方」互为对方,一条看似天经地义的规则就把助理的话算到了我头上。那其实就是一个个人尺度的链接错误。到了组织尺度,同一条消息会被更多观察者看到,链接规则必须先过这一关。
链接带来两样个人编译给不了的东西:
- 没人需要再「同步状态」。 他说「好了」,这件事在他那边关闭,在我这边也关闭。不用他再来告诉我一遍,也不用我的 Muse 去催。
- 冲突会浮上来。 如果我的编译单元认为截止是今晚,他的认为是明天,这个分歧本身就是一个值得确认的信号——在个人编译里,它永远不会被发现。
还要说清楚:组织尺度的链接我还没有跑通。 上面是设计推演,个人尺度的部分有 444 的实测做底,组织尺度的部分是推测。
六、增量编译:组织上下文是一个持续运行的进程
如果上下文靠人工整理,它很快就会过期。所以这台编译器不是每天跑一次的批处理,而是一个常驻进程:订阅消息、会议、文档、审批和待办,新事件进来,只重编受它影响的对象。
「好了」这条消息进来时,编译器要回答的是:它影响了哪个对象(靠指代和出处链接到「今天弄好」那件事)、改了哪个字段(state 从 open 到 done)、这个变化的把握程度(「好了」是原话,代码可以核对)、谁的视图要刷新(我和他),以及旧版本是否保留(保留,只追加)。
整条流水线可以写成「采集 → 解析 → 关联 → 编译 → 校验 → 确认 → 分发 → 反馈」,每一步的工程细节我在 439 那篇里按 Ingest / Normalize / Compile / Validate / Serve 拆过,这里不重复。值得单独强调的只有一点:确认和反馈不是流水线的附属品,而是它的一部分。 人纠正一次,编译器就多一条确认记录;同样的快照加同样的确认记录,一定编出同样的结果——出了错能回放,改了规则能对比。
这些都不是纸上推演。444 里 Muse 的四层编译栈(raw / facts / events / knowledge)每层只有一个写入者,原始快照保留 45 天用来回放,模型推测必须经确认才能进事实层。个人尺度这几件事已经跑通;组织尺度多出来的,是第五节的链接、第三节说的多事实源,以及权限。
七、最强的反对意见
反方一:这不就是主数据管理(MDM)或知识图谱换了个名字?
这是最有分量的一条。我的回应是:MDM 编译的是系统里已经结构化的记录——客户主数据、物料编码、组织架构。但「今天弄好」这类承诺、会上拍的板、群里一句「这个先不做了」,从来不在任何系统里,MDM 碰不到。知识图谱项目碰到了,但它的原料是人工录入,死在获取成本上。企业上下文编译器的原料是工作过程本身,人只在置信度不够时确认一下——我的判断是,确认一个字段的成本远低于从零录入它,但这点在组织尺度还没有数据。
但反方说对了一半:本体怎么定义、实体怎么消歧,这些老问题一个都没消失。编译器解决的是「原料从哪来、怎么保鲜」,不解决「世界该怎么建模」。后者在 439 那篇里我也只做了通讯录这一块。
反方二:上下文窗口越来越长,直接把原始消息喂给模型不就行了?
个人尺度的回答 444 写过:长窗口不会让重复阅读变便宜,修不了身份错误,也不提供跨会话的记忆和确认。组织尺度还要再加一条:长窗口解决的是「一个 Agent 读得下」,解决不了「十个 Agent 对同一件事的理解一致」。
反方三:编译全组织的对话,是不是在监视员工?
边界要靠架构,不能靠承诺。我坚持的一条规则是:你能看到一个字段,当且仅当你能看到它的证据。 链接器可以知道我的「等他交付」和他的「我要办」是同一件事,但我的视图里只出现我本来就在场的那些出处;他和别人单聊里关于这件事的讨论,不会因为链接就流到我这边。配置缺失、角色查不到,一律拒绝。
但技术边界替代不了组织共识。哪些会话可以进编译器、谁有权看谁的视图,这是治理决定,不是工程决定。
八、钉钉的机会:从协同软件到组织上下文基础设施
如果这个判断成立,AI 时代的协同软件就多了一个方向:过去它的价值是连接人、传递信息、记录工作、推动流程;以后它还可以把这些工作过程,持续编译成 AI 能用的组织上下文。
钉钉天然处在这个位置。它承载着身份、组织关系、消息、会议、文档、审批和待办——也就是对照表里的源代码和符号表。它不需要再发明一套让员工手工维护的知识录入系统,而是可以在获得授权的前提下,从真实工作过程里持续编译。
在这个架构里,钉钉是工作信息与协作的入口,企业上下文是 AI 理解组织的基础层,Agent 是理解任务并推动工作的执行主体,权限、评估和审计保证执行可控、可验证。数字员工要的组织身份、岗位职责、工具权限和评估机制怎么一层层搭起来,我在 数字员工背后的 Agent,是五层基础设施的叠加 里拆过;企业上下文是那几层下面的地基。
这不是给协同软件加一个 AI 聊天入口,而是让协同软件持续生产 AI 工作所需要的组织上下文。
九、一个更大的判断
程序编译器出现后,人不再直接写机器指令。
企业上下文编译器如果成立,人也不必再把大量时间花在向 AI 解释组织背景、重复同步工作状态、手工整理协作信息上。人继续用自然的方式沟通、判断、做决定;系统从这些过程里提取事实、识别关系、维护状态;Agent 在这份上下文和授权边界内,接过越来越多的执行。
企业不再只是一个存储信息、供人协同的系统,也可以成为一个能被 AI 持续理解和参与的系统。
高级语言编译成 CPU 可执行的程序;钉钉的信息流,可以被编译成 AI 可理解的组织。
回到「今天弄好」。在今天的组织里,这四个字的命运取决于两个人的记性:他记得要做,我记得在等。如果你的团队里也有一类总在两个人之间丢掉的事——承诺、交付、改期——它最常丢在哪一步:是没人记下来,是两边记得不一样,还是做完了没人知道?欢迎留言聊聊。