写给已经在用 Coding Agent 写代码的工程师。
前两篇文章(《用 SPEC 和 Evals 把数字员工做成一个能自我改进的系统》、《做好一个钉钉数字员工,只有三件事》)讲的是 单个系统怎么建:SPEC、Evals、基建。
这篇想往前站一层,谈整个研发组织的问题:当 10 倍效率成为明确的战略要求时,瓶颈就从「怎么建系统」转移到了「组织里谁在建、怎么验收、怎么分配杠杆」。
本文的思考来自最近一场内部工程管理会议,结合 AI Native 工程实践,尝试回答一个问题:当 AI 开始承担绝大部分代码生产工作,研发组织应该如何重新设计?
一、10 倍是一个范式判断,不是 KPI
先说会上最容易被听成口号的那句话:
必须实现研发效率的 10 倍提升,而不是靠加班换来的平均值微增。
这句话的真正含义,不是要求每个人写代码快 10 倍,而是要重新定义研发的生产方式。
会上有几个非常直观的案例:
- 过去需要上百人协作完成的项目,现在应该能够由 2 个人在一个月内交付 POC。
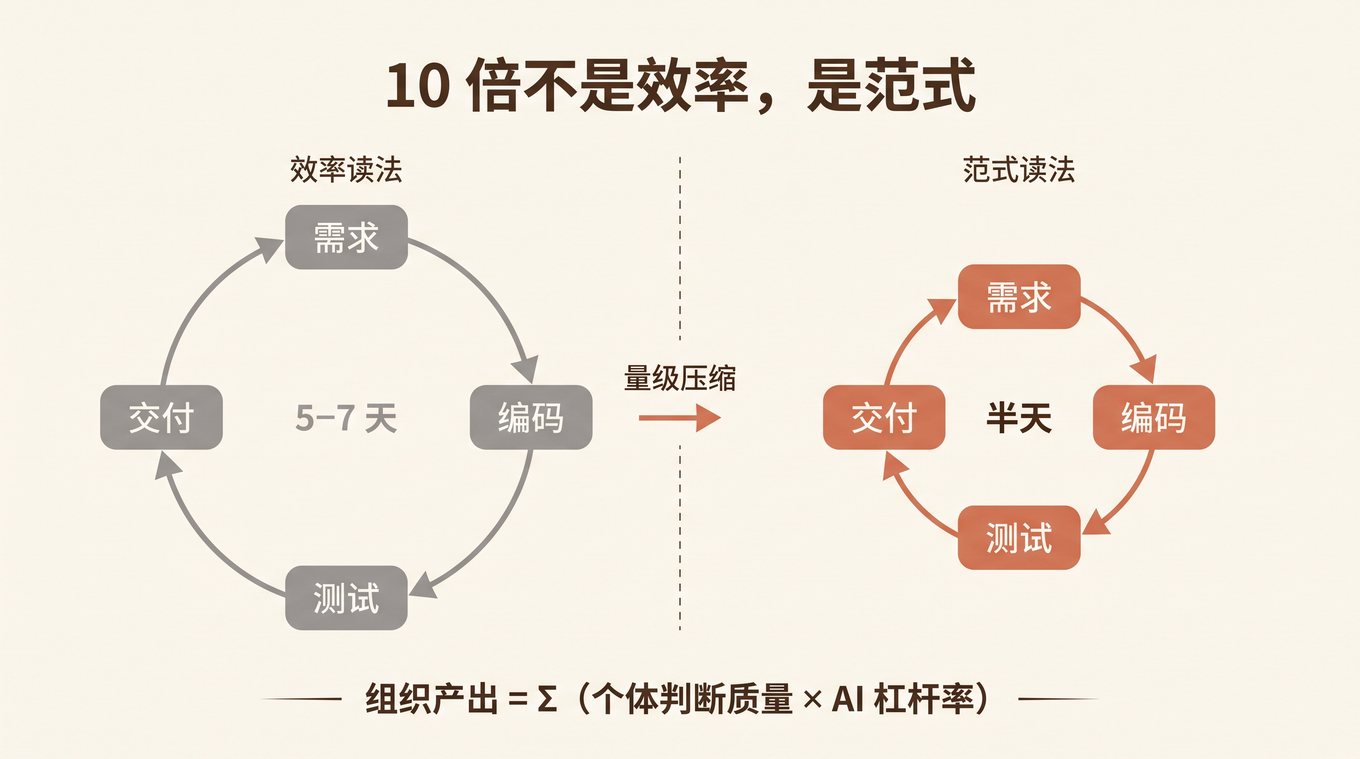
- 过去需要 5–7 天才能闭环的单片机应用,现在 AI 半天就能完成,而且质量更好。
- 人脸识别这类涉及硬件接入、数据录入、算法调优的完整闭环,现在可以半天搭建,准确率达到 80% 以上。
这些案例有一个共同点:改变的不是某个环节的速度,而是从需求到结果的整个闭环时间。
以单片机为例,AI 不仅能生成代码,还能根据测试结果反复调整双击识别算法,最终得到更好的效果。
过去,工程师可能需要花几天时间完成一次修改、编译、测试和调优。现在,这个循环可以压缩到小时甚至分钟。
这意味着什么?
当一次试错的成本足够低,原来因为时间和人力成本而不敢尝试的优化,就变得值得尝试。工程师可以在相同时间内探索更多方案,验证更多假设,最终获得更好的结果。
10 倍效率的本质,是研发闭环时间的量级压缩,以及由此释放出来的优化空间。
这也意味着,研发组织的瓶颈发生了根本性变化。
过去,研发效率主要受限于代码生产能力:需求来了,需要工程师设计、编码、联调、测试。
现在,Coding Agent 已经能够承担大量代码生产工作。代码本身越来越便宜,真正稀缺的开始变成:
- 能否正确理解需求?
- 能否把需求定义成明确的工程规范?
- 能否判断 AI 交付的结果是否正确?
- 能否发现系统性副作用?
- 能否建立自动化机制,让系统持续变好?
当写代码的成本趋近于零,瓶颈就从「写」转移到了「判」。
所以,10 倍效率的真正上限,不取决于组织有多少程序员,而取决于组织有多高的判断密度。
判断这一侧的变化我在 品味不是一块,是三半:其中一半正在贬值 里写过:对最佳实践的理解正在被模型吃掉,判断结果好坏的能力在涨价。组织层面的「判断密度」,就是这笔涨价的总量。
过去上百人才能完成的项目,现在 2 个人一个月交付 POC,前提是这两个人能够高质量地定义问题、组织 AI、建立验收标准,并证明交付结果确实满足要求。
否则,2 个人一个月交付的不是 POC,而是一堆没人敢上线的代码。
二、AI 可见环境:AI Native 工程的第一性投资
会上对 AI Native 工程有一个非常重要的判断:
给 AI 提供完整的可见环境:代码、日志、屏幕、中间件、Token 消耗,使它能够像人类一样操作和优化。
我认为这是 AI Native 工程最重要的基础设施之一。
为什么?
因为一个 Agent 要真正具备工程能力,必须形成完整的反馈闭环:
观察 → 归因 → 干预 → 验证
  ↑                 ↓
  └──── 持续优化 ────┘
# generated by hugo AI
四个环节缺一不可。
1. 观察:让 AI 看见完整的现场
不能只给 AI 一段错误日志,也不能只把问题人工总结成几句话。
AI 应该能够访问:
- 完整代码和项目结构;
- 运行日志、异常堆栈和系统状态;
- 浏览器、屏幕和真实交互过程;
- 数据库、中间件和外部依赖;
- 工具调用参数、执行结果和错误信息;
- 模型调用、Token 消耗和执行时间。
只有获得足够完整的上下文,AI 才有可能理解问题真正发生在哪里。
2. 归因:让 AI 自己分析为什么发生
人工摘要可以帮助 AI 快速定位,但不能完全替代 AI 对现场的观察和分析。
如果每次都由人先判断问题,再把结论交给 AI,AI 最终只会成为一个代码执行工具,而不是能够独立解决问题的工程 Agent。
我们需要让 AI 自己建立问题与原因之间的联系。
3. 干预:让 AI 能够直接修改系统
AI 不应该只给出建议,还应该能够修改代码、调整配置、优化 Skill、改变执行路径,甚至修改其他 Agent 的行为规范。
从修改代码,到修改运行时,再到优化整个 Agent 系统,这是 AI Native 工程能力的重要进阶。
4. 验证:让 AI 能够证明修改有效
任何一次修改,都必须有可观测、可重复的验证过程。
不能因为代码编译通过、单元测试通过,就认为问题已经解决。
真正的验证应该覆盖用户行为、系统状态、异常场景和副作用。
这里有一个容易被忽略的问题:
如果 AI 看不到完整的执行现场,就无法真正形成自我改进的闭环。
因此,我认为 AI 可见环境应该成为研发基础设施的第一性投资。
日志、Trace、工具调用记录、运行时状态、Token 消耗,不应该是发生问题后才补充采集的数据,而应该从一开始就是系统的标准组成部分。
全量记录不是为了留档,而是为了让 AI 有能力理解自己做过什么、为什么这么做,以及下一次应该如何做得更好。
三、用 Spec + Eval 重构整个测试体系
这是本次工程管理会议的核心议题之一。
传统软件测试体系,很大程度上依赖历史 Bug、人工测试经验和测试人员对产品的理解。
这些东西仍然有价值,但在 AI Native 时代,仅靠历史数据和人工经验已经不够了。
我们需要把产品质量要求变成 AI 可以理解、执行和验证的明确规范。
Spec 定义什么是正确的,Eval 验证是否真的正确。
这是我此前在 Evals 是新的 PRD 里那个判断的组织版:当判据可以被机器执行,需求文档的形态本身就会改变。
会上提出了几个方向:
1. 从历史数据驱动转向 Spec 驱动
过去,我们经常根据历史用户行为、历史 Bug 和已有测试结果来判断新版本是否合格。
但历史行为不等于正确行为。
如果一个产品过去一直存在某种体验问题,那么仅仅学习历史数据,反而可能把错误固化下来。
正确的方式应该是:
- 历史数据提供真实场景和测试样本;
- 产品和技术共同定义正确的行为标准;
- Spec 提供明确的判据;
- Eval 根据判据自动执行和验收。
历史数据应该是测试用例的来源,而不是正确性的最终标准。
2. 产品和技术共同定义 Spec
Spec 不能只是技术人员写的接口文档,也不能只是产品经理写的需求说明。
它应该把产品体验和工程质量共同转化为机器可以执行的标准。
例如:
- 界面元素是否遮挡;
- 国际化是否符合规范;
- 页面交互是否符合平台设计规范;
- P0、P1 问题如何分级;
- 弱网、断网和大文件场景是否能够正常工作;
- 高并发情况下是否存在性能退化;
- 与竞品相比,核心体验是否存在明显差距。
这些标准应该成为 AI 可以直接读取和执行的 Spec,而不是停留在文档里。
3. 建立两类自动化测试体系
第一类是暴力测试。
通过断网、大文件、高并发、异常输入、极限操作等方式,持续挑战系统边界。
这类测试的目标是发现系统在极端条件下的缺陷,确保产品质量底线不退化。
第二类是基础体验验收。
由产品团队主导定义核心用户场景,让 AI 自动操作产品,检查交互细节、体验一致性和功能完整性,并生成结构化测试报告。
这类测试的目标不是简单验证功能是否可用,而是判断产品体验是否达到预期。
两类测试共同构成产品质量的自动化保障体系。
4. 每个 Bug 和 Feature 都必须沉淀测试用例
这是一个非常重要的工程原则。
发现 Bug,修复 Bug,然后结束任务,这在 AI Native 工程里是不够的。
每次发现问题,都应该补充对应的测试用例;每次新增 Feature,都应该补充对应的验收标准。
否则,下次 AI 修改相邻代码时,同样的问题可能再次出现。
测试用例应该持续积累,形成 Markdown 格式的知识库,作为 AI 测试和工程执行的上下文。
但还需要强调一点:
知识库不是文档仓库,而是 AI 的可执行知识系统。
如果一条经验只被写进 Markdown,却没有任何工具能够在正确的时机读取它,那么这条经验就很难真正发挥作用。
知识必须被工程流程消费:
- Spec 被运行时和评测系统读取;
- 测试用例被 CI 自动执行;
- Bug 经验被相关 Agent 检索;
- 质量标准被验收流程强制执行。
只有这样,知识才能真正变成组织能力。
5. 建立端到端的自动化工程链路
最终,我们希望实现:
问题发现
   ↓
自动生成 Issue
   ↓
Coding Agent 分析问题
   ↓
生成修复方案
   ↓
自动修改代码
   ↓
自动执行 Eval
   ↓
验证通过
   ↓
提交 PR
   ↓
持续回归
# generated by hugo AI
CodeX、多 Agent 协作、统一账号环境和自动化测试体系,都是为了让这条链路尽可能自动化。
工程师的主要工作不再是逐行编写代码,而是定义目标、建立判据、审查关键决策,并处理 AI 无法独立解决的问题。
四、前 5% 人才:AI Native 时代的杠杆分配
如果说前面三节讨论的是工程系统,那么这一节讨论的是组织。
我认为 AI Native 时代,工程组织的产出模型正在发生变化。
可以用一个简单的公式表达:
组织产出 = Σ(个体判断质量 × AI 杠杆率)
# generated by hugo AI
传统工程组织里,工具和流程相对标准化,人与人之间的生产效率差异虽然存在,但组织整体产出仍然较大程度上取决于人头数量。
AI 改变了这个关系。
AI Native 工程师之间的杠杆率差异可能不是 10%,而是一个数量级。
为什么?
因为真正决定 AI 杠杆率的,不是会不会使用 Coding Agent,而是以下四种能力:
1. 环境构建能力
能否为 AI 构建完整的可见环境?
能否把代码、日志、数据、运行状态和工具链开放给 AI,让它具备独立理解和操作系统的能力?
2. 判据定义能力
能否把模糊需求转化成清晰的 Spec?
能否定义什么是正确、什么是错误,以及什么情况下应该拒绝执行?
3. 验证闭环能力
能否建立 Eval 和自动化测试体系?
能否让 AI 自己验证修改结果,并发现副作用?
4. 全链路掌握能力
能否理解模型训练、数据、标注、推理和应用之间的关系?
能否跨越传统的专业分工,把整个系统串联起来?
这四种能力相互叠加,决定了一个人能够驾驭多大的 AI 杠杆。
同一个模型,交给不同的人,最终产出可能完全不同。
能力不足的人,AI 放大的是他的错误;能力足够强的人,AI 放大的是他的判断。
这也意味着,传统的平均主义资源分配方式可能不再适合 AI Native 组织。
组织应该把更多资源分配给能够创造更大杠杆的人。
但这里有一个必须补充的判断:
前 5% 人才不是简单从现有员工里筛选出来的,而是需要通过新的工程环境培养出来的。
校招生也有机会在开放的工程环境和高挑战任务中,快速成长为 AI Native 工程师。
这种培养方式与传统的培训体系不同。
不是先学习几年基础知识,再逐步承担复杂任务,而是让新人尽早进入真实项目:
- 给他完整的 AI 工程环境;
- 让他承担有挑战性的任务;
- 要求他自己定义 Spec;
- 让 AI 承担主要执行工作;
- 用 Eval 和真实结果持续验收;
- 在不断失败和修正中提升判断力。
本质上,识别人才和培养人才可以使用同一套机制。
组织需要的不是更多会使用 AI 工具的人,而是更多能够驾驭 AI、定义问题、建立系统和交付结果的人。
人才两极分化带来的组织震荡是真实存在的。解法不是降低对高绩效的要求,而是把人才培养通道本身工程化。
五、闭环的最后一环:所有成绩都是一条测试用例
会上还有一句 KP 的原话,我认为是整场会议最值得刻进工程文化的话:
「任何一个东西都要补。成绩个毛啊,你最后的所有的成绩就是一条测试用例啊。那测试用例你不应该补上这一条吗?你发现了 bug,你不补一个测试用例,你等到下次怎么知道要不要再跑一次呢?」
这句话看起来很朴素,但背后其实是 AI Native 工程最重要的知识沉淀机制。
过去,我们经常把工程成果理解为:
- 完成了一个 Feature;
- 修复了一个 Bug;
- 优化了一个性能指标;
- 解决了一个线上问题。
但在 AI Native 工程里,这些都不应该是最终成果。
真正的成果,是把这次解决问题的经验变成下一次可以自动执行的测试用例。
为什么?
因为如果一个 Bug 被修复了,却没有补充测试用例,那么系统就没有真正记住这次教训。
下一次有人修改相邻代码,或者另一个 Coding Agent 重新生成这部分逻辑,同样的问题仍然可能发生。
修复只是解决了当下的问题,测试用例才是约束未来不再犯错的机制。
因此,需要建立几个基本原则:
- 关键测试用例只增不减;
- 新增用例先验证能够发现问题,再验证修复通过;
- 关键用例退化,直接判定版本不合格;
- 删除测试用例不能让评测结果变好;
- 测试应该验证实际行为,而不是仅仅验证代码或文案形式。
这里还有一个容易忽略的问题:
知识沉淀必须有明确的消费者。
一条经验放进 Markdown,如果没有工具会在正确的时间把它交给正确的 Agent,它就只是一篇没人看的周报。
所以,知识库必须与 Spec、Eval、CI 和 Agent 的执行流程绑定。
只有能够被读取、被执行、被验证的知识,才真正构成组织资产。
从这个角度看,KP 的那句话可以进一步抽象成一个工程原则:
任何一次成功,都应该让下一次成功变得更容易;任何一次失败,都应该让同样的失败更难再次发生。
六、组织层面的三个待验证命题
把这次会议的判断放在一起,我认为有三个命题值得在接下来一段时间持续验证。
命题一:Spec 生产率能否规模化?
单个系统可以依靠产品和技术团队手工打磨 Spec。
但对于一个完整的 App 产品线,涉及大量界面交互、国际化、性能、兼容性和异常场景,Spec 的生产本身可能成为新的瓶颈。
谁来把「界面遮挡」「P0/P1 分级」「国际化规范」翻译成机器可执行的判据?
未来需要的不只是 Spec,而是一条 Spec 生产线。
验证口径:
能否在一个月内,把核心产品体验和质量标准转化为可机械执行的判据,并且随着判据积累,新场景的定义成本持续下降。
目前第一个 P0 已经落地:搭建同类对比测试工程,建立质量工程标准。
命题二:竞品盲评能否建立客观的组织机制?
自己和自己比较,可以发现版本退化。
但真正的产品竞争力,需要自己和竞品比较。
这里有几个问题需要解决:
- 谁来定义对比维度?
- 谁来制定评分标准?
- 如何避免评测人员的主观偏差?
- 如何保证竞品环境和测试条件一致?
- 如何让最终结果可以量化、复现和追溯?
验证口径:
产出第一份与市场上最直接对标产品的暴力测试对比报告,确保测试环境一致、结果可复现、结论可追溯。
命题三:人才两极分化的组织承载力如何建立?
AI Native 组织需要高杠杆人才,也必然会出现更大的个体产出差异。
高绩效人才应该获得更大的资源和激励,持续无法适应新生产方式的人也需要面对调整。
但组织不能只做存量筛选。
培养通道必须能够持续输送新的人才,否则组织在完成一轮调整之后,可能反而失去长期增长能力。
验证口径:
年底前,观察校招生在真实项目中独立完成端到端闭环交付的比例,第一批新人是首批样本。
结语:重新定义工程师的价值
前两篇文章的结论是:做好一个 AI 系统,需要三件事——SPEC、Evals、基建。
这场工程管理会议,则把这个结论放大到了整个研发组织,并且加入了最重要的一个变量:人。
三个层次拼起来,才是完整的 AI Native 工程:
- 效率层: 10 倍来自研发闭环时间的量级压缩,判断密度决定效率上限。
- 工程层: AI 可见环境是第一性投资,全量记录和自动验证是形成自我改进闭环的基础。
- 组织层: 人才杠杆率决定组织产出,而培养通道决定组织能否持续提高人才密度。
AI 时代,工程师的价值正在重新定义。
过去,优秀工程师的价值很大程度上体现在解决复杂问题的能力,以及把解决方案转化为代码的能力。
现在,代码生产越来越多地交给 AI,工程师的核心价值开始转向:
定义问题、构建环境、制定判据、组织 AI、验证结果,以及让系统持续自我改进。
如果只允许带走一句话,我会选 KP 那句最朴素的话:
你最后所有的成绩,就是一条测试用例。
它同时是效率论、质量论和人才论的最小公分母:
- 效率,是让一次成功可以被重复;
- 质量,是让一次失败不再重复;
- 人才,是能够把经验变成系统能力的人。
这就是我理解的 AI Native 工程:不是让工程师写代码快 10 倍,而是让整个组织具备持续创造、验证和进化的能力。