前阵子给工作助理 Muse 算账的时候,我发现一个很尴尬的数字:它每天写一篇工作日记,最早的做法是让模型带着工具自己去翻素材,一次要烧掉约 83 万 token,因为同一份上下文被来回重发了 9 次左右。改成「代码先把素材采齐、模型只调用一次」之后,降到约 6 万 token,耗时几乎不变。
省钱只是表面。更让我在意的是,第一种做法里模型每次都在 重新理解同一批原始消息:谁是谁、哪句话是承诺、哪件事已经关掉了。理解了一遍又扔掉,下次再来一遍,而且每次理解的结果还不完全一样。
这件事让我对知识编译(Knowledge Compilation)形成了一个明确的判断:
目前实现知识编译最合适的工程范式,是 Harness Engineering + Models。模型负责理解和推理,Harness 负责把理解和推理变成一个可靠、可持续运行、可评估、可迭代的工程系统。
这个边界很重要。只有模型,你得到的是一次次聪明但不可复现的理解;只有 Harness,你得到的是一套规则写死、碰到自然语言就失效的 ETL。两者分开各管一摊,知识编译才能成为一个工程系统。
我在 从程序编译器到企业上下文编译器 里讲了「企业上下文编译器」是什么:词法分析、符号表、IR、链接、增量编译怎么一一对上。这篇不重复那个类比,回答的是下一个问题:用什么工程范式把它造出来,以及怎样把它抽象成一套通用的知识编译架构。
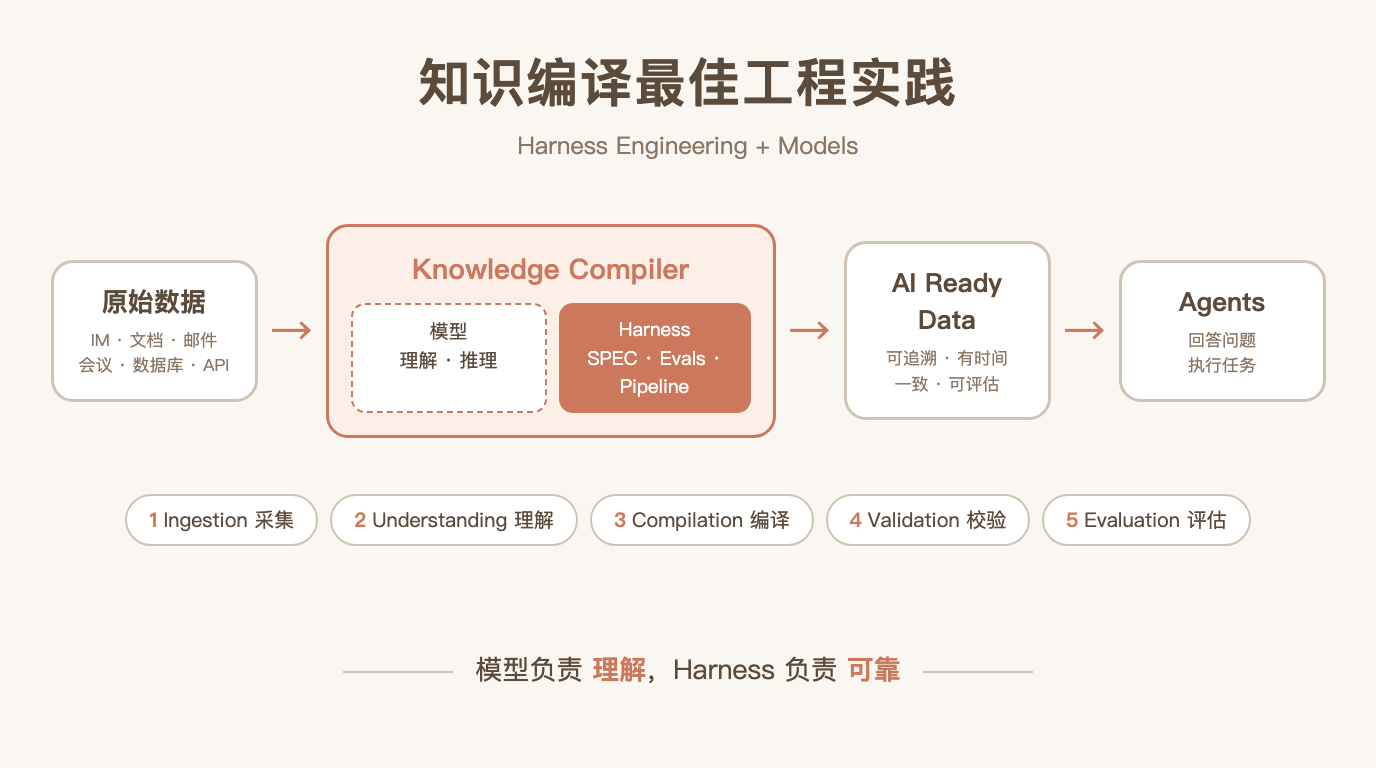
一、知识编译的整体架构
先给全貌。从原始数据到 AI 应用,一共四层,中间两层是这篇的重点:
Raw Data 原始数据
│  IM / 文档 / 邮件 / 会议 / 数据库 / API / 文件
▼
Knowledge Compiler Harness
│  模型 + SPEC + Tools + Pipeline + Evals + Runtime
│
│  1. Ingestion      数据采集、解析、标准化
│  2. Understanding  实体识别、关系抽取、语义理解
│  3. Compilation    本体映射、知识结构化、上下文构建
│  4. Validation     事实校验、冲突检测、来源追溯
│  5. Evaluation     质量评估、回归测试、持续优化
▼
AI Ready Data
│  结构化事实 / 实体关系 / 知识图谱 / 语义索引 / Memory / Metadata
▼
Knowledge Serving Pipeline
│  Retrieval / Query / Context Assembly / Agent Tools
▼
AI Applications / Agents
   理解组织、回答问题、执行任务、辅助决策
# generated by hugo AI
五个编译阶段里,模型真正不可替代的只有第 2 步和第 3 步的一部分:理解一句话指的是什么、它是承诺还是客套、该映射到本体里的哪个概念。其余的事,采集、标准化、校验、追溯、评估、回归,全是确定性的工程问题,应该由 Harness 用代码来做。
各阶段的工程细节,我在 通讯录不是人员列表,是企业本体的第一张骨架图 里按 Ingest / Normalize / Compile / Validate / Serve 拆过,这里不展开。这篇关心的是另外三件事:职责怎么分、产物长什么样、编译和使用为什么要分开。
二、为什么 Harness + Model 是最佳实践
关键在于两者的职责分离:
| 工程组成 | 核心职责 |
|---|---|
| Model | 理解、推理、抽取、归纳、判断 |
| SPEC | 定义知识结构、编译规则和质量标准 |
| Tools | 数据读取、查询、写入、验证 |
| Pipeline | 编排任务、增量处理、依赖管理 |
| Evals | 评估知识准确性、完整性、一致性 |
| Runtime | 调度、隔离、权限、资源管理 |
| Feedback Loop | 从人工反馈和线上效果持续改进 |
这张表可以用一句话读:不确定的事交给模型,确定的事交给代码,二者的边界写进 SPEC,边界守没守住交给 Evals。
为什么边界一定要显式写出来?因为模型最擅长的「理解」,恰好也是它最容易越界的地方。我在 做好一个钉钉数字员工,只有三件事 里写过一个例子:为了让数字员工在被主管夸奖时回一句谢谢,我们给判据加了一条更「完整」的长版说明。目标用例修好了,误开口却从 6 例涨到 17 例,因为模型把主管其它带「你」的话也读成了在夸它。模型的理解能力没有问题,问题是没有 Harness 去度量它理解出来的边界。最后是全集 Eval 发现了这个问题,SPEC 换成了更短的判据。
知识编译面对的是同一件事,只是规模更大:一个模型每天要把上千条消息编译成事实,每一条「理解」都可能偏一点。没有 SPEC 约束、没有 Evals 度量,这些偏差会悄无声息地进入知识库,再被每一个下游 Agent 当成事实使用。
这里有一个非常重要的认识:
知识编译不是一次性的 ETL,而是一个持续运行的 AI Engineering System。
| 传统 ETL | AI Knowledge Compiler | |
|---|---|---|
| 输入 | 结构化或半结构化数据 | 非结构化数据:消息、会议、文档 |
| 转换逻辑 | 预先定义规则 | 模型理解,按 SPEC 生成结构化知识 |
| 数据流向 | 数据经过固定转换 | 编译 → 评估 → 修正 → 再编译 |
| 质量保证 | 规则写对了,结果就对 | 通过 Evals 判断编译质量 |
| 出错之后 | 改规则,重跑 | 人工反馈修正错误;Harness 记录失败案例,形成回归测试 |
| 时间维度 | 一次性产出结构化数据 | 后续迭代持续提高编译质量 |
差别的根源在于:ETL 的规则是确定的,规则对了结果就对,所以它可以跑一次就交付。知识编译的「规则」有一半在模型里,模型的输出是概率性的,换一个模型版本、换一批数据,质量就可能漂移。一个含有概率性部件的系统,只能靠持续评估来维持质量。 这就是为什么 Evals 和 Feedback Loop 必须是编译器的一部分,而不是上线前做一次的验收。
Muse 上线头两周的三次大错都出在「谁」上:助理被并进了主管本人,Muse 把自己代我写的话记成了我的待办。修法不是换一个更强的模型,而是让人的每次纠正都留下一条确认记录:同样的原始快照加同样的确认记录,一定编出同样的结果,出了错能回放,改了规则能对比。这正是 数字员工的自我进化:从 Harness 开始 说的那条路径:自我改进先发生在 Harness 层,原料是真实生产数据。
三、AI Ready Data 应该如何定义
我建议不要把 AI Ready Data 简单理解成向量化后的数据。向量化解决的是「找得到相关的一段话」,解决不了「这段话说的事现在是否还成立、谁说的、和别处的说法矛不矛盾」。
AI Ready Data 至少应该具备六个特征:
| 特征 | 说明 |
|---|---|
| Structured | 结构化,有明确 Schema |
| Semantic | 有语义和本体定义 |
| Traceable | 每条事实可以追溯原始来源 |
| Temporal | 有时间、版本、有效期 |
| Consistent | 实体、关系、事实之间保持一致 |
| Evaluatable | 可以自动评估正确性和质量 |
举个例子。钉钉里一条群消息(假设发在 2026 年 11 月 3 日,周二):
下周三之前,张三把新版合同给李四确认。
编译之后的 AI Ready Data:
{
  "type": "work_item",
  "title": "新版合同交付",
  "owner": "张三",
  "collaborators": ["李四"],
  "deadline": "2026-11-11",
  "status": "pending",
  "source": {
    "type": "group_message",
    "message_id": "xxx"
  },
  "confidence": 0.96
}
# generated by hugo AI
这时它已经不再只是一条消息,而是一条可以被 Agent 理解、查询、提醒和执行的知识。
拿六个特征逐条对一下这条记录,能看出哪些是模型的活,哪些是 Harness 的活:
- Structured:
type、owner、deadline有固定 Schema。Schema 由 SPEC 定义,模型只负责往里填。 - Semantic:
work_item是本体里的一个概念,不是模型随手起的名字。把「把合同给李四确认」理解成一件待办,是模型的工作。 - Traceable:
source.message_id指回原话。出处必须由 Harness 在采集时附上,不能让模型去「回忆」出处。 - Temporal:「下周三」被解析成
2026-11-11。相对时间的解析看起来是理解,其实应该交给代码,模型只负责认出「下周三」是一个截止时间。 - Consistent:
owner写成「张三」两个字,在组织里还不够。公司里可能有两个张三,真正的写法应该是一个实体 ID,名字只用来展示。这一步是对着通讯录做实体消歧,属于 Harness 和符号表的职责。 - Evaluatable:
confidence给了一个把握程度,source让 Eval 可以回到原话核对。低于阈值、又会触发提醒的字段,应该进入人工确认,而不是直接生效。
逐条对下来会发现:六个特征里,模型主要贡献的是 Semantic,其余五个主要靠 Harness 保证。 这也是为什么我说知识编译的质量上限由模型决定,但生产质量由 Harness 决定。
四、Compiler 与 Serving 必须分离
这是架构上很重要的一点:不要让每次 Agent 查询都重新理解原始数据。
开头 Muse 的账就是反例。让模型在每次使用时从原始消息读起,花的钱是编译一次的十几倍;更麻烦的是,每次理解的结果可能不一样,今天的日记和明天的待办提醒,对同一件事的判断都可能对不上。
应该是三层:
- Knowledge Compiler:负责把原始数据持续编译成 AI Ready Data。
- Knowledge Runtime:负责存储、检索、组合知识。
- Agent Harness:负责使用知识完成具体任务。
原始数据流
   │
   ▼
Knowledge Compiler   持续编译,可独立换模型
   │
   │  数据契约:AI Ready Data
   ▼
Knowledge Runtime    存储 / 检索 / 组合,可独立换存储和检索引擎
   │
   │  数据契约:按权限裁好的上下文
   ▼
Agent Harness        用知识完成任务,可独立换 Agent 框架
# generated by hugo AI
三者相互独立,但通过标准化的数据契约连接。这样既可以独立升级模型,也可以更换存储引擎、检索引擎和 Agent 框架。
这里的「数据契约」需要说具体一点,否则分层只是画在图上。我认为契约至少要约定四件事:
- Schema 和本体版本:Runtime 和 Agent 读到的每条知识,都声明自己遵循哪个版本的 Schema。编译器升级 Schema 时,下游不会悄悄读错字段。
- 出处和把握程度:每条事实都带
source和confidence,下游自己决定把握不够的事实能不能用来行动。 - 时间语义:知识只追加、带版本,不原地覆盖。截止日期从周三改到周五,Runtime 里两条记录都在,Agent 能回答「谁、什么时候改的」。
- 权限:谁能看到一条事实,在 Runtime 交出上下文之前就裁好,不留给 Agent 的模型去「注意别说出去」。
分层之后,三层的演进速度可以不一样。编译器随模型能力每几个月升级一次;Runtime 跟着数据量和查询模式换引擎;Agent Harness 跟着业务场景天天在变。没有这条契约,任何一层的变化都会牵动另外两层。
五、最强的反对意见:模型会不会把 Harness 吃掉?
我自己写过 模型正在吞噬 Agent 框架:今天要写插件做的事,明天可能就是模型的默认能力。按这个逻辑,模型强到一定程度,直接读原始数据就能给出可靠的知识,Harness 不就多余了?
我的回答是:模型会吞掉 Harness 里的「能力部件」,吞不掉「职责部件」。
被吞掉的是那些用代码弥补模型能力不足的部分:复杂的 Prompt 拼接、多轮抽取的编排、为了绕开上下文长度而做的切片。这些确实在快速变薄。
吞不掉的是另外几样:知识结构由谁定义(SPEC),事实以哪个系统为准(Validation),出了错怎么回放和回归(Evals),谁能看到什么(Runtime 的权限)。这些问题的答案不在模型里,在组织里。模型再强,也不知道你公司的审批状态应该以审批系统为准而不是以群消息为准,更不会自己替你留下一条回归用例。
还有一个反方是「上下文窗口越来越长,直接把原始数据塞进去就行」,我在 每天 1000 条钉钉消息,我让一个 Agent 先编译再开口 里回答过:长窗口不会让重复阅读变便宜,也解决不了多个 Agent 对同一件事理解一致的问题。这里不重复。
六、一个更深层的判断
我认为 AI 时代的软件工程正在出现一个新的抽象。
传统软件工程:
\[ Raw\ Data \rightarrow Code \rightarrow Application \]
AI Native 工程:
\[ Raw\ Data \rightarrow Knowledge\ Compilation \rightarrow AI\ Ready\ Data \rightarrow Agent \]
这里面有两个重要变化:
- 知识编译成为新的基础软件工程能力。 不只是把数据存起来,而是把数据转化成 AI 能够可靠使用的知识。在传统软件里,业务逻辑写在代码里;在 Agent 应用里,Agent 能做对多少事,很大程度上取决于它拿到的知识对不对。
- Harness 成为知识生产流水线的工程载体。 模型能力越来越强,但生产质量取决于 SPEC、Evals、Pipeline 和反馈闭环。
所以我的建议是,把它作为一个独立的工程方向来建设:
Knowledge Compiler Engineering(知识编译工程)
它可以同时服务于:
- 企业知识库;
- 个人上下文编译器;
- 组织本体与知识图谱;
- 数字员工的长期记忆;
- 企业 Agent 的上下文供给。
这五件事今天往往是五个团队、五套数据管道,各自理解一遍同样的原始数据。Muse 是个人上下文编译器,通讯录本体是组织本体的第一块,数字员工的记忆又是另一套,我的判断是,这几件事底下可以是同一条编译流水线,区别只在 SPEC 和下游消费者。
最终目标不是建设一个更大的知识库,而是 建设一个能够持续把企业原始信息流编译成 AI 可理解、可验证、可执行知识的系统。
你在做企业知识库或 Agent 上下文时,是让每个 Agent 自己去读原始数据,还是已经有了一层编译?欢迎留言聊聊。