前几天我手工做了一份研发效能排名,把一群工程师某两天的 PR 产出按质量和效率排了个序。做完之后,记住的是两件事。
第一件:评审记录里抓出一个极端案例——评审意见指出问题之后 54 秒,代码就合入了。这种事实只能靠把时间戳逐条比对出来。它躺在数据里,但没有任何模型会替你「读」出来。
第二件:这份排名差点在第一步就错了。GitHub 账号、IM 身份、群里的那个「人」,是三套账号体系。有个账号明明就是某位工程师,但证据只有群里几句「@某某 #PR 号」的交叉引用。如果我图省事直接猜合,就会把别人的产出算到他头上——这是这类系统能犯的最坏的错。
排名做出来之后我想明白了一件事:难点根本不在统计,在四件性质完全不同的事——认人、算数、取证、判断。而让 AI 做效能度量,成败取决于你有没有把这四件事分给不同的角色。
这篇把我此后一直遵守的通律写下来:AI 度量研发效能,精度分三层——事实高、判断中、因果低。 以及一个更反直觉的结论:排名只是副产品,真正的资产是它底下那层确定性事实——建好之后,一整张管理问题表都是近零边际成本白得的。
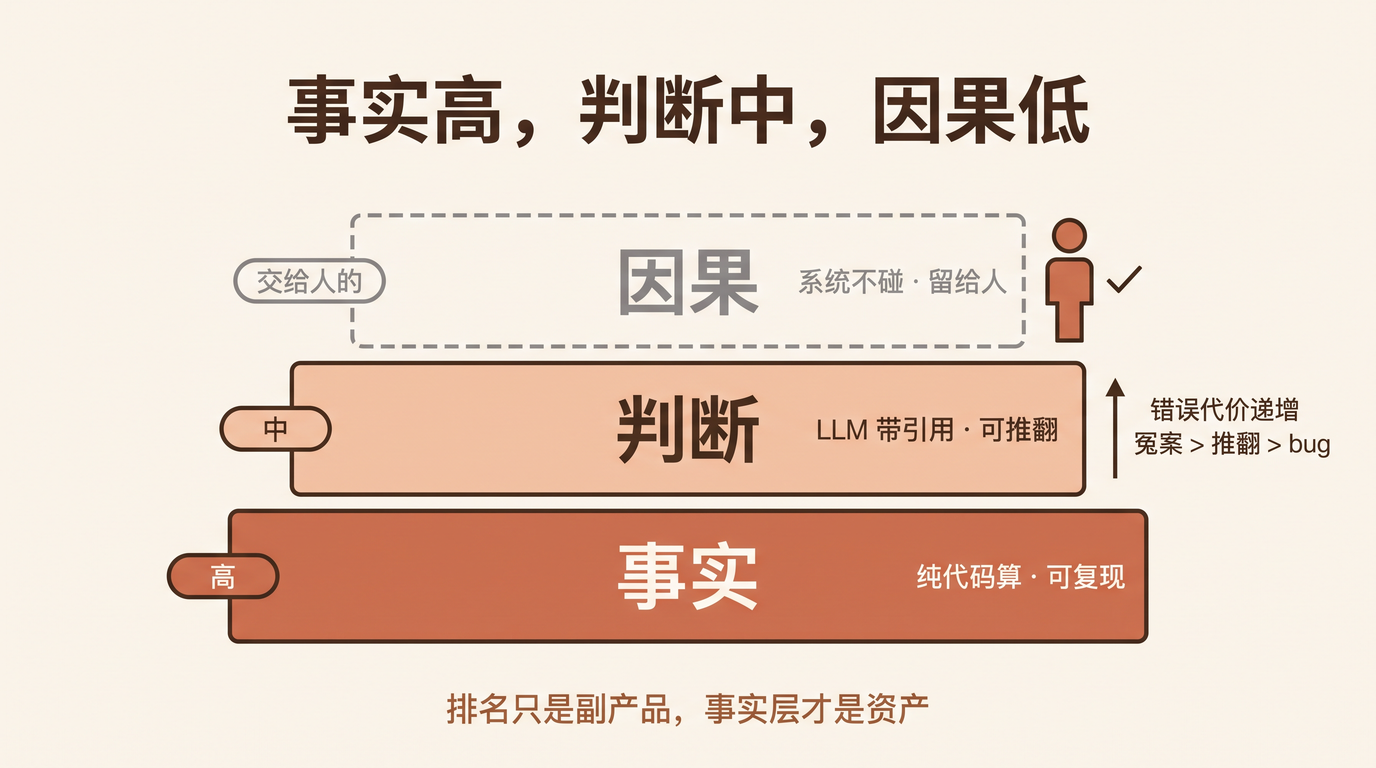
一、手工分析的四个难点,分属四层
复盘那次排名,每一步卡住我的东西都不一样:
- 认人。 GitHub login ↔ IM 身份 ↔ 编译系统里的 personId,三套体系的连接,全靠群消息里「@某人 #PR 号」这类证据交叉出来。有一条连错,整份排名作废。
- 算数。 合入数、周期、评审轮次、「意见提出后 54 秒合入」——这些是确定性事实,必须代码算。让模型从原文里「读数字」,读十次可能有三个版本。
- 取证。 评审正文里的严重级别、验证方法(真实数据 A/B 还是只跑了估算)、纪律事件——需要 LLM 摘要,但每一条必须能引回具体的 review ID 或消息 ID。
- 判断。 排名口径本身:质量还是效率、复杂度要不要修正、单日切片有多大局限——这是 查询时的推理,依赖问题本身,不该被编译成死事实。
四件事的精度要求完全不同。把它们混在一次模型调用里,就是灾难的开始:数字会漂、人会认错、结论不可复现,也没法过 eval。
二、精度通律:事实高、判断中、因果低
把四个难点归位,就是这条通律:
| 层 | 谁来做 | 例子 | 边界 |
|---|---|---|---|
| 事实 | 纯代码,零 LLM | 合入数、周期、评审轮次、54 秒 | 可审计、可复现;同样输入必得同样输出 |
| 判断 | LLM,逐条带引用 | 这算不算延期、严重级别、质量摘要 | 每条断言可回溯到消息 / 评审原文;人可推翻 |
| 因果 | 人 | 为什么慢、谁的错、是不是倦怠 | 系统只呈现事实链,不做自动结论 |
所有「高精度」的行都是纯代码产物。凡涉及诊断人的任务——倦怠、归责、动机——系统刻意停在「报事实 + 带引用的判断」,绝不往前迈那一步。
这既是能力边界,也是管理伦理边界。事实层错了是 bug,判断层错了可以推翻,因果层错了是冤案。 三层的错误代价完全不同,所以三层的实现方式必须不同。
这和 再谈 AI Native 工程:10 倍不是效率,是范式 里那条线是同一个判断:代码便宜之后,稀缺的是判断。度量系统的全部工程价值,就是把「能算的」从「要判断的」里剥出来,让人的判断只花在刀刃上。
三、副产品效应:先建事实层,买下一整张表
现在说那个反直觉的结论。
那次排名做完,真正让我兴奋的不是排名本身,而是复盘时发现的一件事:评审瓶颈、流程纪律审计、CI 归因、负载异常这些高价值问题,和排名共用同一条 PR 事件流。 确定性指标编译器一旦建好,它们几乎是白得的:
| 任务 | 典型问题 | 成本 | 精度 |
|---|---|---|---|
| 评审瓶颈 | 评审队列卡在谁身上?首评等多久? | 纯代码(时间戳序列) | 高 |
| 流程纪律审计 | 谁没等 approve 就合了? | 纯代码(merge 与 review 时序比对) | 高(54 秒就是这条抓的) |
| CI 健康与归因 | CI 红多久了?环境还是代码问题? | 代码 + 评审证据 | 红时长高;归因中(默认未归因) |
| 负载异常 | 谁持续深夜 / 周末提交? | 纯代码(时间分布) | 活动事实高;「倦怠」推断低——只报事实不诊断 |
| 返工率与复发 | 谁评审轮次多?同类问题反复犯? | 轮次代码算;复发需 LLM 比对 | 轮次高;复发判断中(须带引用) |
| 协作网络 / bus factor | 哪个模块只有一个人能评审? | 共现统计 | 网络结构高;「单点」判断中 |
注意成本列:一排「纯代码」。这些任务不需要新的数据采集、不需要新的模型调用,需要的只是同一份编译产物上多写几个查询。
先建确定性事实层,不是为了一个排名,是为了买下一整张表。 排名是这张表上最贵、最敏感、也最不该自动化的一行;而其他行,大多是安静、确定、每天都值钱的。
四、正确分工:编译、检索、判断各归各位
分工定理一句话:
编译层负责确定性事实和带引用的证据;检索层负责存储与目录级召回;判断层按版本化的方法论做查询时推理。
最诱人也最错误的做法,是把原始数据一股脑丢进检索层,让 agent 自己悟。我反对的理由有三条,每条都付过学费:
第一,成本。 让模型带着工具自己翻原始素材,同一份上下文会被反复重发。我在 每天 1000 条钉钉消息,我让一个 Agent 先编译再开口 里记过实测:改成「代码先采齐、模型只调一次」之后,单次消耗从约 83 万 token 降到约 6 万。上下文窗口再大,重复读同一份素材也不会免费。
第二,长窗口修不了输入层的错。 认人错在「这条记录署名是谁」这一层——输入就是错的,模型再强也只能把错认得更自信。
第三,不可审计。 「模型说的」和「代码算的、能引回原文的」,在管理场景里是两种完全不同的证据。前者错一次,信任清零;后者错了,能定位、能修、能回放。
这个分工和 知识编译最佳工程实践 里「Compiler 与 Serving 必须分离」是同一个架构判断在度量场景的落点:编译的归编译(确定性、可回放),服务的归服务(读优化、省 token),谁也不做谁的事。
五、三条红线
红线一:认人 fail-closed,错合比漏合危害大。
每条身份连接必须带证据和置信度;自动候选(群里「@名字 #PR 号」× PR 作者、commit 邮箱 × 通讯录邮箱的内部比对)只产生候选,生效要过人确认。连不上的账号单独报「未映射」,绝不猜合,绝不让 LLM 在查询时临时认人。把别人的产出算到某人头上,是这套系统能犯的最坏的错——连接准确率本身要进 eval。
fail-closed 落到代码上就是这么一小段,宁可难看,不可聪明:
from dataclasses import dataclass

@dataclass(frozen=True)
class IdentityLink:
    """GitHub login ↔ personId 的一条连接:没有证据就不许入库。"""

    github_login: str
    person_id: str | None        # None = 未映射;宁缺毋滥
    evidence: tuple[str, ...]    # 每条都引回原话:chat:cid/messageId 或内部邮箱比对记录
    confidence: float            # 由代码规则算出,不由模型「感觉」
    confirmed_by_human: bool = False

def resolve(login: str, links: dict[str, IdentityLink]) -> str:
    """查询时只走这一个入口:未经人工确认,一律按未映射处理。"""
    link = links.get(login)
    if link is None or not link.confirmed_by_human or link.person_id is None:
        return "UNMAPPED"        # 单独上报,绝不猜合
    return link.person_id
# generated by hugo AI
注意 resolve() 里没有 else 分支去「尽量猜一个」——未映射就是未映射,它会出现在报告的「未映射账号」一节里等人认领。系统的诚实不是靠模型保证的,是靠没有那条捷径保证的。
红线二:因果不自动化,测量不自动变成绩效。
最强的反方不是技术性的,是价值性的:效能度量本身就是毒果。 排名一旦存在,就会被 Goodhart——工程师优化排名而不是优化产品;深夜提交被当成敬业信号;系统变成监控,团队信任崩塌。这个反驳我认为是对的,所以它必须被设计吸收,而不是被公关话术化解:
- 因果层永远不自动:系统可以报「某人连续三周深夜提交」(事实),不报「他倦怠了」(因果);
- 排名是查询时推理,不是常设报表:不自动广播到群,只回应管理者的显式提问,且必须附带局限声明(单日切片、未评审 PR 不判质量、双重角色注明);
- 人事敏感数据 ACL 隔离,查询留审计日志。
红线三:评分标准归人写,且版本化。
排名的 rubric 就是这套系统的评分标准。自我改进的 Agent,会先学会怎么拿到评分标准 里的教训在这里同样成立:一旦系统(或系统背后的人)能悄悄改评分标准,所有历史排名都失去可比性。所以 rubric 必须带版本号、配 golden evals、改口径要过门禁——前后两份排名可比,靠的不是算法稳定,是标准变更有纪律。
六、带走三个问题
如果你的组织正准备让 AI 做度量、报表或「效能洞察」,动手前先回答三个问题:
- 每个输出属于哪一层? 事实、判断、因果——混层的输出就是混层的责任。
- 数字谁算? 答案必须是「代码」,且同样输入必得同样输出。模型复述的数字不是数字,是概率。
- 系统在哪里停? 度量系统最该写进设计文档的不是它能答什么,是它 拒答什么。「为什么慢」「谁的错」这类问题,它应该呈现事实链然后把判断交还给人——这不是能力不足,是产品设计。
那份手工排名现在正在被系统化成常设管线,54 秒那个案例被写进了 golden case:每次改编译规则,都要能把它重新抓出来。
你的组织里,AI 度量系统敢不敢把「不回答什么」写进设计文档?欢迎留言聊聊。