写给偏传统团队的项目管理者:没有 Jira、没有 Notion,或者买了但没人更新的那种。
一、思考:为什么是「钉钉群 + AI 底层」
1.1 传统团队的真实项目管理系统,是群聊
偏传统团队的项目管理现状:没有 Jira、没有 Notion,或者买了但没人更新。真正承载项目的是钉钉群——重大讨论在群里、每日例会在群里、日报周报在群里、风险同步在群里、甚至口头承诺和拍板决策也在群里。
群聊是事实上的「影子项目管理系统」:信息全在里面,但是非结构化、易逝、依赖人脑记忆。产品机会不是再造一个系统让团队搬家,而是把这个影子系统编译成正式系统。
这正是 从程序编译器到企业上下文编译器 那条判断在一个具体场景里的落地:记录不等于理解,消息不等于组织状态——但消息可以被编译成组织状态。
1.2 传统项目的三大损耗
| 损耗 | 表现 | 代价 |
|---|---|---|
| 记忆损耗 | 「上周拍板的事谁还记得?」「那个风险谁在跟?」 | 决策重复讨论、承诺无人认领、风险靠人记忆 |
| 编译损耗 | PM 每天手工翻群拼日报、周会前突击汇总 | PM 80% 时间花在信息搬运,不是判断 |
| 响应损耗 | 延期 3–5 天才被想起来上报 | 风险发现永远滞后于风险发生 |
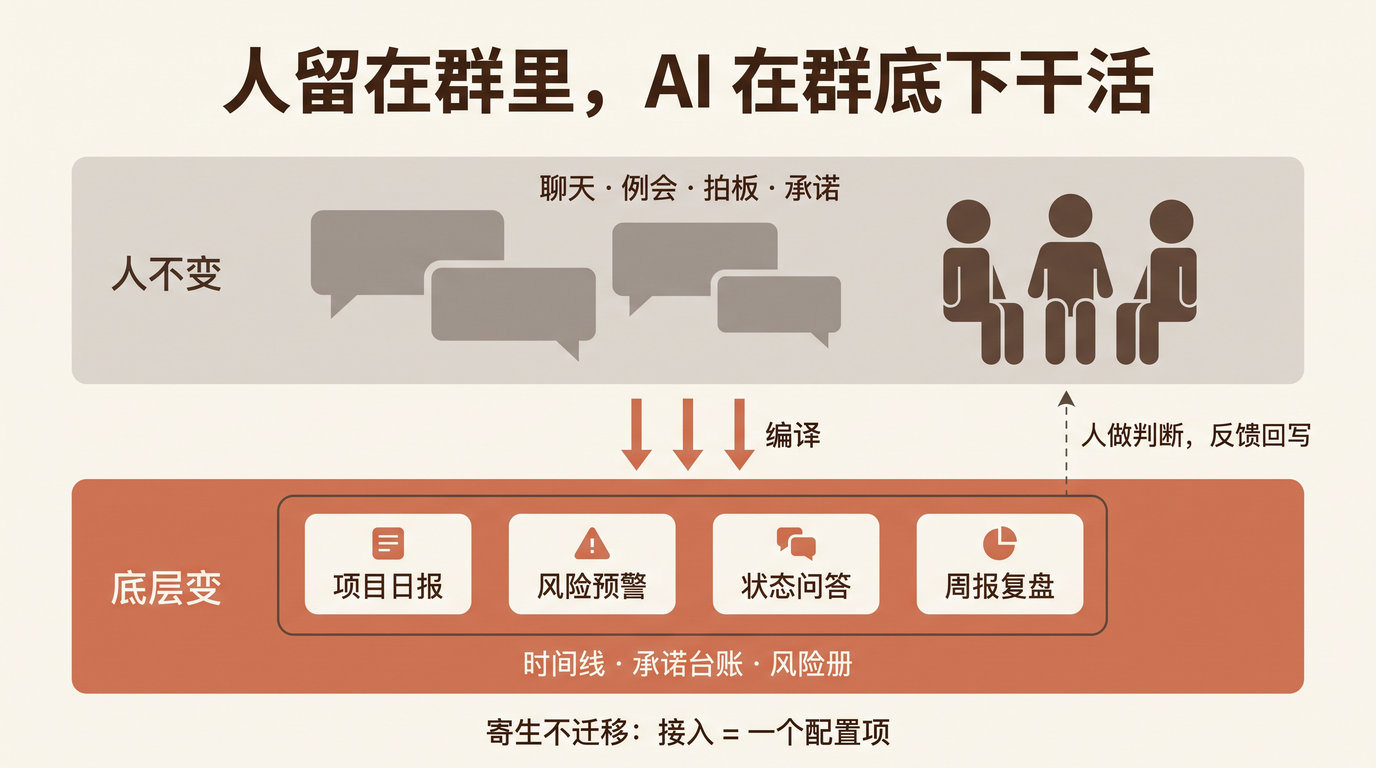
1.3 AI 原生工作流的定义:人不变,底层变
AI 原生 ≠ 让人学会用 AI 工具。
对传统团队,「原生」指的是工作流的产物机器可读、步骤 agent 可执行、闭环可自我迭代——而人留在自己的原生环境(群)里,习惯一点不改。
传统工作流:
人聊天 → 人记忆 → 人手工编译 → 人写日报 → 人追风险 → 人回答「那事怎么样了」

AI 原生工作流:
人聊天(不变)→ AI 编译(时间线/承诺台账/风险册)→ AI 召回(日报/预警/问答)
             → 人做判断(高质量输入 + 决策)→ 反馈回写,闭环迭代
# generated by hugo AI
我们的共识是:预配置数字员工可承接 80% 日常项目管理工作,人只负责提供高质量输入和线索。但有一个前提——agent 弥补不了人的不齐:团队没有 spec/规范共识,agent 也跑不顺。所以规范先行,不是工具先行。
1.4 为什么不做新工具:AI-not-native 才是长尾
这里有一个关键判断:AI-native 团队不需要这套东西——他们已经有高效工作流。真正的市场是钉钉上海量的 AI-not-native 项目群:他们不会迁移到新工具,但可以在熟悉的环境里获得同等效率。
所以产品策略是寄生,不是迁移:AI 层附着在现有群上,群同时扮演两个可组合的角色——
- 协作空间:群 + 数字员工,人在群里直接使唤它
- 数据源:群作为上下文容器,链接到 EC / Agent / 其他平台
钉钉这样的协作平台都应提供这种可组合选择,而不是强制单一工作流。
二、产品化方案:群 PMO 助手(预配置数字员工)
2.1 产品形态与最小接入
一个预配置好的数字员工进项目群。它知道怎么用工具、怎么读群消息、怎么按 PMO 规范干活。
接入成本 = 一个配置项:群设置里加一个 token / 启用一个插件,完事。不要求预先配置 GitHub、不要求导入仓库、不要求改变任何现有习惯。(这是踩过坑换来的判断:刚性预配置往往失败——「提前配好 GitHub / 项目管理系统」这类接入,因为变化快、团队没对齐,大概率烂尾。)
这就是 别配置 Agent 了,给它一个岗位 的产品化形态:不是让用户配置一堆 connector,而是让一个带着岗位职责说明书的数字员工直接入职。
2.2 架构:复用已验证的引擎
不新建系统。组织效能分析已经验证了「采集 → 编译 → 召回 → 输出」全链路,PMO 场景是同一引擎换一套 Spec:
群消息 ──► 采集(ingest,已有,不建第二套)──────┐
群内文档/链接 ──► 选择性索引(给链接,不搬家)────┤
会议听记 ──► 听记采集(已有)──────────────────┼─► 编译层
可选:GitHub/任务系统 ──► 链接 + 增量事件 ───────┘
                                    │
                                    ▼
              ① 项目时间线(重大事件按时间切片)
              ② 承诺台账(谁答应什么、何时交付、完成没有)
              ③ 风险册(延期 >3–5 天、阻塞、无人认领)
              ④ 人物地图(谁负责什么、谁卡谁)
                                    │
                                    ▼
              召回层(OpenViking 目录级检索,L0/L1/L2 分层省 token)
                                    │
                                    ▼
              输出四件套:日报 / 风险预警 / 问答 / 周报
# generated by hugo AI
这套分层和 每天 1000 条钉钉消息,我让一个 Agent 先编译再开口 里的四层编译栈是同一个纪律:原始快照只读、事实由代码编译、模型的推测要过确认才能变成台账。个人助理是这套栈的最小实例,群 PMO 是把同一套栈架到项目群上。
2.3 PMO Spec 先行
先写清 PMO 职责 Spec,再让 AI 基于 Spec + 群上下文出实现方案(用 Claude/OpenAI 生成,而不是堆 connector)。
Spec 回答三个问题:
- PM 的日常职责有哪些?(追进度、拼日报、记风险、答状态、组织会议……)
- 哪些可以被编译自动化?(日报、状态问答、延期预警 = 高确定性;跨团队协调、谈判 = 留给人)
- 每个输出的精度契约是什么?(见 2.6)
Spec 是编译器的合同,也是验收标准——和研发侧「Issue → SPEC/EVAL 驱动」同一套纪律。
2.4 数据策略:链接 + 选择性索引(两个血泪教训)
一正一反两个真实案例,定了数据策略:
| 案例 | 结果 |
|---|---|
| ✅ Claude Blog 300+ 篇文章选择性导入知识库 | 5–10 分钟建成,立刻能答具体问题 |
| ❌ 内部尝试 raw 网页直送文档服务、服务端解析 | 8 万+ token,一篇没导进去(服务端转换失败) |
由此固化三条规则:
- 不全量导入:有的仓库 1TB,编译慢、token 贵、产出不抵成本。给链接 + 选择性索引,一部分 agent 在线查,一部分 join 进上下文
- 本地转 Markdown 再入库:不把 raw 内容丢给服务端解析;工具要区分布量/单篇/大文件场景
- 建「建筑师蓝图」中间层:PM 负责梳理项目背景、分工、需求到上线的流程,agent 顺着蓝图找线索,而不是盲扫全部文档
2.5 输出四件套
| 输出 | 触发 | 内容 | 精度要求 |
|---|---|---|---|
| 项目日报 | 每日定时 | 时间线切片:今天谁推进了什么、拍板了什么、新增什么承诺 | 事实高(逐条带消息引用) |
| 风险预警 | 主动推送 | 延期 >3–5 天、承诺无人认领、阻塞超阈值 | 宁可不报,不可错报(误报一次,信任清零) |
| 状态问答 | PM 随问 | 「X 怎么样了」「谁在卡 Y」「上周拍板的事落地了吗」 | 带引用 + 数据截至时刻 |
| 周报/复盘 | 每周 | 承诺兑现率、风险趋势、下周关注 | 数字代码算,判断带引用 |
2.6 精度与信任契约(传统团队的唯一门槛是信任)
从 AI 能排什么,不能排什么 继承的通律:事实高、判断中、因果低。
- 事实(谁说了什么、承诺何时到期、PR 合没合):代码编译,可审计,必须带引用(messageId / 文档 / PR)
- 判断(这算不算延期、风险等级):LLM 按 Spec 判断,带引用,PM 可推翻
- 因果(为什么慢、谁的错):不做自动结论,只呈现事实链,判断留给人
- 认人 fail-closed:负责人识别宁可分开不乱合,关键映射由 PM 确认一次——把风险算错人是这类产品最坏的失败
- 新鲜度强制声明:每个回答带「数据截至 X 时刻」,旧数据不冒充实时
2.7 隐私与治理
- 群数据编译产物留在群 scope:群成员可见群日报;跨群汇总、个人效能类敏感输出仅 PM/主管可见(ACL 隔离)
- 效能排名不自动广播到群,只给管理者,显式指令才转发
- 查询留审计日志;保留期可配置;身份/归属错误有纠正通道
三、举一反三:低门槛最佳实践(面向传统团队)
从 PMO 案例推广到任何「传统团队 + AI 协作」场景的 12 条实践,按接入 / 数据 / 信任 / 迭代分组。每条都配一个真实反例——反例比利好更能说服传统团队。
接入篇:把门槛压到一个动作
| # | 实践 | 一句话原则 | 具体动作 | 反例教训 |
|---|---|---|---|---|
| 1 | 寄生不迁移 | AI 附着在现有群上,不要求换工具 | 数字员工进现有项目群,人习惯零改变 | 强推 Jira/Notion 迁移:买了没人更新,群才是真系统 |
| 2 | 一个配置项 | 接入 = 群设置加一个 token/插件 | 预配置数字员工模板,开箱即用 | 要求预配 GitHub/项目管理系统:变化快、团队没对齐,刚性预配置必失败 |
| 3 | 渐进披露 | 先解决一个高频痛点,信任后再扩 | 第一周只开日报;跑顺了再开预警、问答 | 大爆炸式全流程上线:团队没对齐,agent 弥补不了人的不齐 |
数据篇:把成本压到链接级
| # | 实践 | 一句话原则 | 具体动作 | 反例教训 |
|---|---|---|---|---|
| 4 | 给链接不搬家 | 链接是上下文转移的最小原子 | 群内文档/仓库给链接 + 选择性索引,agent 按需在线查 | 全量导入 1TB 仓库:编译慢、token 贵、产出不抵成本 |
| 5 | 本地转换再入库 | 不把 raw 内容丢给服务端解析 | 本地转 Markdown,区分布量/单篇/大文件 | raw 网页直送文档服务:8 万 token 一篇没导进去 |
| 6 | 蓝图中间层 | PM 梳理结构,agent 顺藤摸瓜 | 项目背景/分工/流程一页纸,agent 先读蓝图再找线索 | 盲扫全部文档:给 agent 10 分钟自己探索过滤,比全量处理快且准 |
信任篇:把精度变成契约
| # | 实践 | 一句话原则 | 具体动作 | 反例教训 |
|---|---|---|---|---|
| 7 | 事实代码算,判断带引用,因果留给人 | 三层精度分离 | 数字纯代码编译;LLM 判断逐条引用;不自动诊断人 | 让模型从原文「读」数字:数字会漂、排名不可复现 |
| 8 | 每个回答带引用 + 新鲜度 | 可追溯是传统团队的信任基础 | 引用到 messageId/文档/PR;声明数据截至时刻 | 无引用的「AI 说」:错一次就再没人信 |
| 9 | 预警宁缺毋滥 | 误报一次,信任清零 | 风险预警 fail-closed,阈值保守,PM 可推翻 | 狼来了式预警:真风险来了反而被忽略 |
| 10 | 认人宁可分开不乱合 | 归属错误是最坏失败 | 关键映射 PM 确认一次,未确认标「待认」 | 名字相同就合并:把别人的活/风险算到错误的人头上 |
迭代篇:让路线图从使用里长出来
| # | 实践 | 一句话原则 | 具体动作 | 反例教训 |
|---|---|---|---|---|
| 11 | case 驱动验证 | 具体案例 > 抽象文章 | 每个能力配 golden case(编译产物存哪、对后续任务什么价值) | 拿抽象方案汇报:「我想看两样东西:具体 case,和编译过程怎么开发的」 |
| 12 | 可答问题清单即路线图 | usage 驱动数据扩张 | 记录哪些问题答准了、哪些缺数据;缺什么补什么 | 预先规划全部数据接入:变化快,规划赶不上实际 |
传统团队一周冷启动清单
- Day 1:选一个真实项目群;PM 写一页纸 PMO Spec(职责 + 哪些自动化 + 精度契约)
- Day 2:群设置加一个配置项,数字员工进群;导入项目蓝图一页纸(本地 Markdown)
- Day 3–5:只开日报,每天 PM 核对引用、纠正认人(确认一次,永久生效)
- Day 5:用 3 个真实问题做 golden case 验收(「X 怎么样了」「谁卡 Y」「上周拍板落地没」)
- Week 2:日报信任建立后,再开风险预警(保守阈值);开始记「可答问题清单」
四、落地路径与验收
| 阶段 | 交付 | 验收标准 |
|---|---|---|
| MVP(1 周) | 1 个真实群 + PMO Spec + 时间线编译 + 日报 | 日报事实逐条带引用,PM 核对零错归;golden case 3 问全准 |
| P1(2–3 周) | 承诺台账 + 风险预警 + 认人确认流 | 延期 >3–5 天主动报出;预警误报率 ≈ 0;承诺归属 PM 确认 |
| P2(1–2 月) | 状态问答 + 选择性链接(文档/听记/GitHub)+ 周报 | 可答问题清单持续扩张;问答带引用 + 新鲜度;token 成本可控(L0/L1 先行) |
| 规模化 | 群配置模板化,一个配置项复制到其他群 | 新群冷启动 ≤ 1 天;跨群汇总 ACL 隔离 |
北极星指标:PM 信息搬运时间下降(目标 80% 日常承接);护栏指标:预警误报率、引用可追溯率、认人错误数(目标 0)。
五、边界与风险(不做什么)
- 不做因果评判:不自动回答「谁拖了后腿」「为什么慢」——呈现事实链,判断留给人。这既是能力边界,也是管理伦理边界
- 不做全量数据湖:链接 + 选择性索引是纪律,不是妥协;成本失控的导入一律拒绝
- 不替代人的对齐:团队没有 spec/规范共识时,先帮他们写 spec,而不是硬上 agent
- 不广播敏感输出:个人效能、跨群汇总只给管理者;群内只有群 scope 产物
- 不忽视群噪声:「有名字」不等于「在叫他」(测试群刷小说正文恰好含同事花名的真实坑)——@ 或对方在群说过话才算点名
结语
这套方案的本质是一句话:人留在群里,AI 在群底下把影子系统编译成正式系统。
传统团队不需要学会 AI,他们需要的是:一个配置项的接入、一份带引用的日报、一个不误报的预警、和一条从「能答准的问题」长出来的路线图。信任建立之后,80% 的日常项目管理自然移交——这就是面向长尾团队的 AI 原生工作流。