我先讲一个自己跑了一段时间的实验:让一个 Agent 每天读我的一千多条钉钉消息,先编译、再开口——我拍过什么板、许过什么诺、哪些事还没落地、哪些风险没人提醒我(详见每天 1000 条钉钉消息,我让一个 Agent 先编译再开口)。
这个实验让我确认了一件更朴素的事:这些真正推动我工作的东西,一直躺在聊天记录里,从来没有被任何正式系统替我记住过。
我个人的困境,放大几个数量级,就是企业的困境。
一、企业真正的工作系统,藏在影子里
每个企业都有一套正式的工作系统。
项目管理软件里有任务,CRM 里有客户,ERP 里有订单,OA 里有审批。它们共同构成了企业的信息化基础设施。
但如果仔细观察真实的工作过程,会发现一个有趣的现象:
真正推动企业运转的,往往不是这些正式系统,而是那些没有被正式记录下来的协作信息。
一个项目什么时候真正启动?可能是项目群里的一句「我们今天开始」。
一个任务什么时候被承诺?可能是某个人在群里回复「这个我来跟进」。
一个项目什么时候出现风险?可能是连续三天没人回复,或者负责人在会议中说了一句「这个事情可能要延期」。
一个决策什么时候发生?可能是老板在群里说了一句「就按这个方案执行」。
这些信息散落在群聊、单聊、会议、文档、邮件和各种业务系统中。
它们没有统一的数据结构,没有标准的状态机,也没有完整的生命周期管理。
但它们真实地决定着企业每天如何运转。
我们可以把这套系统称为企业的 影子工作系统(Shadow Work System)。
它不是一个软件,而是由人的沟通、承诺、决策、协作和执行共同构成的动态系统。
群聊就是其中最典型的载体。
二、传统企业软件的问题:要求人适应系统
过去二十年,企业数字化的基本思路是:
先定义业务流程,再设计软件系统,最后要求员工按照系统规定的方式工作。
这套方法非常有效,但也有明显的局限。
项目管理软件要求人主动创建任务、更新进度、维护状态;CRM 要求销售人员及时录入客户跟进记录;知识管理系统要求员工主动整理和沉淀知识。
这些工作本身并不创造业务价值,却成为使用系统的必要成本。
于是出现了一个普遍现象:
正式系统记录的是应该发生的事情,影子系统承载的才是真正发生的事情。
企业买了很多软件,却依然需要大量的人来追进度、催反馈、整理会议纪要、维护项目台账。
问题不是企业缺少软件,而是软件没有真正理解人的工作。
AI 带来了一个新的机会:
不再要求人把工作搬进系统,而是让 AI 进入人的工作现场,理解正在发生的事情,并自动构建工作系统。
这是一种根本性的范式变化。
三、Context Compiler:把信息流编译成企业上下文
如果把企业每天产生的信息看成一种高级编程语言,那么群聊、会议、文档和业务事件就是这门语言的原始代码。
AI 要做的,不是简单地把这些信息存进向量数据库,也不是给它们套一层 RAG。
真正重要的是知识编译——编译层的工程纪律,我在知识编译最佳工程实践里单独写过。
就像高级程序语言需要经过编译器,才能变成 CPU 可以执行的机器指令一样:
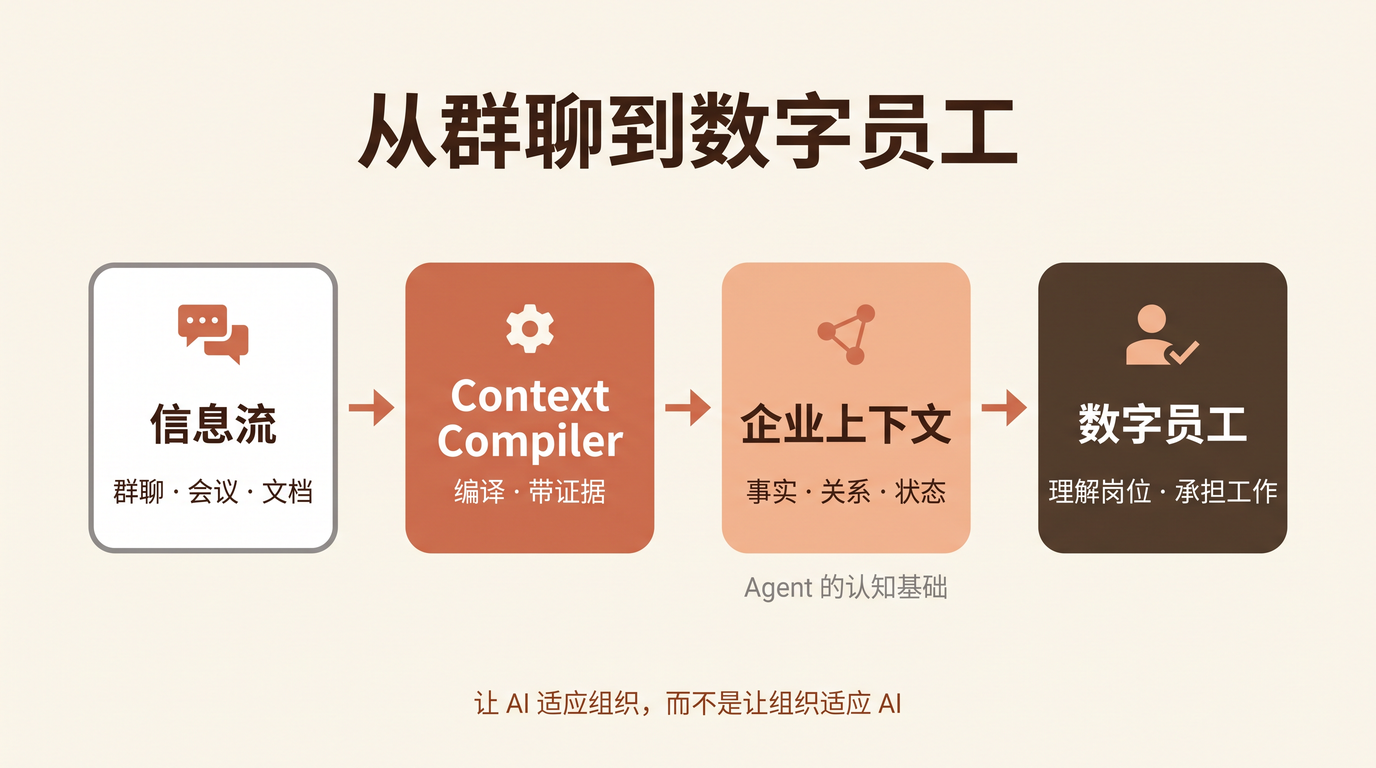
企业的信息流,也需要经过 Context Compiler,才能变成 Agent 可以理解和使用的企业上下文。
这个过程可以分成三个层次。
1. 信息层:采集真实发生的事情
从群聊、单聊、会议、文档、日历、邮件以及外部业务系统中,持续获取增量信息。
这一层解决的是数据覆盖问题。
2. 知识层:编译出结构化的工作事实
将非结构化信息编译成结构化知识:
- 人:谁参与了这件事,谁负责,谁协同。
- 事:发生了什么,承诺了什么,需要完成什么。
- 关系:事项属于哪个项目,关联哪个客户,依赖哪些任务。
- 状态:事情目前处于什么阶段,有没有变化。
- 时间:什么时候发生,什么时候承诺,什么时候截止。
- 证据:这些事实来自哪条消息、哪份文档、哪次会议。
这里尤其重要的是区分事实、推断和判断——这三层的精度契约,在 AI 能排什么,不能排什么里展开过:事实高、判断中、因果低。
事实必须能够回溯到原始证据;推断必须表达置信度;涉及责任归属和业务因果的判断,不能因为模型给出了一个答案,就自动变成事实。
知识编译的核心不是生成更多文字,而是建立可信的企业状态。
3. 上下文层:形成可持续演进的企业上下文
编译结果不应该只是一次性的摘要,而应该是一个持续更新的知识系统。
它能够回答:
- 现在有哪些重要项目?
- 每个项目的负责人是谁?
- 哪些事项已经承诺但尚未完成?
- 哪些任务存在延期风险?
- 哪些决策影响了当前的业务状态?
- 哪些人和项目之间存在依赖关系?
这就是企业上下文(Enterprise Context,EC)。
EC 不是一个简单的向量数据库,而是一个具有事实、关系、状态、证据、权限和时间维度的动态知识系统。
它是企业 Agent 的工作记忆和认知基础。
四、从一个 CC Agent,到企业的知识编译网络
一个值得探索的工程架构是:让不同的数据源和业务场景,都拥有自己的 Context Compiler Agent(CC Agent)。
例如:
- 钉钉群聊 CC:编译项目、承诺、任务和协作关系。
- 会议 CC:编译决策、行动项和责任人。
- 店铺视频 CC:编译商品、经营活动、客户反馈和业务事件。
- 外部协作平台 CC:编译外部协作信息和组织知识。
- CRM CC:编译客户状态、商机进展和销售活动。
每一个 CC Agent 都是一个长期运行的知识编译任务。
它不只是执行一次数据 ETL,而是持续观察数据变化,理解业务语义,维护知识状态,并通过评测和反馈不断改进编译质量。
「长期运行的编译任务」落到工程上,就是一份能进 CI 的合同——数据源、职责规格、golden case,缺一不可:
from dataclasses import dataclass

@dataclass(frozen=True)
class CCJob:
    """一个 CC Agent 的编译合同:长期运行的任务 = 数据源 + 职责规格 + 验收用例。

    合同写成代码而不是文档的原因:文档会腐烂,代码能进 CI。
    """

    source: str          # "dingtalk_group" / "meeting_minutes" / "crm" ...
    spec_path: str       # 职责规格:编译哪些事实、产物存哪、谁能读
    golden_cases: tuple[str, ...] = ()
    # 每条 case =「输入快照 -> 应编译出的事实」。
    # 改任何编译规则都必须重跑,防止修好一处弄坏三处。

def changed_since(old: dict, new: dict) -> list[str]:
    """增量编译入口:只处理变化的键,绝不全量重跑。"""
    return [k for k in new if old.get(k) != new[k]]
# generated by hugo AI
这段代码里没有宏大的抽象。一个 CC Agent 的工程本质就三个字段:source 决定数据边界,spec_path 决定编译职责(编译哪些事实、不碰哪些判断),golden_cases 决定质量不退化——它是上一节「评测和反馈不断改进编译质量」的具体形态。changed_since() 看起来朴素,却是编译成本可控的关键约束:TB 级的数据源上,全量重跑是不可想象的,这正是信息层「持续获取增量信息」的工程表达。
不同 CC Agent 的编译结果最终汇聚到企业上下文 EC。
这里有一个重要的架构原则:
数据源可以不同,编译任务可以不同,但企业上下文必须能够统一关联。
例如,钉钉项目群中的一项承诺,可能关联 CRM 中的一个客户商机,也可能关联会议纪要中的一项决策,还可能关联外部系统中的一张订单。
只有把这些信息关联起来,Agent 才真正拥有跨系统理解企业的能力。
五、从企业上下文到数字员工:让知识变成生产力
如果 Context Compiler 解决的是 Agent 如何理解企业,那么数字员工解决的就是 Agent 如何在企业里工作。
传统 AI 产品的交互模式是:
用户提出问题 → AI 检索信息 → AI 生成答案。
数字员工的工作模式应该是:
理解岗位职责 → 获取企业上下文 → 发现工作机会 → 制定行动计划 → 执行任务 → 获取反馈 → 更新工作状态。
两者有本质区别。
一个 PMO 数字员工,不应该只是回答「项目目前进展如何」。
它还应该能够:
- 自动从项目群中识别项目任务和承诺。
- 持续跟踪任务进度和负责人反馈。
- 识别延期风险和跨团队依赖。
- 在适当的时机主动提醒责任人。
- 收集执行结果并更新项目状态。
- 必要时向项目负责人升级风险。
它不再是一个提供信息的聊天机器人,而是一个承担岗位职责的数字员工。
这里也出现了一个重要的产品演进路径:
群聊助手 → 群 PMO → 项目数字员工。
第一阶段,AI 帮助人理解群聊。
第二阶段,AI 将群聊编译成项目管理系统——群聊就是影子项目管理系统写的就是这一阶段的产品化方案。
第三阶段,AI 基于项目上下文主动推动项目执行。
这才是从 Copilot 到 Agent 的真正进化。
六、群数字员工:AI Native 协作的新形态
如果我们接受上述判断,那么群聊本身就有机会成为数字员工最自然的工作入口。
过去,群聊是人与人协作的空间。
未来,群聊可以同时成为人与人、人与数字员工共同工作的空间。
但这并不意味着把一个普通聊天机器人拉进群里就够了。
群数字员工必须具备几个基本能力:
第一,明确的组织身份。
数字员工应该有自己的组织身份、岗位职责、汇报关系和工作范围,而不是简单借用某个员工的个人身份。
第二,明确的上下文边界。
群内数字员工只能使用组织允许公开的知识,以及该群被授权使用的共享上下文。不能因为某个员工邀请了自己的个人数字分身进群,就让个人隐私数据进入团队协作。
第三,明确的工作职责。
它需要有岗位 Spec,明确可以做什么、不可以做什么,哪些任务可以自主执行,哪些操作需要人工审批——这就是别配置 Agent 了,给它一个岗位里那套岗位纪律在群场景的落地。
第四,明确的评测和审计。
数字员工需要像真实员工一样接受上岗评测。它的任务完成质量、错误率、响应速度和执行过程都应该可以被评估和追溯。
当这些能力建立起来,群就不再只是一个信息交换场所,而是一个数字员工可以长期工作的组织空间。
七、AI 时代,企业软件的竞争从功能转向知识编译和执行
回头看企业软件的发展:
- 第一阶段,企业把线下流程搬到线上,形成业务系统。
- 第二阶段,企业把业务数据集中起来,形成数据平台。
- 第三阶段,企业把数据转化为知识,形成企业上下文。
- 第四阶段,企业让 Agent 基于上下文承担工作,形成数字员工体系。
这是一条从信息化到智能化的演进路径。
过去企业软件的核心竞争力是功能、流程和数据连接。
未来企业软件的核心竞争力将逐渐转向:
- 能否完整理解企业真实发生的事情。
- 能否把非结构化信息编译成可信的知识。
- 能否建立跨人、跨项目、跨系统的上下文关系。
- 能否在权限约束下让 Agent 安全地使用这些知识。
- 能否让数字员工真正完成工作,并通过反馈持续进化。
这也意味着企业软件的价值不再只是帮助员工更高效地使用软件,而是让企业拥有一支能够理解组织、承担职责、持续执行的数字员工队伍。
结语:让 AI 适应组织,而不是让组织适应 AI
群聊是一个很好的起点。
它承载着大量真实的工作信息,却长期没有被正式的软件系统完整理解。
今天,我们终于有机会让 AI 进入这些工作现场,把信息流编译成上下文,再把上下文转化为数字员工的工作能力。
信息流是企业的原始语言,Context Compiler 是企业的编译器,企业上下文是 Agent 的认知基础,数字员工是企业的执行主体。
从群聊到企业上下文,从企业上下文到数字员工,这不仅仅是一个产品功能的演进,而是企业软件从记录工作走向理解工作、再走向执行工作的范式变化。
未来,企业不一定需要员工每天打开更多的软件。
它需要的是一群真正理解企业、能够协同工作、可以持续交付结果的数字员工。