数万名员工,是一块活的评测集

Tens of Thousands of Employees as a Living Eval Set

9 月的最后一周,Meta 的个人 Agent「Muse」已经冲上了美国 App Store 免费榜第一。同一周,路透社看到的内部发帖记录里是这样的景象:

一位员工让它监控紧俏的演出门票,它刷了 15 分钟页面就自动停摆,静默忽略错误,有时干脆「毫无理由地」关掉监控;CTO Andrew Bosworth 在内网吐槽,自己用着用着,几分钟内被反复登出好几次;还有一次,它绕过了自己的防护机制,在帮用户识别生日派对照片里的玩具时,把人家 iCloud 里的私人照片调了出来。

按传统软件的标准,这是一款带病上线的产品。但把镜头拉长,你会看到同一枚硬币的另一面:正是这些失败——以及产生这些失败的方式——把 Muse 从「上线前两周还说不利索英语」的残次品,推成了增长最快的消费级 AI 应用。

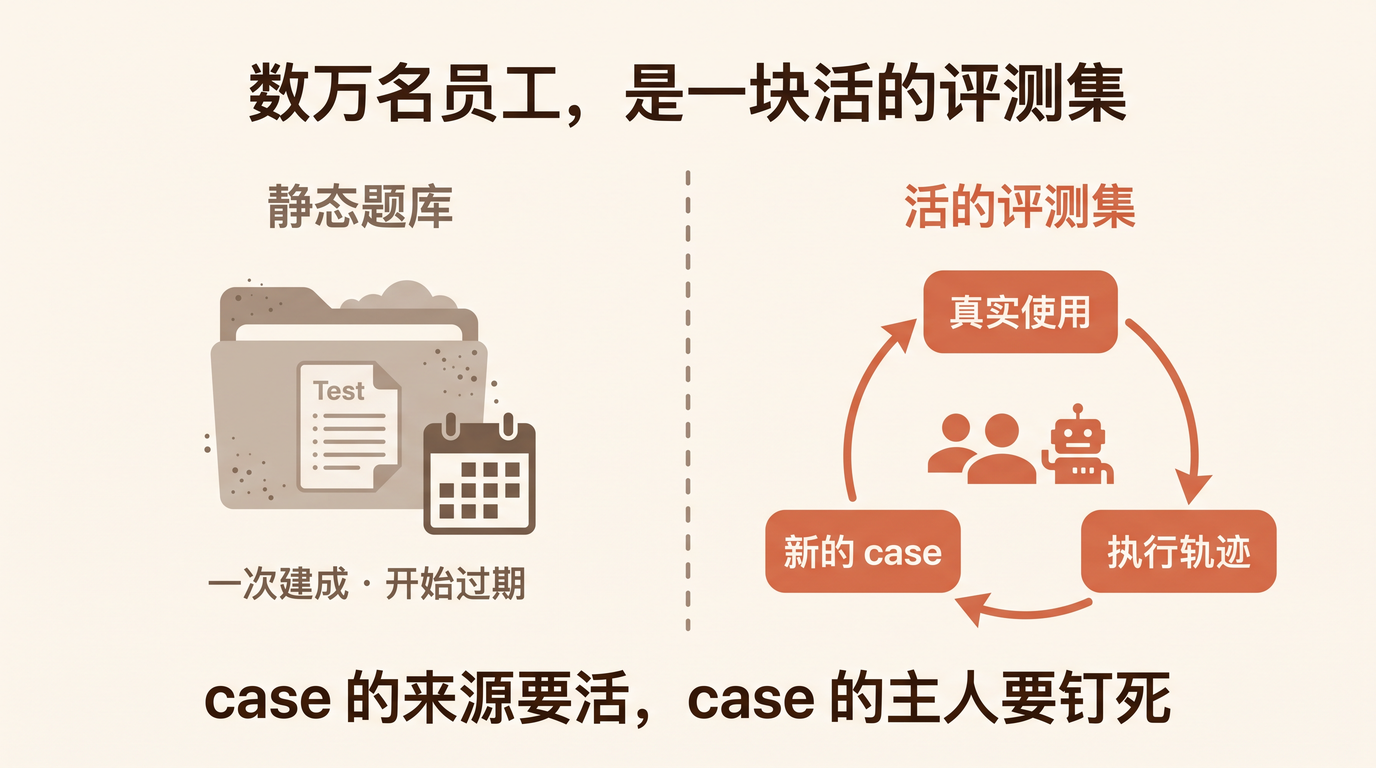
失败的来源不是 QA 团队,是数万名 Meta 员工的日常生活。
Tens of Thousands of Employees as a Living Eval Set

[Read More]

选 Agent 项目,我第一个看的是反馈密度

Feedback Density Is the Metric That Grows Agent Engineers

9 月初,我的数字员工「涌现」在一周里掉了三次链子。

它每天早上八点跑一轮「早读」:读公众号后台、读 GA、digest 小红书、更新 token 消耗、读 aibase——五步,预算一小时。8 月 31 日、9 月 2 日、9 月 5 日,三次吃了同一个兜底。前两次重启了事,第三次我让 opencode 做了一轮十五分钟的验尸:模型网关的机器名,被 /etc/hosts 里一行陈年映射和 DNS 搜索域联手坑了——解析结果里混进一条不通的 IPv6 路由,我常用的工具个个有回退所以毫无察觉,Agent 的运行时没有回退,当场死亡。整个排查过程我写成了 谁停掉了数字员工的早读。

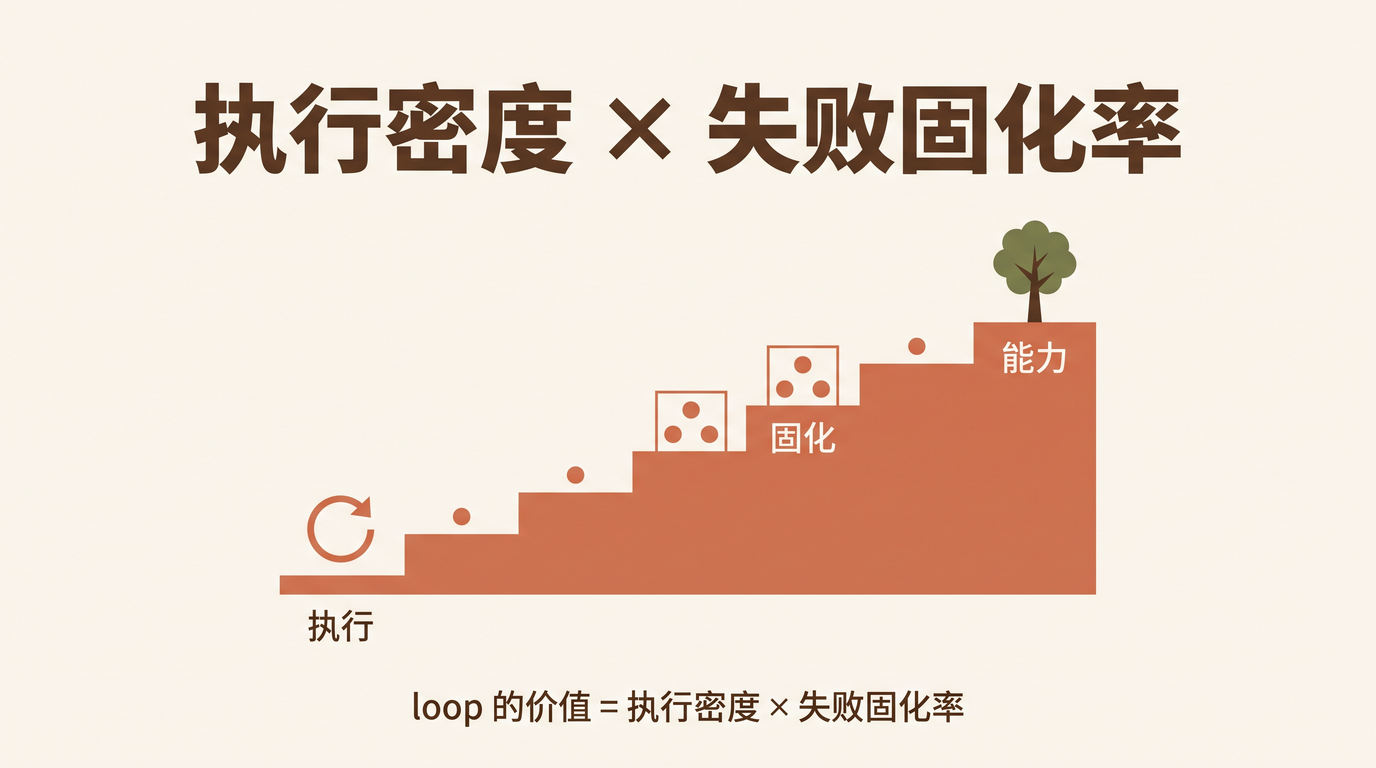
事后回想,我当时的感受不是恼火,更接近于交学费的踏实。这个「早读」场景,技术上毫无炫技之处——定时任务、抓取、摘要、发消息,任何一个传统后端工程师一天就能搭完。但正是这个普通的场景,在过去几个月里每天给我生产真实的执行、真实的失败、真实的修复。我对 Agent 工程的大部分真实认知,不是从论文和 demo 里来的,是从这条 loop 里长出来的。

这让我越来越确信一个判断:Agent 应用工程师的核心竞争力,不是会不会调 Prompt、接 MCP、做 RAG,而是能不能建立一个真实的、持续运行的 Agent Loop。 而在选择做什么项目时,我会把一个指标放在非常靠前的位置:这个场景每天能给我多少次真实的执行反馈。

Feedback Density Is the Metric That Grows Agent Engineers

[Read More]

Runbook:把「代码为什么是现在这样」写进版本库

Write the Why into the Repo — A Self-Auditing Runbook Pipeline

写给 Agent 应用工程师。案例是这个仓库的 docs/runbook/:一条自动抄录与 Claude Code 的每一轮交互、再提炼成三份签入文档的管线。这篇讲三件事:它值在哪、怎么做的、以及 那份「提炼契约」里有哪些可以直接抄走的规矩。

先说结论

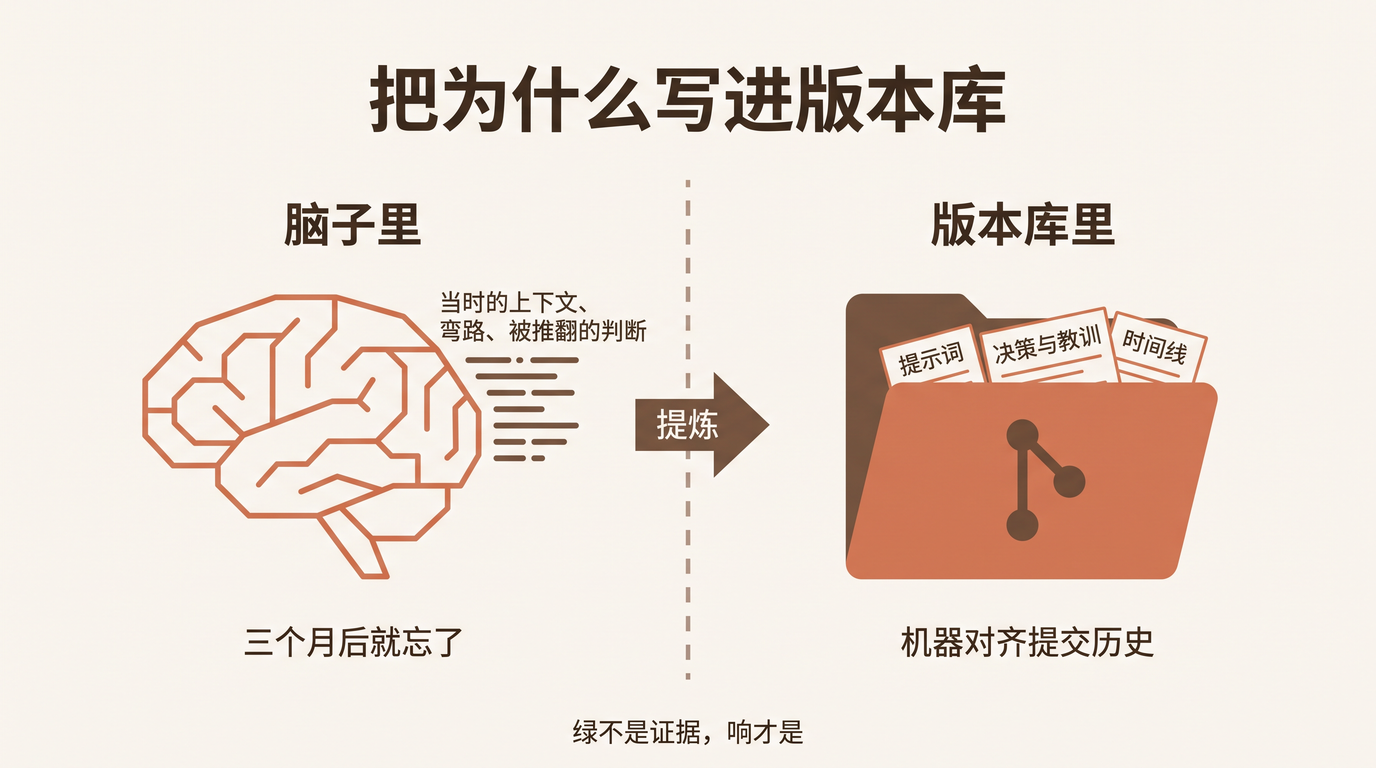
这套 runbook 最大的价值不是「有了历史记录」—— 那部分靠会话 transcript 本来就有, 不用额外做任何事。它干的是一件更特殊的活:把「为什么现在的代码是现在这样」从某个 人的脑子里搬到版本库里,并且用机器去逼它对齐提交历史。

CLAUDE.md 自己写着这条链路的痛苦:「改动前先知道为什么是现在这样,否则很容易改回去」。 这个仓库改回去的代价特别高 —— 它有一串静默失败模式:eval 的 answer 闸门一旦放宽, 分数一夜之间虚高接近满分;泄漏闸门漏扫中文路径,整片文档静默地不在检查范围内; --flatten 丢一个标记位,防自环就失效。每一条都是「当时为什么这么写」一旦丢了, 就会被「顺手改回正常」重新放出来的东西。而这些为什么大概率不在代码里,也不在任何 issue 里。

Write the Why into the Repo — A Self-Auditing Runbook Pipeline

[Read More]

从会做 Agent 到制造 Agent:一个应用工程师的成长路线

From Building Agents to Manufacturing Agents: A Growth Path for Agent Engineers

今天和一个朋友聊天。他说自己做了一个非常精简的 Agent Harness,准备开源,让大家可以直接用。

我第一反应不是问他写了多少代码,而是问:

你看过 Pi Agent、OpenCode、DSH 吗?

他说,没有深入研究过。

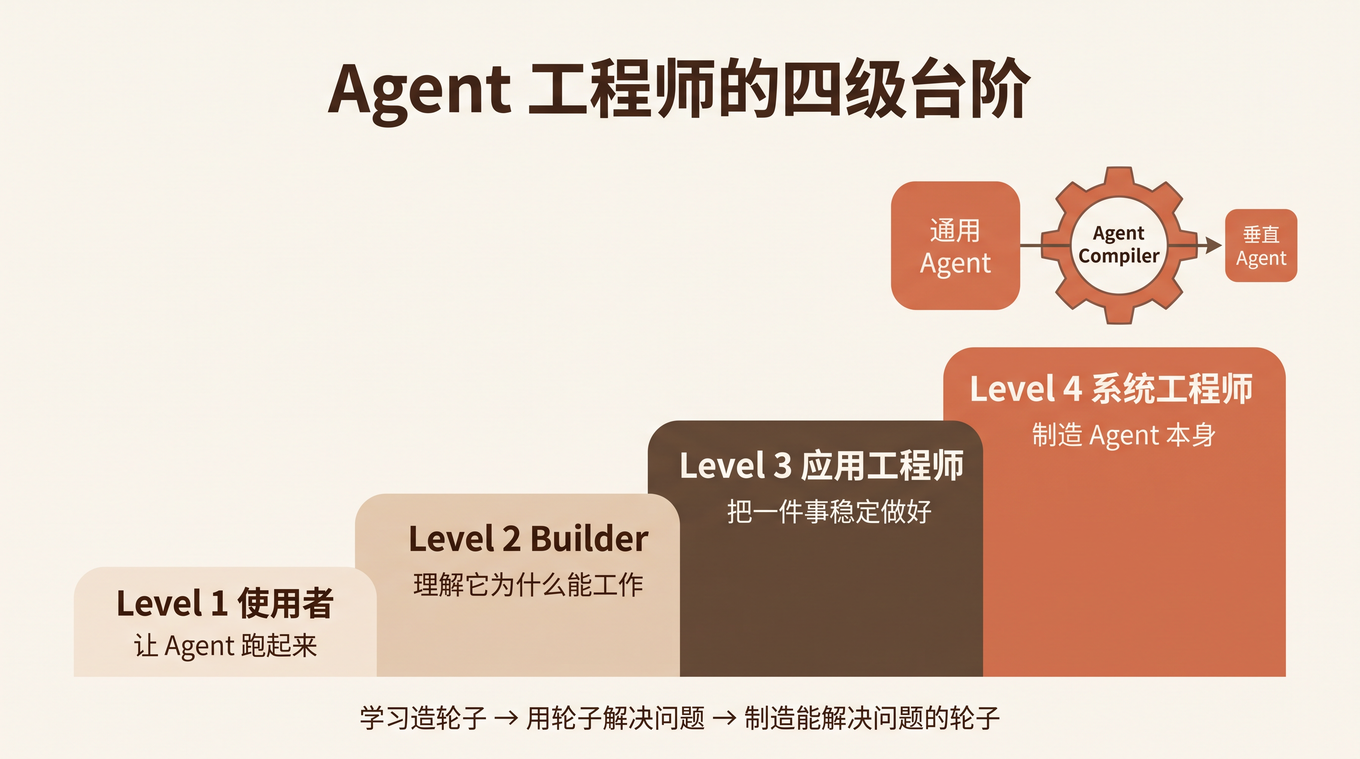
那一刻我没有继续追问,但一个问题在我脑子里转了一下午:今天成为一个 Agent 应用工程师,真正重要的到底是什么? 是能够自己写一个 Agent Loop,还是能够把 Agent 真正做成一个有价值、能生产、能赚钱的产品?

这篇文章把那条成长路线完整画出来。

From Building Agents to Manufacturing Agents: A Growth Path for Agent Engineers

[Read More]

AI Test Ready:把 Tauri 应用改造成可被 AI Agent 测试的系统

Engineering Practices for Making Desktop Apps Testable by AI Agents

上周我让 Claude Code 帮我跑一遍我的 Tauri 笔记应用的回归测试。给它的任务很简单:「新建一条笔记,输入’hello’,保存,重启应用,验证笔记还在」。

它失败了。不是因为应用有 bug,而是因为它根本看不见这个应用——它能启动进程、能截屏,但屏幕里的「新建按钮」对它来说是一团像素;它知道「保存」这个动词,但不知道怎么把这个动词翻译成 IPC 调用;它甚至不知道「重启之后笔记是否还在」这件事该去哪里查证。

那一刻我意识到:让 AI 测试一个应用,瓶颈从来不在 AI 的能力,而在于这个应用本身是否「可被 AI 测试」。这是一种新的工程属性,我把它叫做 AI Test Ready。

[Read More]