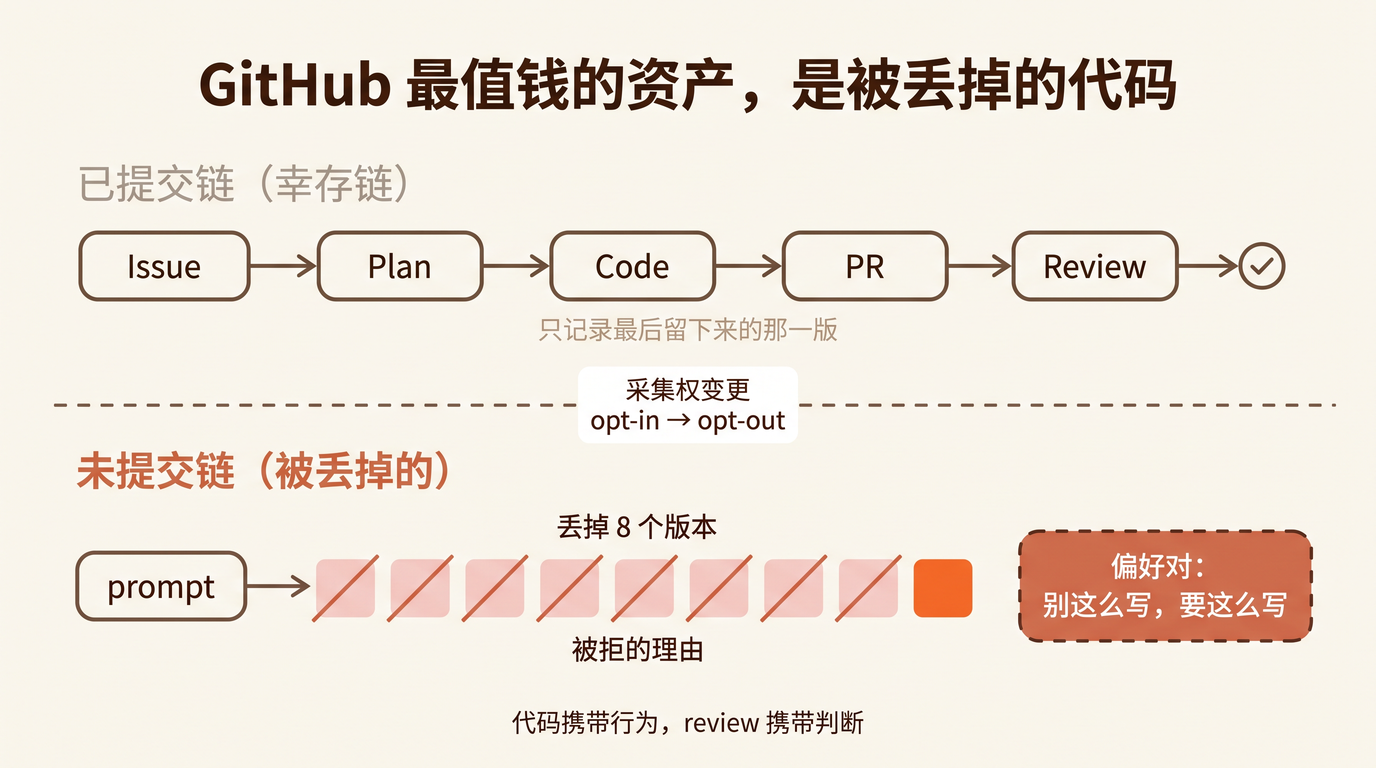
GitHub 最值钱的资产,是被丢掉的代码:观测层之争已经打响了

GitHub's Most Valuable Asset Is the Code It Threw Away

2022 年 3 月 10 日,我写了一篇 Google Analytics 4 简介,从事件跟踪讲到导出 BigQuery,写得挺认真。

那篇文章发表前两个月,奥地利数据保护局裁定 Google Analytics 违反 GDPR;发表前一个月,法国 CNIL 跟上。我当时知道这件事,但没当回事——一个免费工具被欧洲监管盯上,离一个中国工程师的日常太远了。

四年多以后回头看,那两个月恰好是一个分水岭:一个平台用免费换来了整个互联网的行为观测层,然后看着这个观测层被主权一刀一刀切掉。 我今天要写的是另一件事,但它是同一个剧本的第二幕——只不过这一幕的主角换成了代码,而幕布在 2026 年 4 月 24 日已经拉开。

那天 GitHub 改了一个开关的默认值。
GitHub’s Most Valuable Asset Is the Code It Threw Away

[Read More]

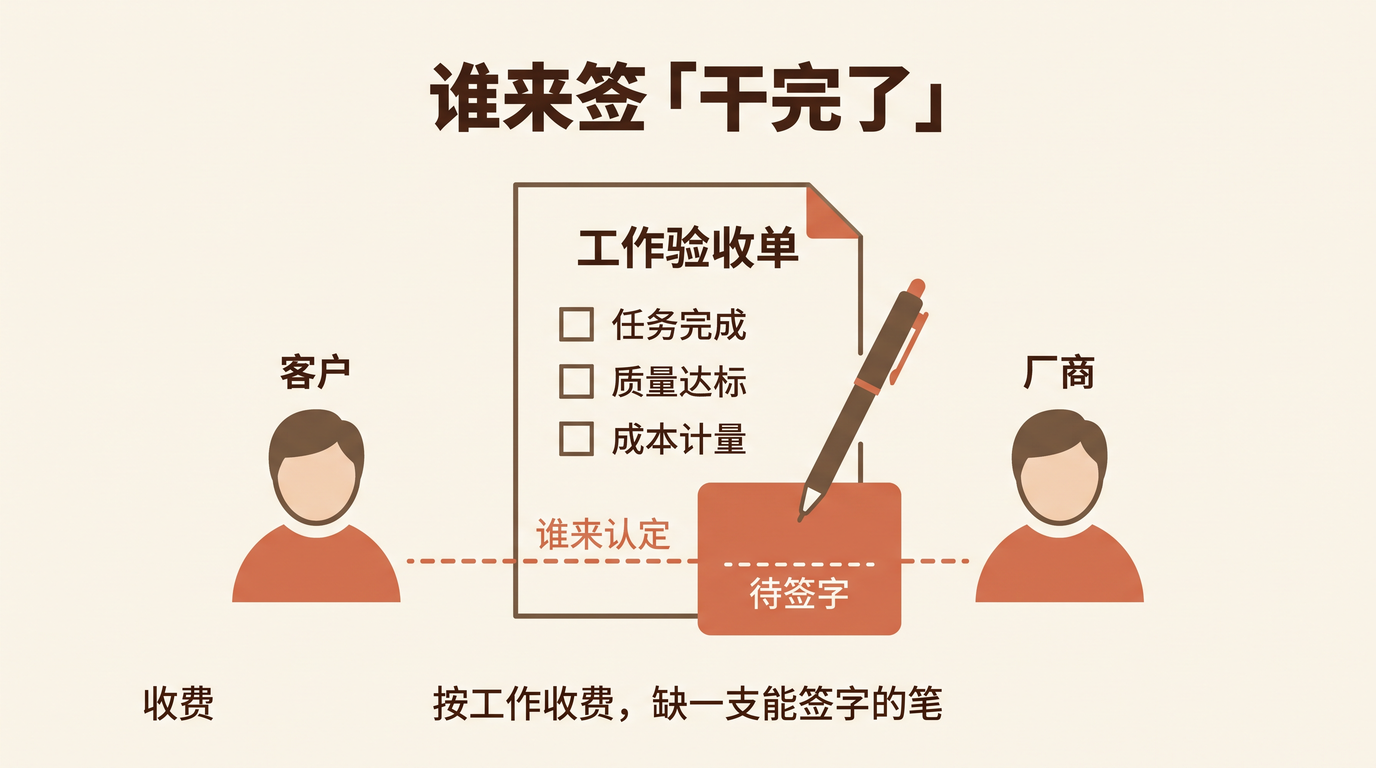
数字员工按工作收费,谁来签「干完了」

Work-Based Pricing for Digital Employees Needs a Notary

今年 4 月 17 日,Anthropic 上线了 Claude Design,直接对着 Figma 和 Canva 打。这件事在产品层面不算新闻——又一个 AI 生成界面的工具。真正值得注意的是它绕过的是什么:它让一部分设计工作不再需要打开 Figma。

OpenRouter CEO Alex Atallah 在那场访谈里的判断比我狠:他把 Claude Design 看作一种战略动作,「它未必立刻带来巨额收入,却能让设计团队在组织内部更关心 Anthropic 模型」。同时他也诚实地补了一句——从 Figma 公开的经营数字看,它表现依然很好。

两句话放一起,才是完整的事实:被绕过的那部分工作,还没大到能动财报。但方向已经定了——软件的用户界面,正在从「给人操作」变成「给 Agent 调用」,而当人不再打开界面,按人头卖软件的那本账,就开始算不动了。

这篇文章想说的是:数字员工和「给 SaaS 加个 AI 助手」的差别,不在功能强弱,在交付结构和定价单位。而定价单位真要换过去,缺的不是技术,是一个签字的人。

Work-Based Pricing for Digital Employees Needs a Notary

[Read More]

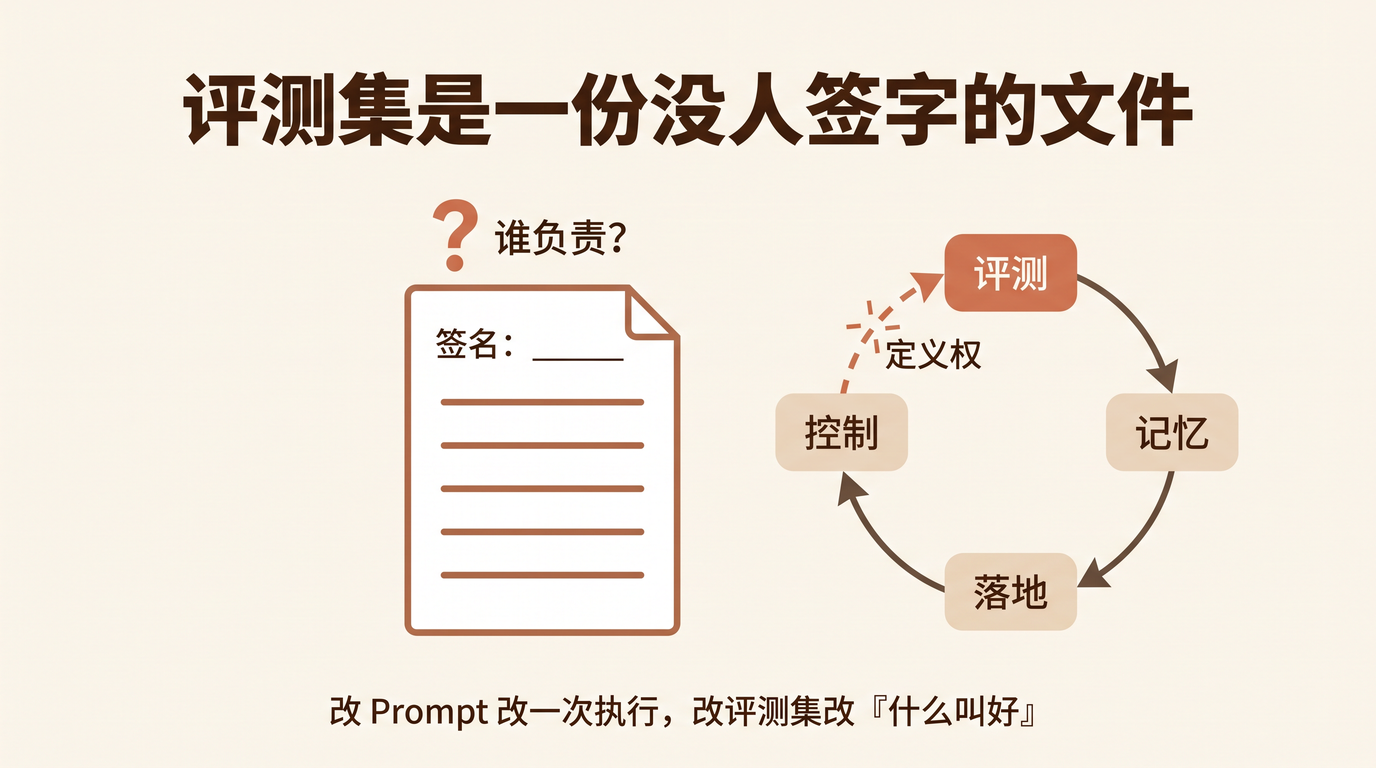
评测集是一份没人签字的文件

An Unsigned Eval Set Is a Flywheel Without an Owner

最近读到一篇两万字的 Agent 自进化方法论,写得相当扎实。其中记了一条血泪教训:有团队在某个场景上连续 20 多轮自动迭代,效果一直不提升——最后发现根因根本不在配置层,而在工具层。20 多轮里,系统忠实地修 Prompt、改 Skill,每一轮都按评测信号在优化。

回头看,最惊人的不是根因藏得深,而是这 20 多轮里,没有一个人问过:这批评测 case 本身,选对了吗?

没人问,因为没人需要问——这份评测集没有主人。

这篇方法论(作者 yannisyang、ethanytzhou)把评测、记忆、落地、控制四个环节拆成飞轮:评测是眼睛,记忆是大脑,落地是手脚,人机协作是方向盘。四个齿怎么建、坑在哪、从零到一怎么落地,都讲了。它最有价值的一句话是:

大多数团队的问题恰恰在于:每个组件内部做得还行,但组件之间的「箭头」没有自动化。

飞轮的瓶颈不在齿,在齿与齿之间的通路。我完全同意——但沿着这句话再往下推一步,会发现一个这篇两万字没有回答的问题:

所有箭头里最上游的那一条——「什么叫好」——它的定义权在谁手里?

An Unsigned Eval Set Is a Flywheel Without an Owner

[Read More]

为 Agent 设计极限挑战任务:AI 时代 Agent 架构师的新价值

Designing Extreme Challenge Tasks for Agents: The New Value of AI Architects

当 AI Agent 能够自主编写代码、调用工具、完成任务时,架构师的价值在哪里?

答案可能出乎意料: 架构师的核心竞争力,正在从「设计系统」转向「设计挑战」

在 AI 时代,最有价值的架构师不是那个能写出最复杂 Prompt 的人,而是那个能设计出最刁钻测试用例、最极端边界场景、最能暴露系统脆弱性的「极限挑战设计师」。

这就像 SRE 领域的混沌工程(Chaos Engineering)——最有价值的不是搭建一个完美的系统,而是设计出一套能持续发现系统弱点的实验。

[Read More]

Agent-as-a-Judge:自进化Agent的眼睛

Why self-evolving agents need automated evaluation to survive long-horizon tasks

上周,一个朋友的团队遇到了这样一件事:他们部署了一个 Coding Agent,让它独立完成一个微服务模块的重构。Agent 跑了整整 6 个小时,提交了 47 个 commit,改了 2000 多行代码。第二天早上,Tech Lead 打开 PR,看着满屏的 diff,沉默了五分钟,说了一句:“我怎么知道它中间做对了什么、做错了什么?”

这不是个例。随着 Agent 能处理的任务越来越长、越来越复杂,一个被忽略的问题浮出水面:谁来评估 Agent 的工作?

[Read More]