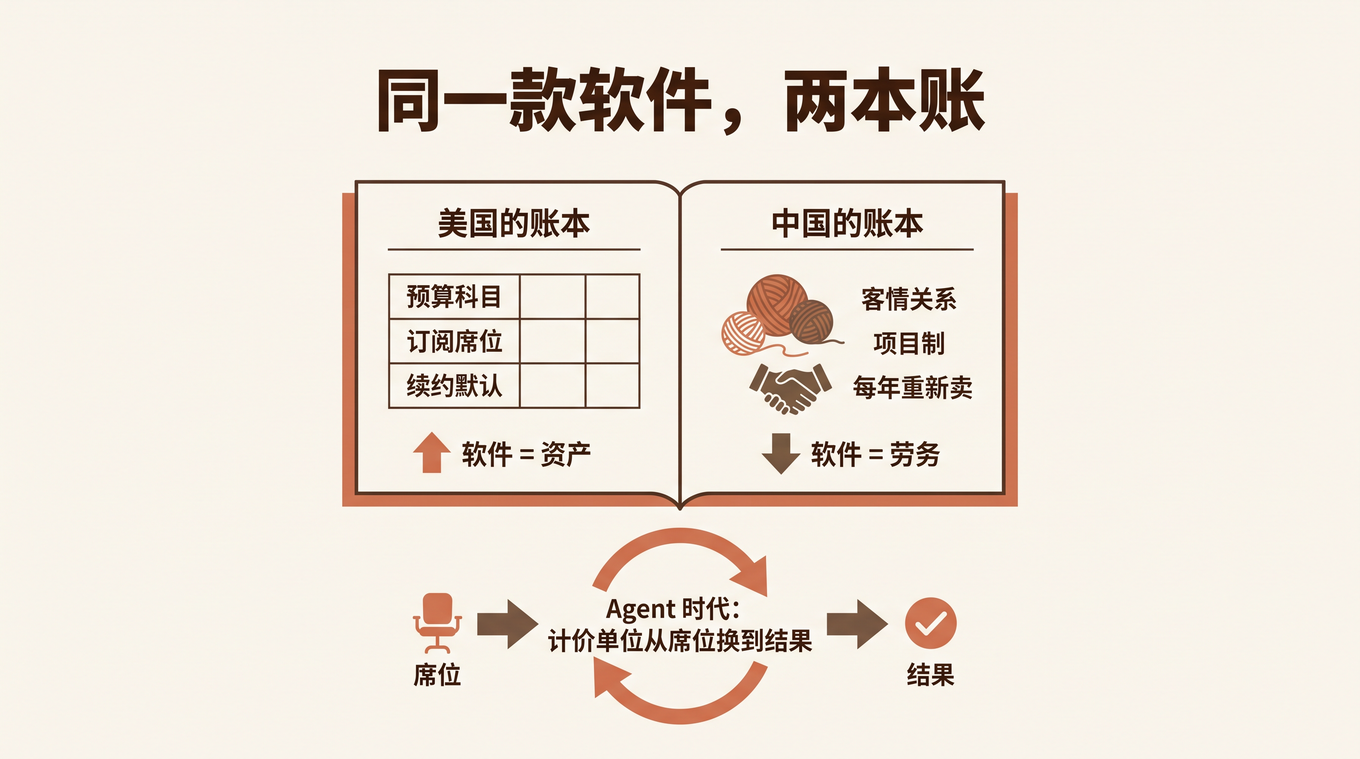
同一款软件,两本账:为什么美国 SaaS 赚钱,中国 SaaS 不赚钱

Same Software, Two Ledgers: Why American SaaS Prints Money and Chinese SaaS Bleeds

今天在上海 GTLC 全球科技领导力大会现场,白鲸开源 CEO 郭炜讲了一个段子,全场笑完之后是长长的沉默。

Astronomer 的 CEO 在演唱会亲吻镜头上了大屏幕,绯闻全网疯传。多数吃瓜群众不知道这家公司是干什么的——它是 Apache Airflow 的商业母公司,美国数据工作流赛道的第一名。而郭炜的公司是 Apache DolphinScheduler 的原厂,中国第一。

同样的赛道,同样一万家开源用户,同样一批头部客户。 美国那边,CEO 豪车豪宅上小报;中国这边,用他的原话说:「客户虐我千百遍,我待客户如初恋。」

他给的量级判断更扎人:中美市场差异不是几倍,是 100 倍。

为什么?软件做得差吗?他在硅谷待了一个多月,拜访了 Snowflake、Databricks 峰会和一圈大厂之后的结论是:产品和技术好不好,从来不是中国软件活不活得下去的关键——很多国产软件的技术已经进入美国市场第一梯队。问题出在别的地方。出在账本上。
Same Software, Two Ledgers: Why American SaaS Prints Money and Chinese SaaS Bleeds

[Read More]

任务好搬,关系难搬:AI 产品留存的三任务结构

Task Migration Is Cheap, Relationship Migration Is Expensive: A Three-Task Retention Model

上一篇 两个对手,同一套打法 里,我写 Grok Bot 和 Claude Cowork 两个团队怎么做产品,里面藏了一个我没展开的细节:主持人 Lenny Rachitsky 说,他已经把自己的不少用例从 Cowork 和 Codex 迁到了 Grok Bot 上——迁得非常快。

文章发出去之后,这句话一直在我脑子里转。媒体叙事是「桌面 Agent 是新大陆,用户圈地之后就不会再动」;可生态里最重度的用户、播客主持人本人,一个周末就把家搬了。

那么问题来了:用户从 Cowork 迁到 Grok Bot,代价到底大不大?

我的答案分两半:任务搬家便宜,关系搬家贵。一个用户能迁走多少,取决于他在这个产品里存放了什么。这篇文章用我自己做样本来拆——我给自己的数字员工「涌现」搬一次家,看看什么带得走,什么带不走;拆完你会发现,「带不走的东西」正好回答了第二个问题:AI 产品满足用户的哪三个任务,才能把他变成长期付费用户。

Task Migration Is Cheap, Relationship Migration Is Expensive: A Three-Task Retention Model

[Read More]

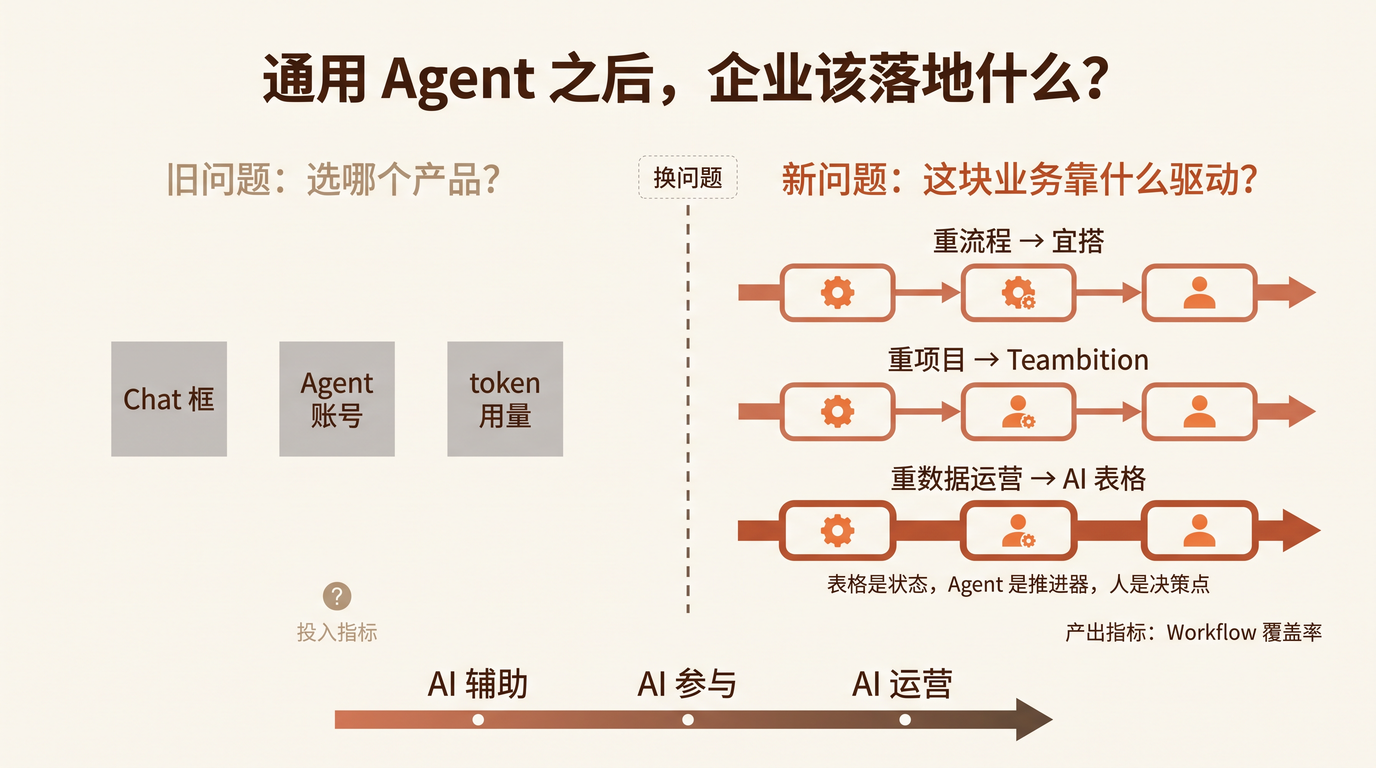
通用 Agent 之后,企业真正应该落地什么?

After the General Agent, What Should Enterprises Actually Deploy

上个月一个 CIO 给我看他们的 AI 成果清单,讲得很顺:接入了多少个 Agent、开了多少智能体账号、买了多少 token、做了几场全员培训。我听完问了他一句:「你们每天真实发生的业务里,有多大比例是 Agent 参与完成的?」

他停住了。停了几秒,说:「这个我们没统计过。」

这不是个例。绝大多数企业的 AI 成绩单,记的都是投入项——买了多少、接了多少、开了多少。而真正决定 AI 能不能产生业务价值的那个数字,没人算过。

通用 Agent 之后,企业要解决的,不是再做一个更聪明的 Chat,而是把 AI 真正嵌进每天发生的协同工作流。

过去企业数字化的路径大致是:

业务流程 → 表单 / 审批系统 → 人来操作系统
# generated by hugo AI

AI 时代正在变成:

业务目标 → Agent 理解与执行 → 人做判断与审核
# generated by hugo AI

所以引入通用 Agent 只是第一步。真正的问题是:你的企业有没有一个能让 Agent 进入、理解、执行、反馈、持续优化的工作流载体。 没有载体,Agent 再聪明也只是停在对话框里。

After the General Agent, What Should Enterprises Actually Deploy

[Read More]

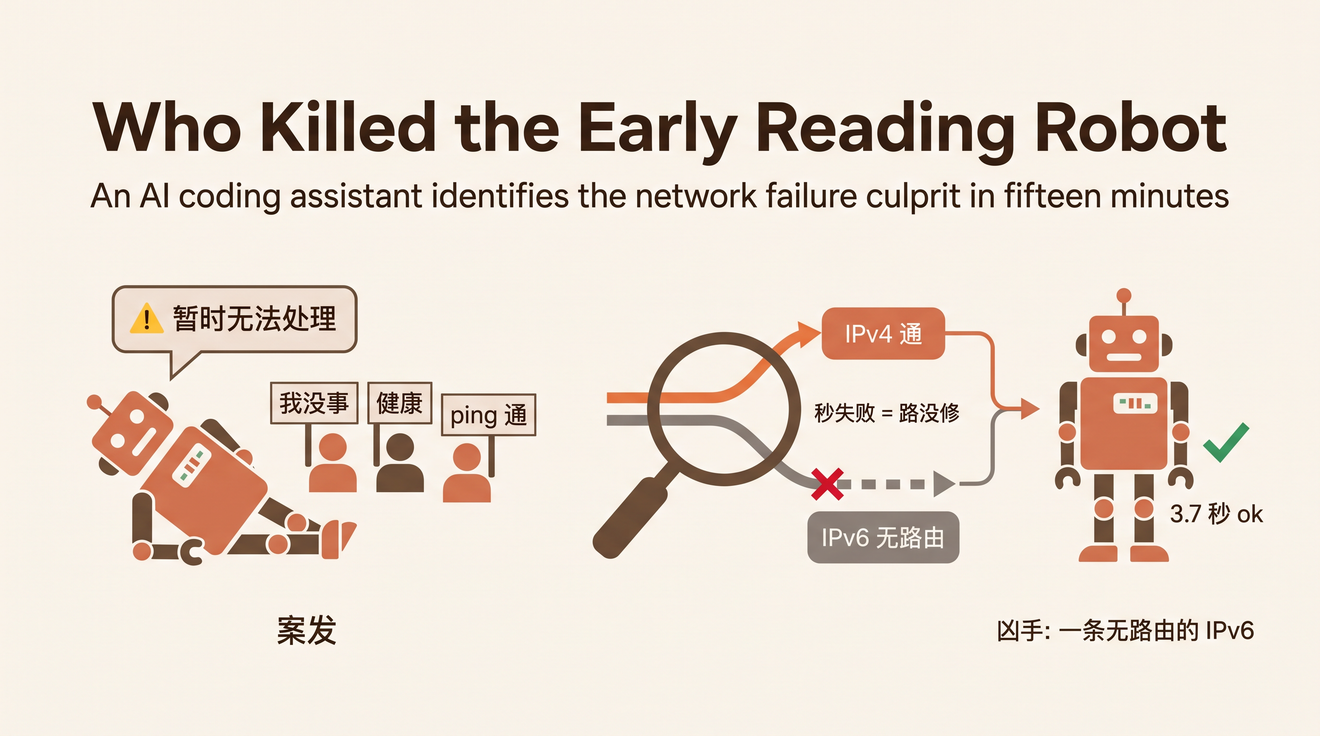
谁停掉了数字员工的早读?

Who Stopped the Digital Employee's Morning Reading? — A 15-Minute Autopsy by an AI Agent

我的钉钉数字员工每个月偶尔会抽下风:「⚠️ 暂时无法处理你的消息,请稍后再试。」,往往重启一下就好了。今天我让 opencode + GLM-5.3 排查了下这个问题。

十五分钟后,它把案子破了。凶手很狡猾:藏在三份完美证词背后,还顺走了我的 /etc/hosts 当人质。

Who Stopped the Digital Employee’s Morning Reading? — A 15-Minute Autopsy by an AI Agent

[Read More]

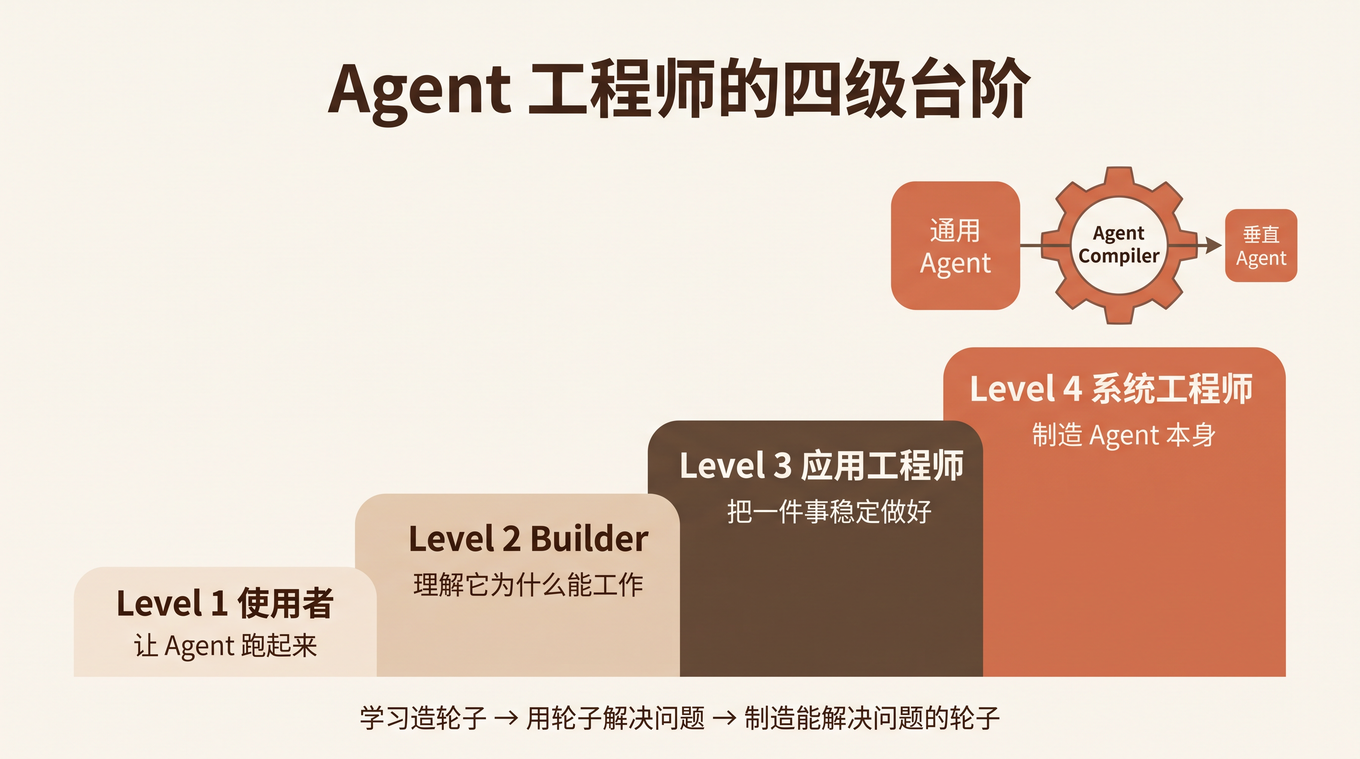
从会做 Agent 到制造 Agent:一个应用工程师的成长路线

From Building Agents to Manufacturing Agents: A Growth Path for Agent Engineers

今天和一个朋友聊天。他说自己做了一个非常精简的 Agent Harness,准备开源,让大家可以直接用。

我第一反应不是问他写了多少代码,而是问:

你看过 Pi Agent、OpenCode、DSH 吗?

他说,没有深入研究过。

那一刻我没有继续追问,但一个问题在我脑子里转了一下午:今天成为一个 Agent 应用工程师,真正重要的到底是什么? 是能够自己写一个 Agent Loop,还是能够把 Agent 真正做成一个有价值、能生产、能赚钱的产品?

这篇文章把那条成长路线完整画出来。

From Building Agents to Manufacturing Agents: A Growth Path for Agent Engineers

[Read More]

数字员工上岗半年,我在钉钉上的时间翻了一倍

AI Won't Build a New Entry Point — It Deepens Your Dependence on the Old One

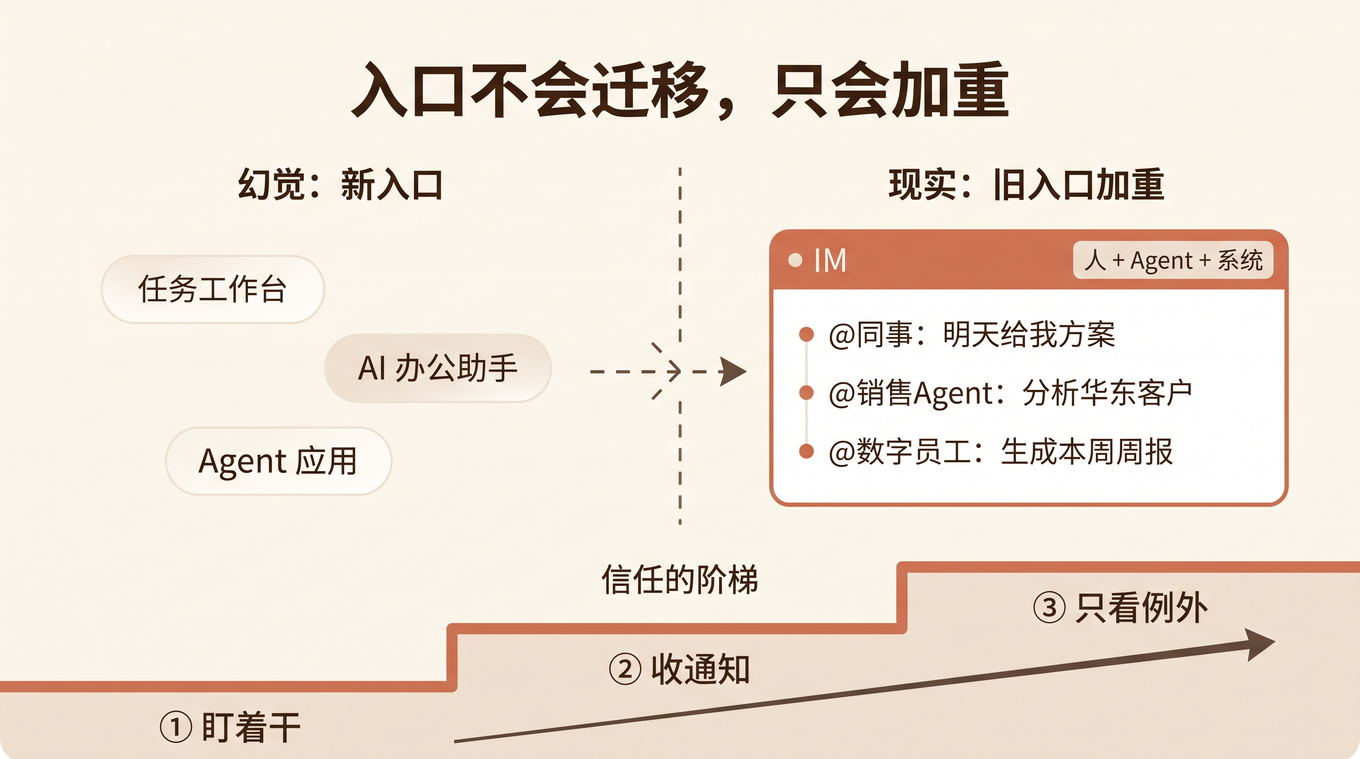
半年前,我给自己上了第一批数字员工。上岗之前,我的想象是这样的:任务交给 Agent,我只管派活和收结果,我在钉钉上的时间应该大幅下降。

半年后,我打开自己的屏幕时间统计:我在钉钉上的时间没有下降——翻了一倍。

起初我以为是个体差异。但和几位同样在带数字员工的同事交流后,发现大家的处境差不多:Agent 越多,人在 IM 里花的时间越多。

这让我必须把一个判断写下来:

AI 不会造出新入口,只会加深你对旧入口的依赖。

AI Won’t Build a New Entry Point — It Deepens Your Dependence on the Old One

[Read More]

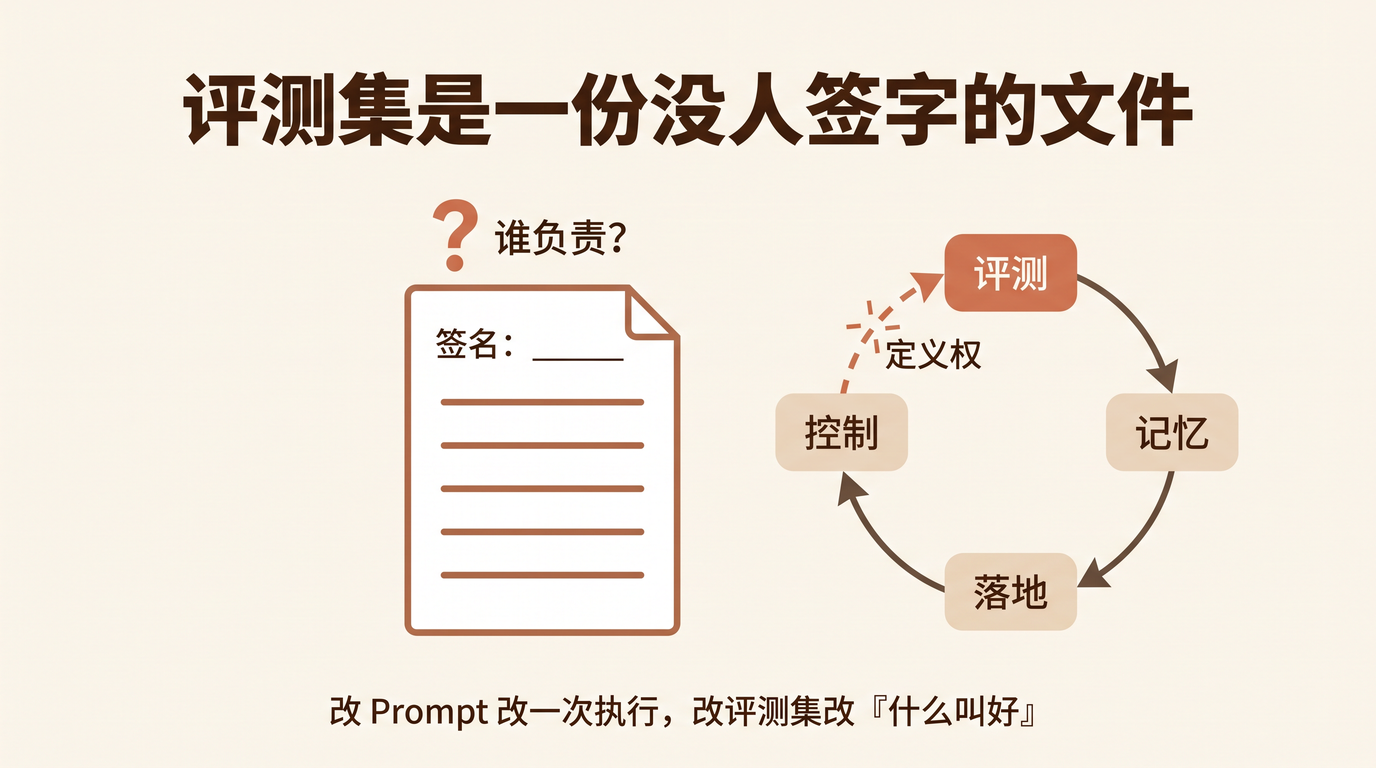
评测集是一份没人签字的文件

An Unsigned Eval Set Is a Flywheel Without an Owner

最近读到一篇两万字的 Agent 自进化方法论,写得相当扎实。其中记了一条血泪教训:有团队在某个场景上连续 20 多轮自动迭代,效果一直不提升——最后发现根因根本不在配置层,而在工具层。20 多轮里,系统忠实地修 Prompt、改 Skill,每一轮都按评测信号在优化。

回头看,最惊人的不是根因藏得深,而是这 20 多轮里,没有一个人问过:这批评测 case 本身,选对了吗?

没人问,因为没人需要问——这份评测集没有主人。

这篇方法论(作者 yannisyang、ethanytzhou)把评测、记忆、落地、控制四个环节拆成飞轮:评测是眼睛,记忆是大脑,落地是手脚,人机协作是方向盘。四个齿怎么建、坑在哪、从零到一怎么落地,都讲了。它最有价值的一句话是:

大多数团队的问题恰恰在于:每个组件内部做得还行,但组件之间的「箭头」没有自动化。

飞轮的瓶颈不在齿,在齿与齿之间的通路。我完全同意——但沿着这句话再往下推一步,会发现一个这篇两万字没有回答的问题:

所有箭头里最上游的那一条——「什么叫好」——它的定义权在谁手里?

An Unsigned Eval Set Is a Flywheel Without an Owner

[Read More]

麦肯锡终于说了:Agent 也要绩效考核——但他们没说怎么考

McKinsey Says Agents Need Performance Management — But Not How to Measure Them

8 月底,麦肯锡的播客 McKinsey Talks Talent 里,主持人 Lucia Rahilly 抛出了一个很多公司都在回避的问题:Agent 进了核心工作流,谁来管它?

资深合伙人 Brooke Weddle 的回答很直接:「HR 管理的不再只是人类的绩效,现在还有数字员工。」 全球技术与 AI 负责人 Kate Smaje 接着把问题拆成了三问:

「我到底有多少个 Agent?谁对它们的绩效负责或担责?它们创造了多少价值?」

问完,她自己补了一句更狠的话:当她问企业「上次讨论非人类劳动力的绩效是什么时候」——「几乎没有组织能回忆起自己把这件事排上过议程。」

听到这三个问题的时候,我愣了一下——这不是新闻,这是我今年 3 月起就在博客里反复写的那一系列问题。麦肯锡用了整个 8 月,终于追上了这条线。

他们给出的答案也对:Agent 归使用它的业务负责人管,不是 IT,不是 CTO。 这和我在数字员工的第一准则不是可控性里推导的主管制,几乎是同一个结论的两条路径——他们从管理实践归纳,我从问责公理演绎,殊途同归。

但这份答案只答了一半。

[Read More]

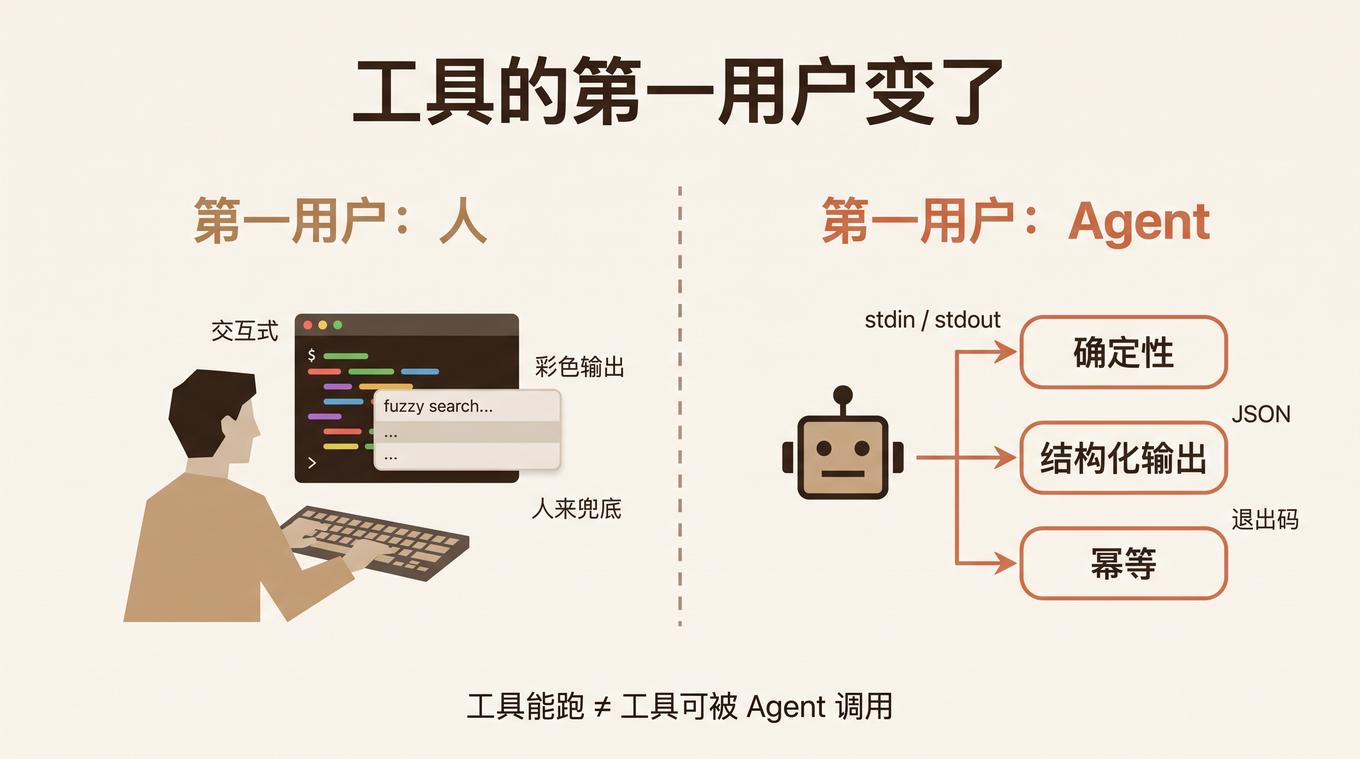
Agent 开发者的工具箱:标准比清单重要

An Agent-First Toolchain — Criteria Matter More Than the List

前几天有人给我发了一份「2026 年 Agent 开发者工具箱」清单,整整 15 个名字:git、gh、docker、uv、node、pnpm、nvm、rg、jq、curl、fzf、just、direnv、python、go。分层清晰,还配了星级。

我顺手在自己这台跑 Agent 的机器上核对了一遍,结果很有意思:15 个里我只装了 7 个。

for t in git gh docker uv node pnpm nvm rg jq curl fzf tmux direnv just mise; do
  command -v "$t" >/dev/null && echo "$t: yes" || echo "$t: NO"
done
# generated by hugo AI

git、gh、uv、node、pnpm、rg、curl 在;docker、jq、fzf、tmux、direnv、just、mise 一个都没有。机器没罢工,Agent 每天照样在上面干活。

所以我没有急着去补齐那 8 个缺口,而是先问了一个更基本的问题:这份清单是按什么标准选的?是给人用的,还是给 Agent 用的?

这两个问题的答案,会导出两份完全不同的清单。

An Agent-First Toolchain — Criteria Matter More Than the List

[Read More]

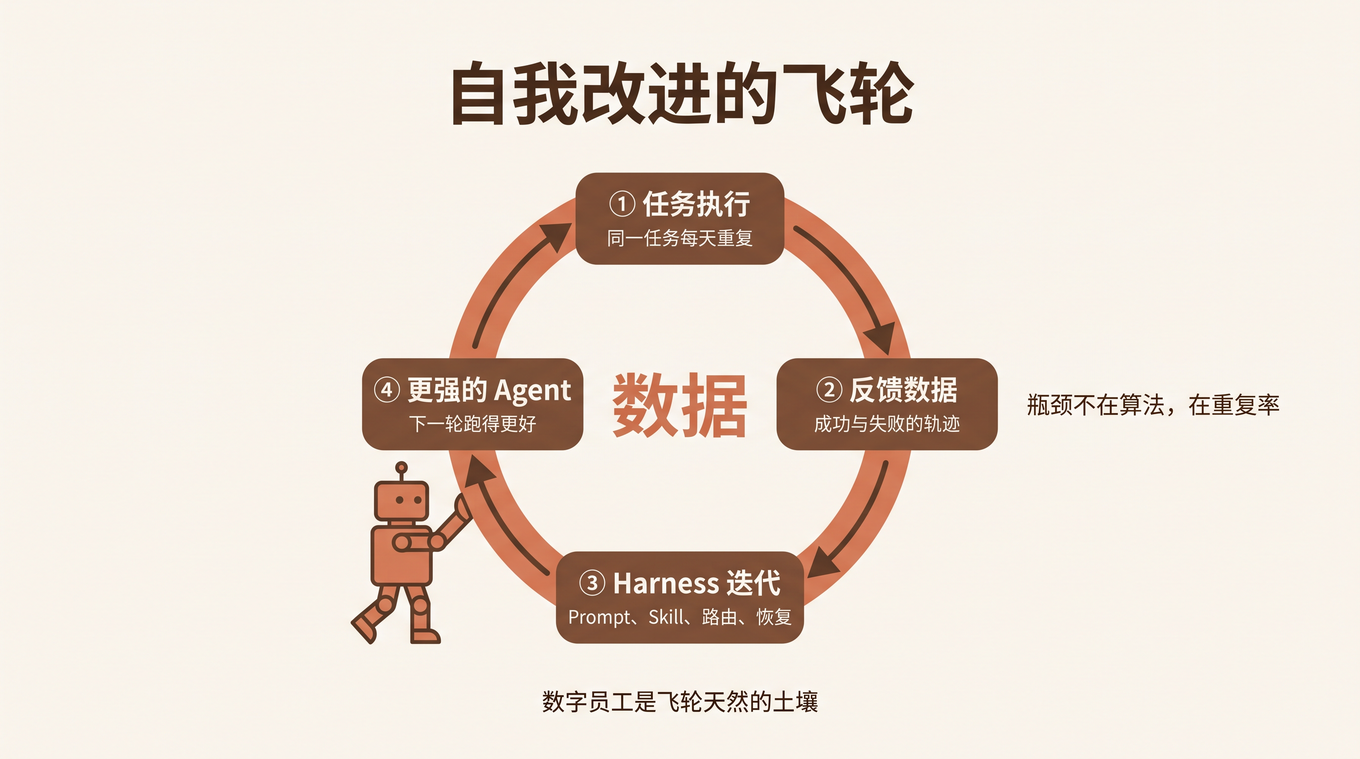
数字员工的自我进化:从 Harness 开始,每天重复干同一件事

Harness RSI Runs on Production Data, Not Algorithms

最近读了一篇关于 Harness 自进化的报道,里面有个细节让我停下来想了很久。

停下来的原因,是我们自己也卡在这里:数字员工上线一段时间了,它好像变「顺手」了,但说不清是不是变「聪明」了。这个模糊感,恰好被报道里的三个数字点破。

报道里那家公司说(厂商自报口径):他们平台上 95% 以上的 Agent 被每天重复运行;在留存用户中,93.4% 的操作是系统自触发的;超过六成的自动化流程持续运行了一个月以上。

大多数人读到这三个数字,看到的是「这家公司用户很多」。我看到的是另一件事:这三个数字加起来,恰好是递归式自我改进(RSI)最稀缺的原料。

Harness RSI Runs on Production Data, Not Algorithms

[Read More]