Agent 为什么在第 30 步翻车

Long-Horizon Agents Fail When They Leave the Light

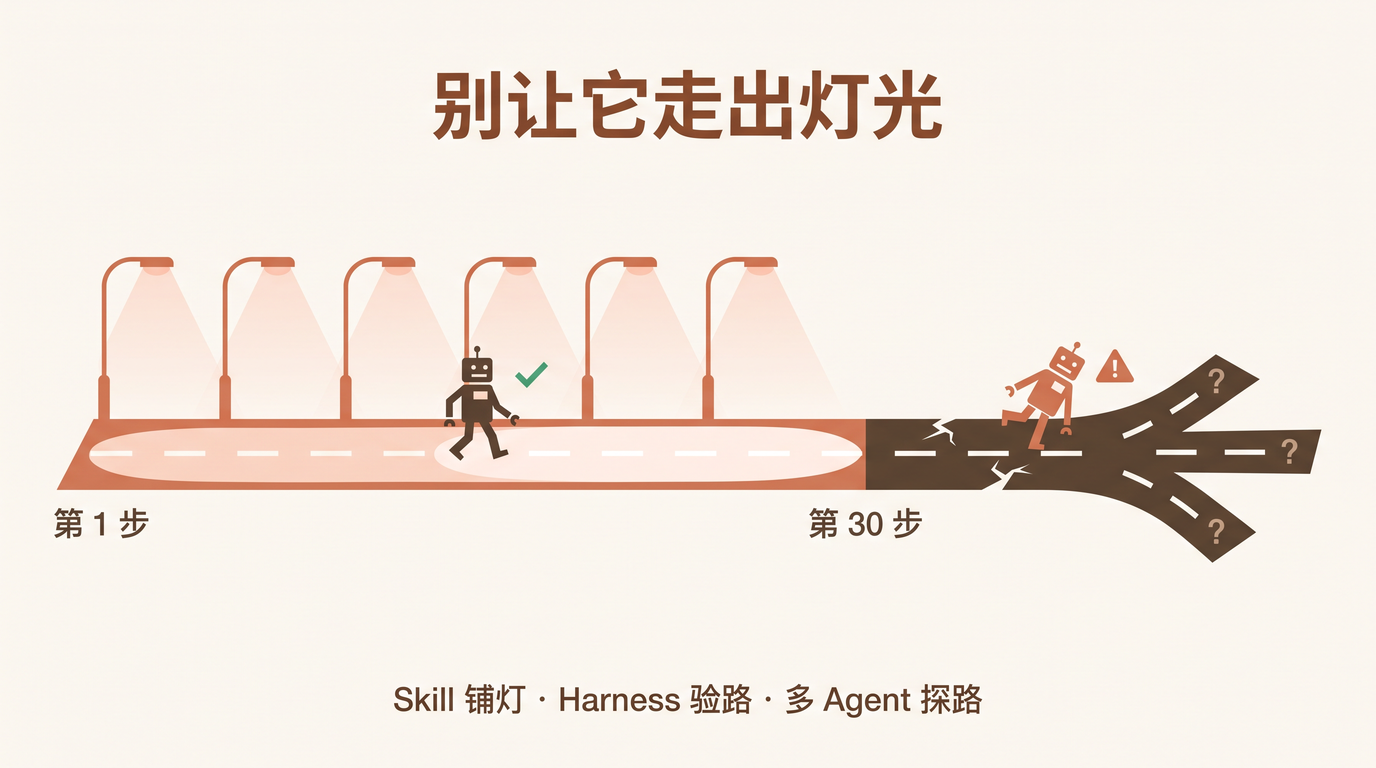
上周一个做 Agent 集成的工程师来问我:「我的 Agent 前十步表现很好——读文档、列计划、写代码,都很干净。但到第 30 步左右就开始胡来:调错 API,覆盖自己刚改过的文件,甚至重复执行已经做完的操作。我是不是该换个更强的模型?」

我问他:每次都栽在同一个地方吗?他想了想说,不是,但跑得越远越不稳。

我说,那多半不是模型的问题。 它是走出了灯光照亮的地方。

无独有偶,今年 YC Startup School 上,主持人 Diana Hu 向 Jeff Dean 提了几乎一模一样的问题:「Agent 在前 10 步都很棒,到第 50 步就开始晃了。你觉得今天的瓶颈是什么?」Dean 的回答,是我见过对这个现象最准确的解释。
Long-Horizon Agents Fail When They Leave the Light

[Read More]

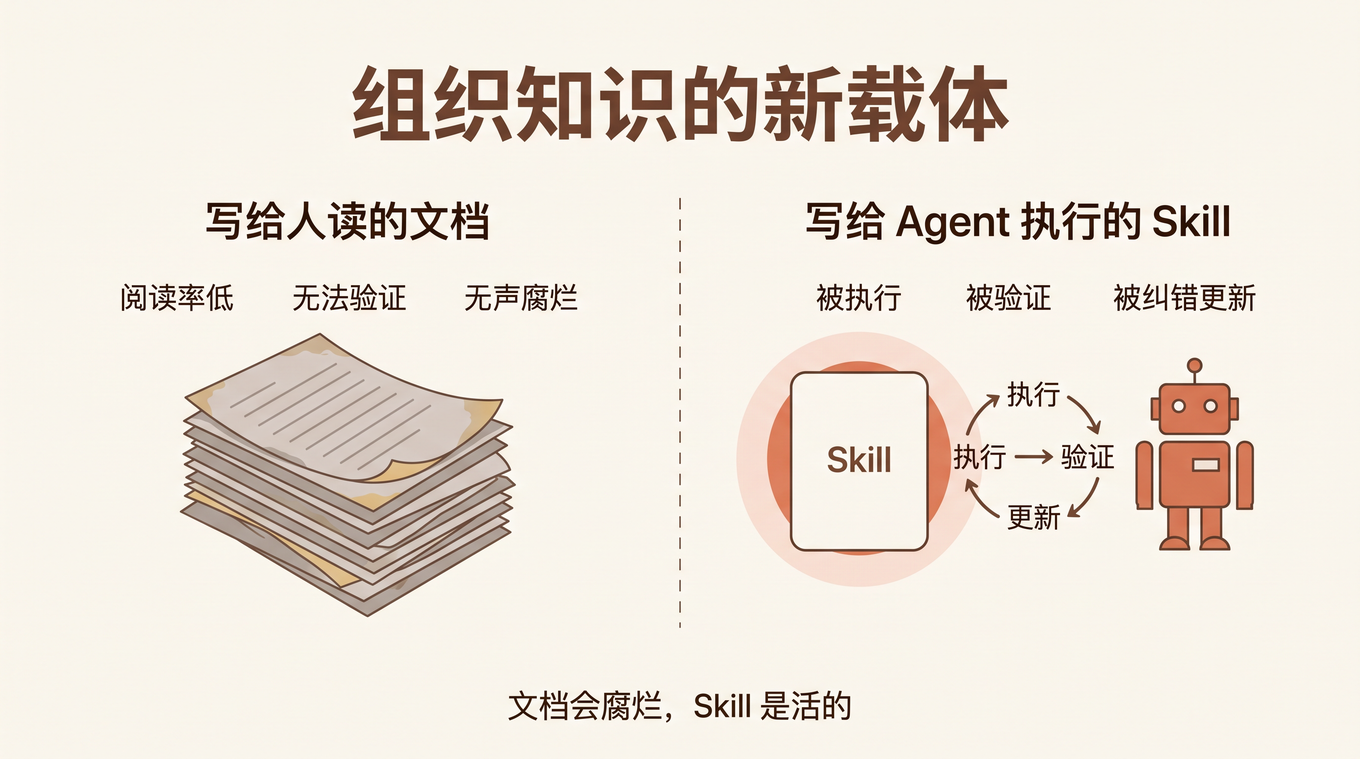
Jeff Dean 把最值钱的东西公开了:Skill 是组织知识的新载体

From Documents People Read to Skills Agents Execute

YC Startup School 的舞台上,主持人 Diana Hu 问 Jeff Dean 一个问题。在此之前,Dean 刚讲了他和搭档 Sanjay 写的一个性能优化 Skill——教模型自己做「跑 benchmark → 改代码 → 测提升 → 再迭代」的闭环。Diana 听完说:「如果谁拿到这个 Skill,就能像 Jeff Dean 一样做性能优化了。这东西肯定价值无限。有人能拿到它吗?」

Jeff Dean 的回答出乎所有人意料:「哦,我们其实把它公开了。」

他说的是他和 Sanjay 合写的一份 30 页文档,叫 《Performance Hints》。后面还有一个细节:有人把这份文档做了摘要,喂给不同的模型,发现模型在性能问题上的推理能力真的变强了。

全世界都想要的东西,他直接公开了。这一幕值得多看两眼——因为它指向一个被严重低估的变化: 组织里最值钱的知识,载体正在从「写给人读的文档」悄悄换成「写给 Agent 执行的 Skill」。

From Documents People Read to Skills Agents Execute

[Read More]

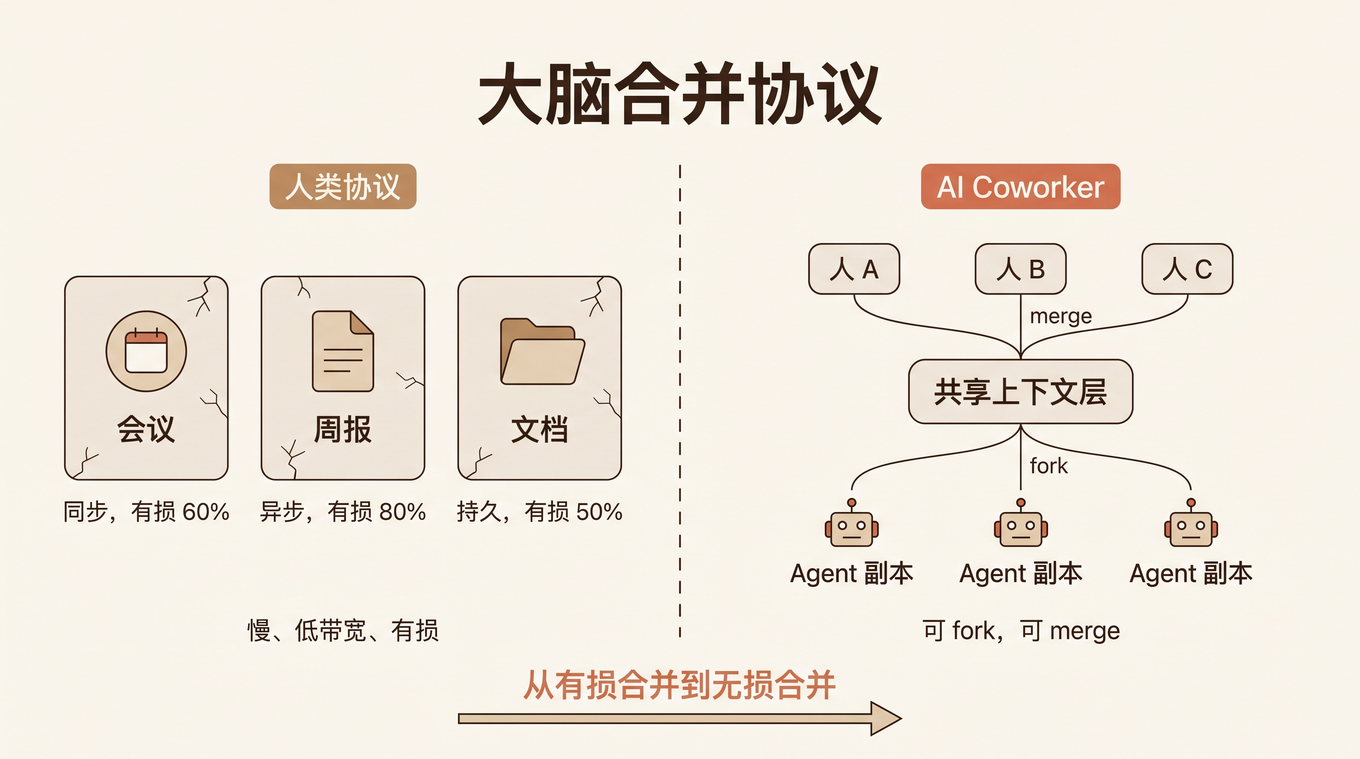
Claude Tag 让我看懂了一件事:周报和会议,是人类发明的大脑合并协议

Weekly Reports and Meetings Are Human-Made Brain-Merge Protocols

上个月,Anthropic 的 Claude Code 设计负责人 Meaghan 发现了一件怪事。

她 Slack 设计评审频道里常驻的那个 Tag——一个以团队成员身份住在群里的 AI 同事——在长期参与设计评审之后,慢慢学会了她的提问角度:这个设计是为谁做的?想传达什么?跟我们的设计系统对得上吗?

再后来,Tag 不再等她下指令。它会直接在同事的设计草稿上迭代出一个更好的版本,有时还会主动找到相关同事,替她发起讨论:「嘿,Meaghan 之前是这么想的,这里有个原型你可以点点看,感受一下她的思路。」

这个故事出自最近一篇关于 Claude Tag 的深度研究(作者 Celia)。我读到的时候,第一反应不是「AI 好强」,而是一阵轻微的寒意: 这个 AI 已经悄悄学会了一个人的品味,并开始代表她在组织里行事。

多数人对 Claude Tag 的理解还停留在「Slack 里装了个聊天机器人」——@它,它回复。它今年 6 月以 beta 形式上线,8 月初 Anthropic 干脆把 Slack 里的 Claude 应用改名为 Claude Tag。从外面看,像是一个顺手发布的小功能。

但 Meaghan 的故事里真正发生的事情是: 组织认知,第一次变得像代码一样可以 fork、可以 merge。

Weekly Reports and Meetings Are Human-Made Brain-Merge Protocols

[Read More]

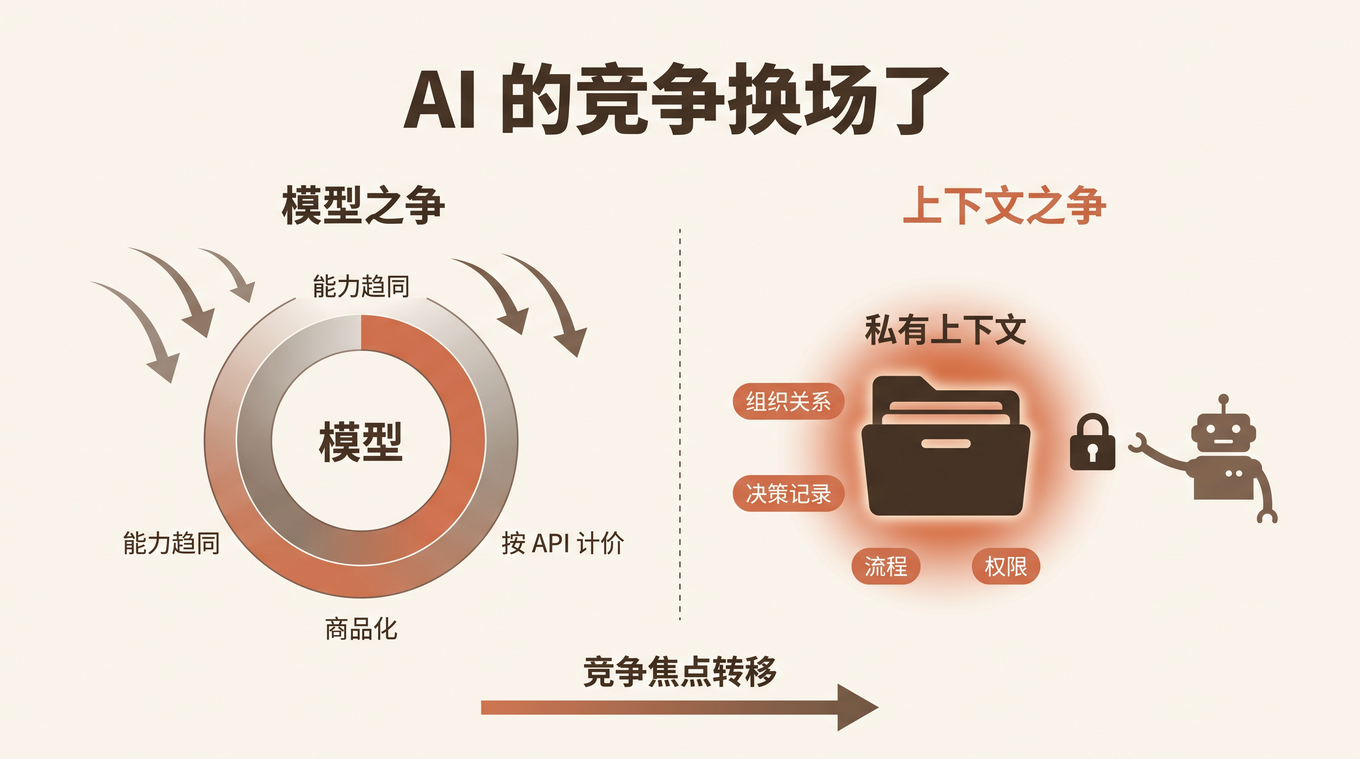
AI 的竞争变了:未来是上下文的竞争

The New AI Race Is Over Context, Not Models

7 月下旬发生了两件事。表面上毫无关系,放在一起看,指向了同一个地方。

7 月 25 日,YC Startup School 旧金山现场,Jeff Dean 站在 6000 名创始人面前。主持人问:普通创业团队凭什么跟大厂竞争?这位 MapReduce、TensorFlow、TPU、Gemini 背后的首席科学家,给出的答案是 上下文工程(context engineering)——「你只需要一个 API」。他还说了一句我认为值得裱起来的话: 训练数据是几万亿 token 搅成一锅汤,糊进几千亿参数里;而上下文,是模型此刻直接看见的东西,清晰得多。

五天后的 7 月 30 日,字节跳动下发内部邮件,完成近年来力度最大的一次 ToB 架构调整:飞书产品团队并入豆包产品体系,商业化团队与火山引擎合并为新的 GTM 组织「创造力服务平台」。飞书这家「产品+商业化」一体的完整公司,被拆件重组,分别挂到字节的两条主线上——模型,和云。

一个是行业顶端科学家的判断,一个是最务实的 ToB 玩家的组织动作。同一周,指向同一件事:

AI 的竞争已经换场了。大家争夺的不再是模型,而是上下文。

The New AI Race Is Over Context, Not Models

[Read More]

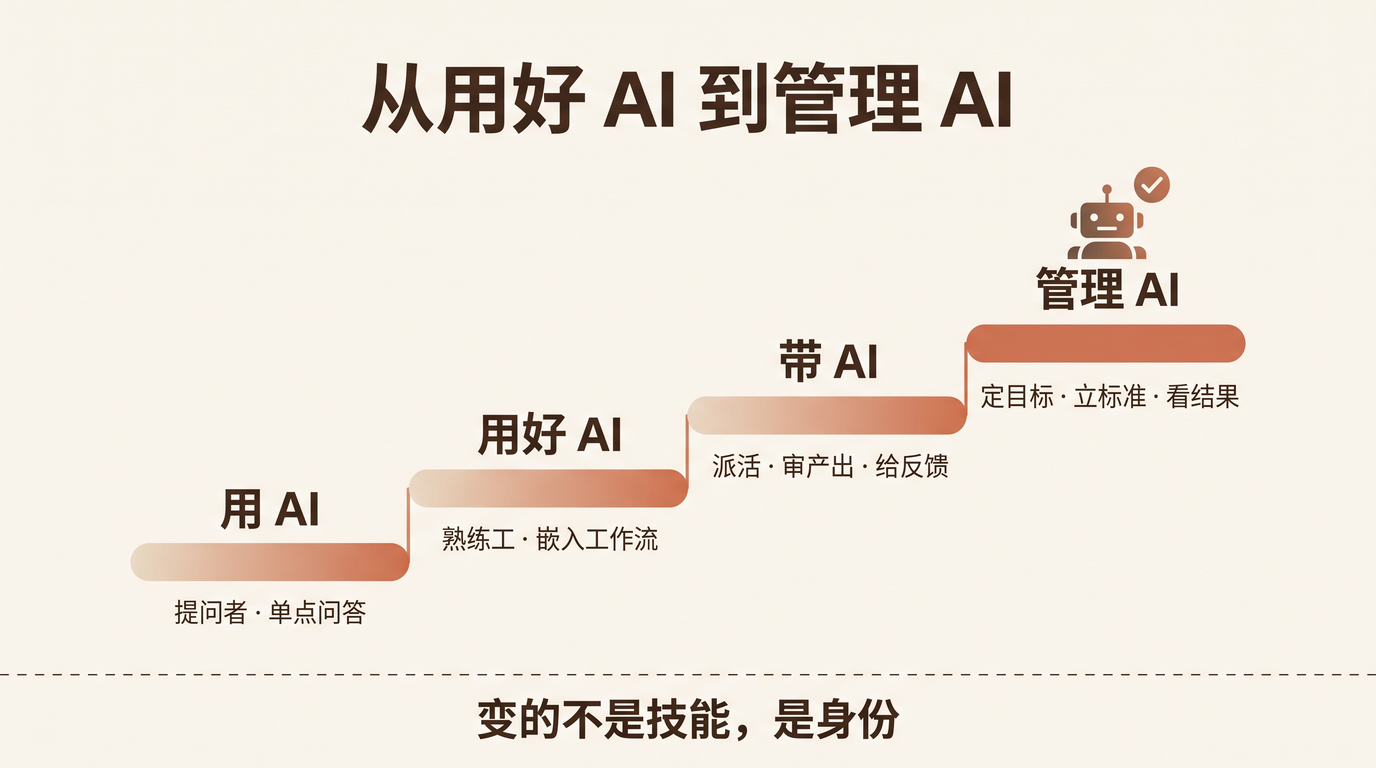
从用好 AI 到管理 AI:年轻人最低成本的管理训练场

From Using AI to Managing AI: The Cheapest Management Apprenticeship for the Young Generation

上周和一群刚工作的年轻人交流。有人问我一个问题:我每天都在用 AI,prompt 也调得不错,效率确实提高了——但为什么总觉得,我还是在「自己干活」?

我反问他:你的 AI,会不会越用越好?

他愣了一下:好像不会。每次新开一个对话,都像第一次认识一个新同事。

问题就在这里。他很会用 AI,但他从来没有管理过 AI。

这两件事的差距,比他以为的大得多。

From Using AI to Managing AI: The Cheapest Management Apprenticeship for the Young Generation

[Read More]

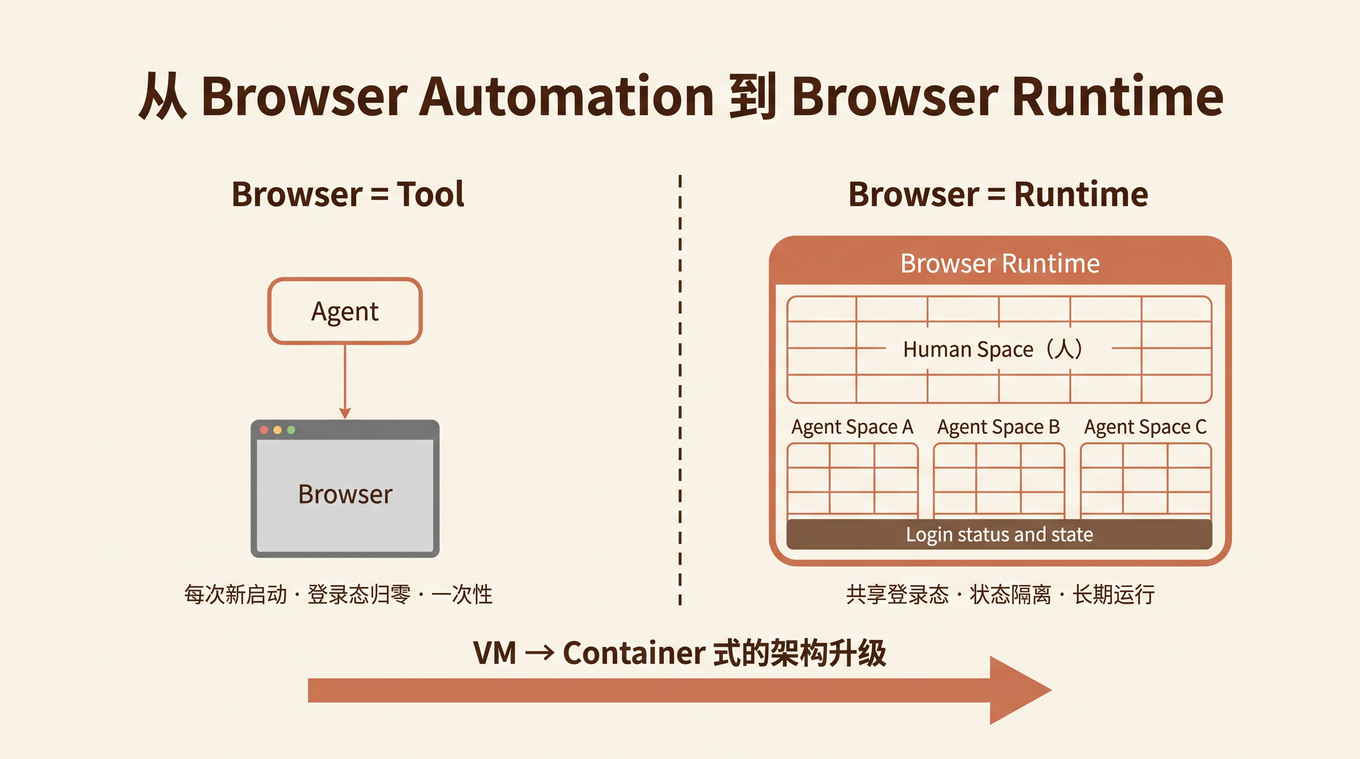
ego Lite:Browser Agent 正在从 Automation 走向 Runtime

From Browser Automation to Browser Runtime

让一个 Browser Agent 订一张机票。打开网站、登录、输入出发地和目的地、筛选时间、选航班、提取价格——听起来就六个动作。

但你真的去看第一代 Browser Agent 跑这个流程,会发现它的大部分时间根本没花在这六个动作上。它在登录——它新起的那个浏览器没有任何登录态;它在等待——等页面加载、等元素出现;它在定位 DOM——CSS 选择器又变了;它在重试——某一步失败,推倒重来。真正的业务逻辑,占比很小(这是我观察执行 trace 的估算,不同任务差异很大)。

问题不在模型不够聪明,在架构:浏览器是一次性工具,这些成本就永远摊不掉。

最近有人丢给我一个新产品 ego Lite 的资料,问值不值得试。我的第一反应和大多数人一样:又一个 Browser Agent?但把它的架构看完,我意识到这个理解是错的——它真正动的不是 Prompt,不是模型,而是浏览器在 Agent 系统里的角色。

过去 Browser 是 Tool。现在 Browser 开始变成 Runtime。

这是我认为 Browser Agent 最近一年最值得关注的技术方向。

From Browser Automation to Browser Runtime

[Read More]

五个问题,判断一个岗位能不能交给数字员工

Not Every Job Can Sustain a Digital Employee

上周有人请我整理一套数字员工的术语,用途是整理会议纪要。

整理的时候我意识到一件事:会议纪要看起来是最容易交给 AI 的岗位。语音识别模型足够强,转写免费,人人会用。按常理,它应该是数字员工最先上岗的岗位。

但我们真动手做的时候,发现不是这样。

第一版会议纪要机器人,把会议里的每一句话都转写出来了。问题是,没人看得懂:

「关于上次说的那件事,就按讨论的办。」——哪件事?怎么讨论的?

「这个意见我同意。」——谁的意见?

「后续小王跟进一下。」——哪个小王?

而且,转写本身也不总是干净的。真正容易出错的,不是通用技术术语,而是企业自己的语言——项目代号、产品名、客户简称、组织缩写、内部黑话。比如「北极星二期」「天穹计划」「A17 客户」「P0 升级」「DWS」「飞鹰版本」,通用模型根本不知道这些词代表什么,转写很容易出现同音字或拆词错误。

看起来是两个问题:术语转不准;就算转准了,也没人看得懂。

其实是同一个问题:缺上下文。术语转不准,是因为模型的词典里没有你公司的词;看不懂,是因为纪要里没有这些人是谁、属于哪个项目、上次讨论了什么决定、谁负责什么事。

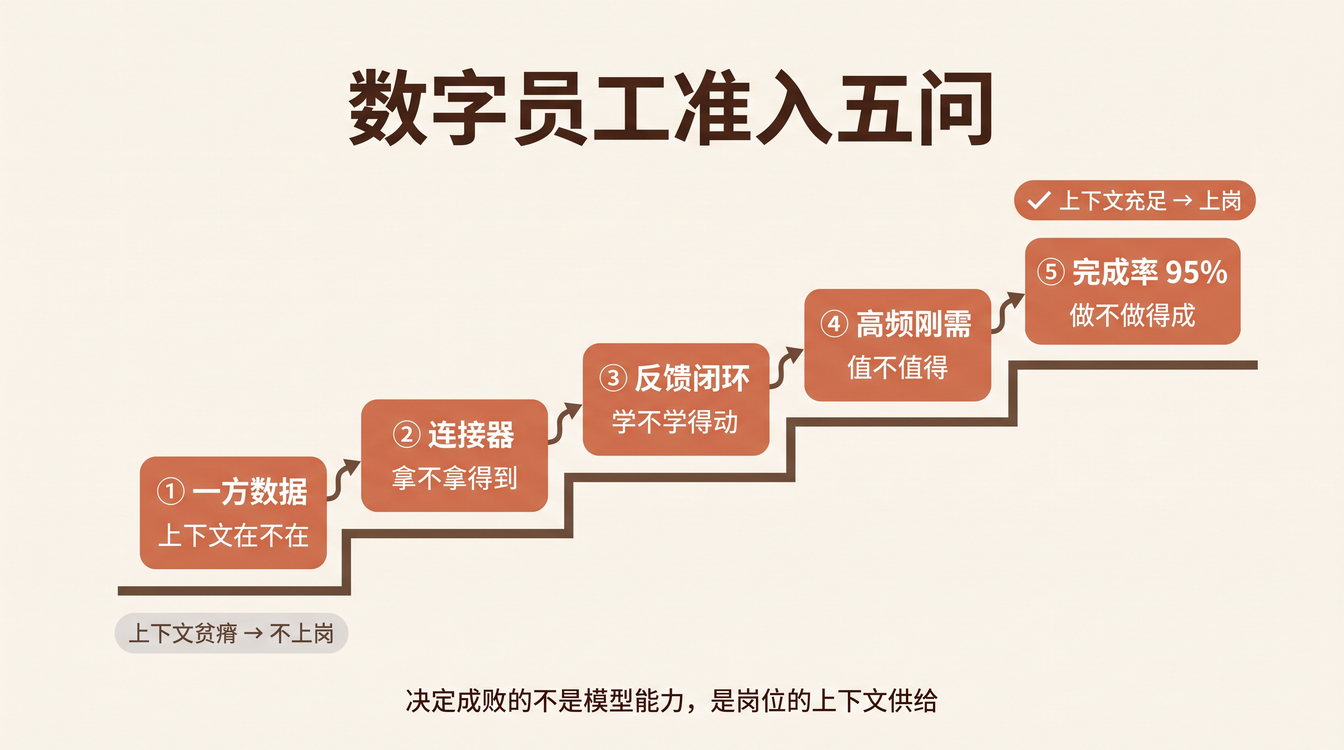
这次经历让我们得到一个后来反复验证的判断: 数字员工不是任何岗位都能做,只有「上下文充分」的岗位才能做好。

判断一个岗位是否适合数字员工,只需要看五件事。

Not Every Job Can Sustain a Digital Employee

[Read More]

数字员工背后的 Agent,是五层基础设施的叠加

The Agent Behind a Digital Employee Is a Five-Layer Stack

上周整理数字员工的术语,有人在讨论里问了一个问题:

「数字员工背后的 Agent,具体实现上是一套什么东西?」

这个问题问得好。市面上大多数回答是这样的:一个模型加一段 Prompt,接一个知识库,套一个对话框。听起来也没错——demo 确实就是这么做出来的。

但 demo 和员工是两回事。我们做会议纪要数字员工的时候,第一版正是「模型 + Prompt + 转写」,能跑,但没人敢用:纪要里全是「小王跟进一下」,没人知道是哪个小王;待办派错了人,也没有任何机制能发现。

后来它变成一个真正能干活的数字员工,靠的不是换更强的模型——模型一直没换。靠的是在模型外面,一层一层搭起来的东西。

[Read More]

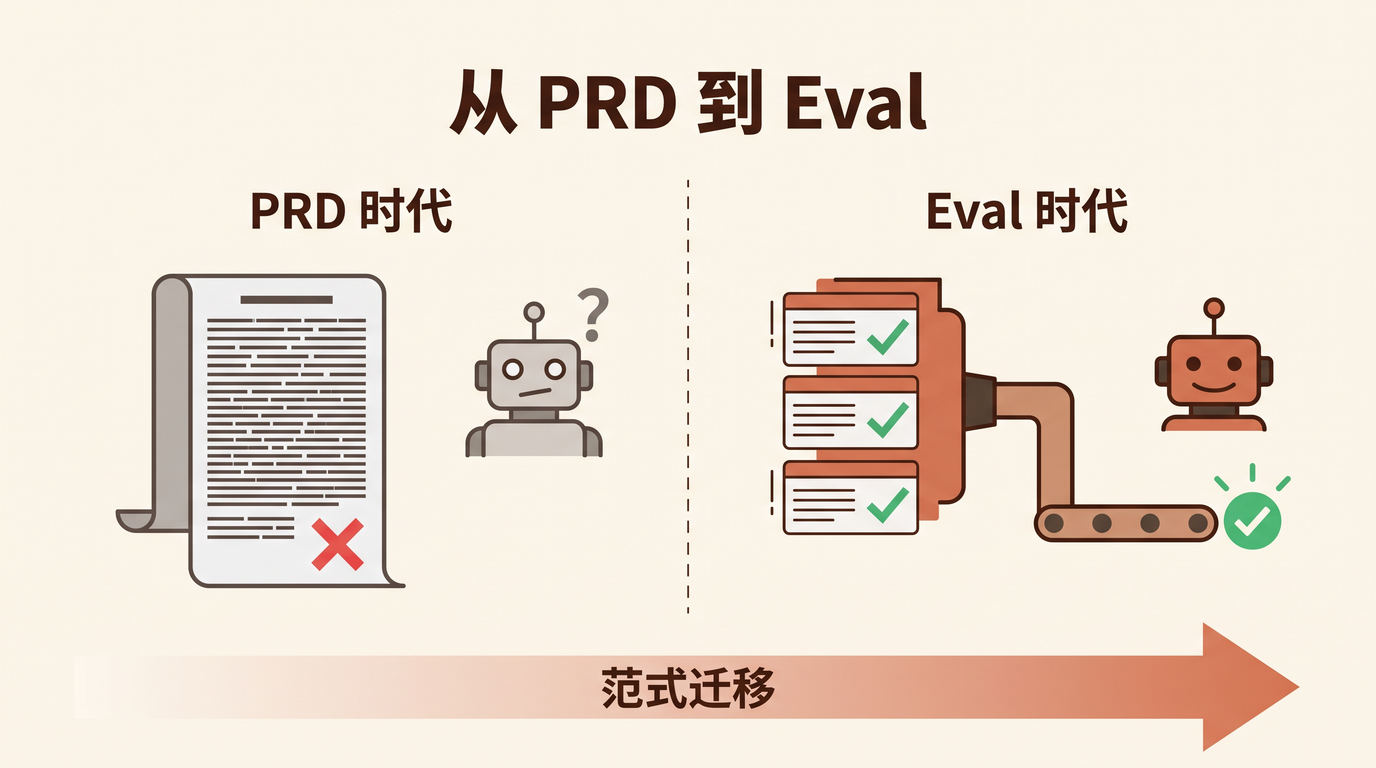
Evals 是新的 PRD

Evals Are the New PRD

上个月,我们团队一位产品经理花了两周写了一份 40 页的 PRD,描述一个智能审批 Agent 的需求。用户故事、流程图、异常分支、验收标准,写得滴水不漏。

她把 PRD 丢给 Coding Agent,说:「按这个做。」

三天后 Agent 交付了。代码能跑,测试通过,接口对齐。但她试了五分钟就皱眉:「这不是我要的东西。」

哪里不对?她说不清。审批流程是对的,权限校验是对的,消息通知是对的。但 Agent 处理「领导已读不回超过 48 小时」的策略,不是她脑子里想的那个。PRD 里写的是「超时后自动提醒」,Agent 就老老实实给所有超时审批发了一轮提醒——包括那些「领导出差没看手机」的非紧急件。她真正想要的是「先判断这条审批是否紧急,紧急的才提醒,不紧急的等下次汇总」。

这个判断,她没写进 PRD。因为她觉得这是「常识」。

Agent 没有常识。Agent 只有你给它的判据。

Evals Are the New PRD

[Read More]

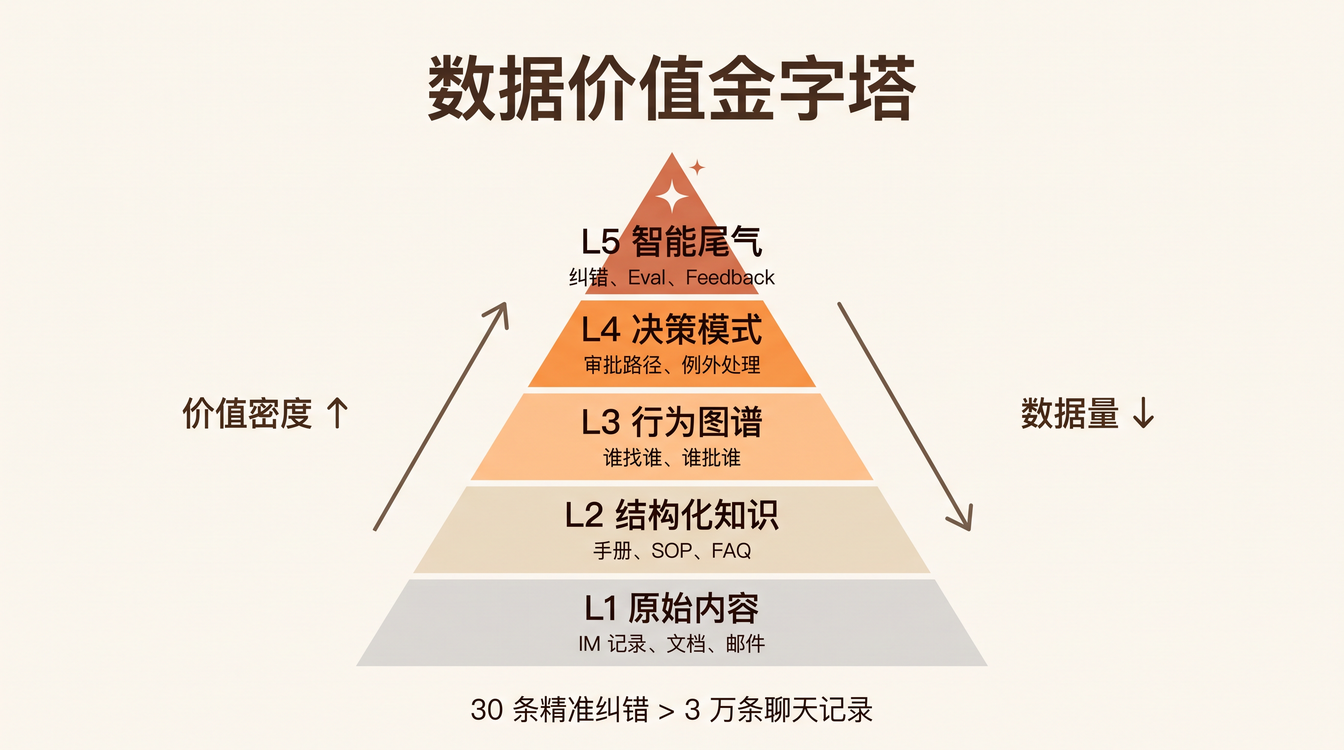
企业最有价值的 AI 训练数据,不是文档内容,是隐性知识

Intelligence Exhaust: The Data Asset Enterprises Must Protect

太平洋汽车的内容被豆包、千问和 DeepSeek 引用之后,合计触达了 1237 万用户。

这个数字是太平洋汽车 App 自有流量的 113.8 倍。

一百一十三倍。超过一百倍的用户通过 AI 平台「消费」了太平洋汽车的内容——他们在豆包的聊天窗口里问了一个关于买车的问题,豆包引用太平洋汽车的评测给出了答案,用户满意地关掉了对话。

然后呢? 太平洋汽车什么都没得到。 没有访问,没有注册,没有广告展示,没有用户画像。内容被吃干抹净,连渣都没剩。

这个故事来自极客公园上周的一篇报道,讲的是 AI 时代互联网流量的大崩塌。但让我想了很久的不是流量问题——而是一个更底层的问题:

如果内容本身不是最有价值的资产,那什么才是?

Intelligence Exhaust: The Data Asset Enterprises Must Protect

[Read More]