AI Agent 定时任务的自动优化

Telemetry-driven cron optimization for AI agent runtimes

上个月,我发现一个跑了 3 周的定时任务每天都在用 Claude Sonnet 4 做一件极其简单的事——搜索两条关键词、整理成表格、发给我。每次消耗约 8000 token,成本 $0.12。换成 GPT-4o-mini,同样的任务 2000 token 就够,成本 $0.003。

3 周 × 每天 $0.12 = $2.52。换成 mini 只要 $0.06。

这不是模型的问题,也不是调度器的问题——是 调度器和模型选择之间缺了一层。你的 cron 系统知道什么时候该跑这个任务,但完全不知道该用什么模型、多少推理深度来跑。
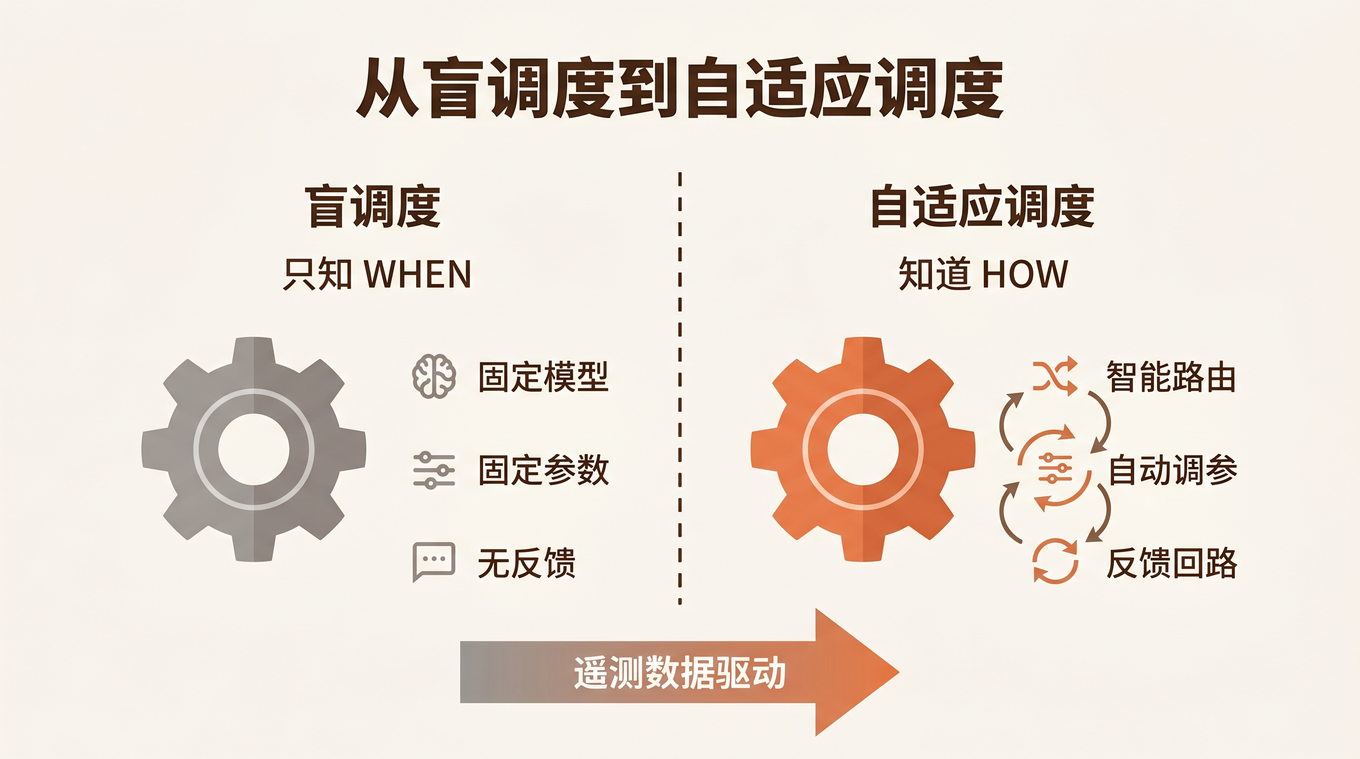
从盲调度到自适应调度

[Read More]

你不需要会编程:对话即编程,一个会进化的工作流系统

How Non-Technical Users Build Evolving Programmatic Systems Through Conversation

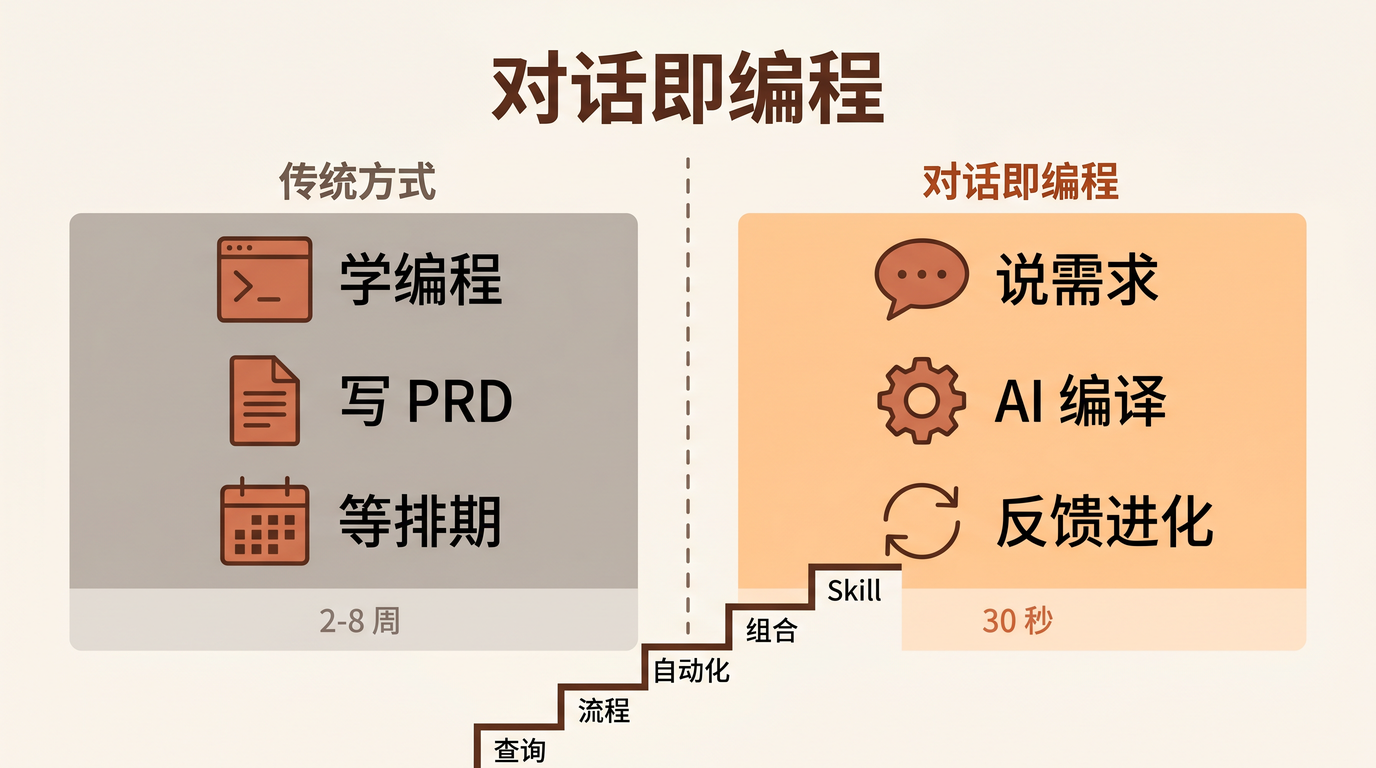
上周五下午 4 点,一个管着 30 人销售团队的区域总监在钉钉里对悟空说了一句话:

「帮我把本周所有客户的跟进记录整理成表格,标记哪些超过 3 天没回访的,然后给对应的销售发个提醒。」

她没有写一行代码。她甚至不知道什么是 API。但 30 秒后,一张 AI 表格建好了,12 条超时记录标红了,12 条 DING 消息已经发到了对应销售的手机上。

这不是 demo,是她每天的工作方式。

对话即编程:传统方式 vs 对话即编程

[Read More]

手冲咖啡.SKILL

Pour-Over Coffee as Agent Skill

每一杯手冲咖啡,都是一次 Skill 的执行。

研磨度、水温、注水手法、断水时机——这些看似随意的参数,在专业咖啡师手里是一套精确的、可重复的、经过成百上千次迭代的程序。AI Agent 的 Skill 也一样:把「凭感觉做事」变成「按配方执行」,把个人经验沉淀为组织能力。

这篇文章本身就是一份 Skill。它的格式遵循 SKILL.md 规范,它的内容是手冲咖啡与 AI Skill 设计之间的深层同构。

Brew Notes — 手冲咖啡 Skill 方法论全景图

[Read More]

AI 时代的个人知识管理最佳实践:从笔记仓库到认知操作系统

Best Practices for Personal Knowledge Management in the AI Era: From Note Repositories to Cognitive Operating Systems

AI 时代,个人知识管理(PKM)正在经历一场根本性的范式转移。

最大的变化不是「记笔记的方式变了」,而是:

你需要开始经营一套「可被 AI 理解、调用、推理、持续学习」的个人上下文系统。

过去的知识管理是为「人脑回忆」设计的——核心动作是分类、收藏、归档。 AI 时代,知识管理是为「人 + AI 协同工作」设计的——核心变成了上下文(Context)、可计算(Computable)、可演化(Evolving)、可调用(Actionable)。

很多人还停留在 Obsidian 堆 Markdown、Notion 堆页面、收藏 5000 篇文章然后让 AI 帮忙总结的阶段。但真正有价值的,是一整套 AI 原生的知识管理体系。

这篇文章从工程视角出发,拆解 AI 时代个人知识管理的核心目标、架构设计和五项可落地的最佳实践。

[Read More]

悟空技巧十五:从「记录系统」到「经营系统」,企业 AI Agent 的终极形态

Wukong Tip #15: From Systems of Record to Systems of Operation — The Ultimate Form of Enterprise AI Agents

过去二十年,企业软件的核心使命是**「记录」**。

ERP 记录财务流水,CRM 记录客户关系,OA 记录审批流程,HR 系统记录考勤和绩效。这些系统回答了同一个问题:「发生了什么?」

但它们从来不回答另一个更重要的问题:「接下来该做什么?」

决策依然靠人。老板看报表、开会、拍脑袋。系统只是「记录员」,不是「经营者」。

AI Agent 的出现正在改变这个范式。当 AI 能够 7×24 小时持续推理、自动执行业务动作、并对经营结果负责时,企业购买的不再是「软件许可证」,而是**「持续在线的经营能力」**。

这就是「悟空云端」的核心定位:企业经营型 AI Agent 平台(Business Operating Agent)。

在前面的十四篇文章中,我们从 需求澄清、多 Agent 编排、可观测性 到 成熟度模型,构建了 AI 协作的完整技术体系。

今天,我们推出系列的第十五篇:从技术视角解读「经营型 Agent」的架构设计、行业落地路径和核心壁垒,探讨企业 AI Agent 的终极形态。

[Read More]

通用桌面 Agent 新用户激活:首次任务推荐引擎设计

Designing High-Conversion First Task Recommendations for Desktop AI Agents

通用桌面 Agent(Desktop AI Agent)的推广面临一个经典的增长难题:用户安装后,面对一个"什么都能做"的空白界面,往往不知道该让它做什么,最终流失。

本文从工程实践角度,探讨如何基于用户画像(行业、部门、层级、企业规模、城市、常用应用、工作任务、技能水平)构建首次任务推荐引擎,最大化新用户的点击转化率和激活率。

[Read More]

AI Agent使用的复利效应:为什么第二步的「无用功」最值得投入

The Compound Interest of Agent Adoption: Why Redundant Work Pays Off Exponentially

HashiCorp 的 Mitchell 把自己的 AI 使用历程分成六个阶段。他不是那种用了就觉得好的人,每个阶段都带着怀疑和验证。六步走完后,他得出了一个反直觉的结论:最痛苦、看起来最「无用」的第二步,恰恰是后续一切复利的起点。

大多数人从第一步直接跳到第四步 —— 觉得 AI 好用就开始委托任务。Mitchell 却在第二步花了大量时间做冗余工作:已经手动完成的事,再让 Agent 做一遍。原文说「I literally did the work twice」。目的不是省时间,是建立对 Agent 能力边界的真实认知。

正是这个阶段的「无用功」,让后续每一步都产生了指数级的复利效应。

[Read More]

基础设施比模型更重要:Stripe Minions 给 AI Agent 落地的启示

Why Engineering Infrastructure Matters More Than Model Choice for AI Agents

昨晚在电子书上读到一段关于 Stripe Minions 的文字,让我停下来想了很久。

不是因为它用了什么惊艳的模型,而是因为它揭示了一个被大多数人忽略的事实:

Minions 能 work 的首要原因跟 AI 模型本身几乎无关,而是 Stripe 在 LLM 出现之前就为人类工程师建设了多年的基础设施。

完整的代码树、成熟的构建系统、全面的测试覆盖、标准化的开发环境——这些不是为 AI 准备的,是十多年来为人类工程师准备的。AI Agent 到来时,直接继承了这套基础设施。

好的人类工程基础设施,就是好的 AI 工程基础设施。

[Read More]

企业级 Agent 落地:要抓好左右手

The Two-Hand Framework for Enterprise AI Agents

上周和一个做企业数字化的朋友吃饭。他公司去年花了两百多万,引入了一套"AI Agent 平台"。

销售演示的时候很惊艳:对着对话框说一句话,系统就能生成报表、审批流程、甚至写 SQL 查数据。

上线三个月后,他告诉我:

“员工用了两周就放弃了。现在那个系统成了公司最贵的摆设。”

我问他:系统出 Bug 了?

他说:不是。是系统不会变聪明。

第一个月,Agent 回答问题的准确率大概 70%。第二个月还是 70%。第三个月,员工发现问同样的问题,得到的答案一模一样——系统完全没有从实际使用中学到任何东西。

“它就是个会说话的自动化脚本。”

这句话戳中了一个很多人不愿承认的事实:

今天市面上 90% 的"企业 Agent",本质上只是给 LLM 套了个聊天框。

[Read More]

中国 SaaS 厂商的护城河应该怎么建

Building Durable Moats for China SaaS in the Agent Era

上周和一位做 HR SaaS 的创始人吃饭。他抛出一个困扰了很久的问题:

“我们的 AI 简历解析准确率比竞品高 8%,但客户续约率还是在掉。竞品三个月就追平了准确率,价格还低 20%。技术优势在中国到底能维持多久?”

我给的回答很直接:6 到 12 个月。 然后就没有了。

这不是悲观,而是现实。中国企服市场的迭代速度让任何纯技术壁垒都迅速商品化。如果你的护城河是"我们的模型更准"“我们的算法更快”,那这条河很快就会干涸。

这篇文章,我想系统回答一个问题:在中国做 SaaS,到底什么才是真正的护城河?

[Read More]