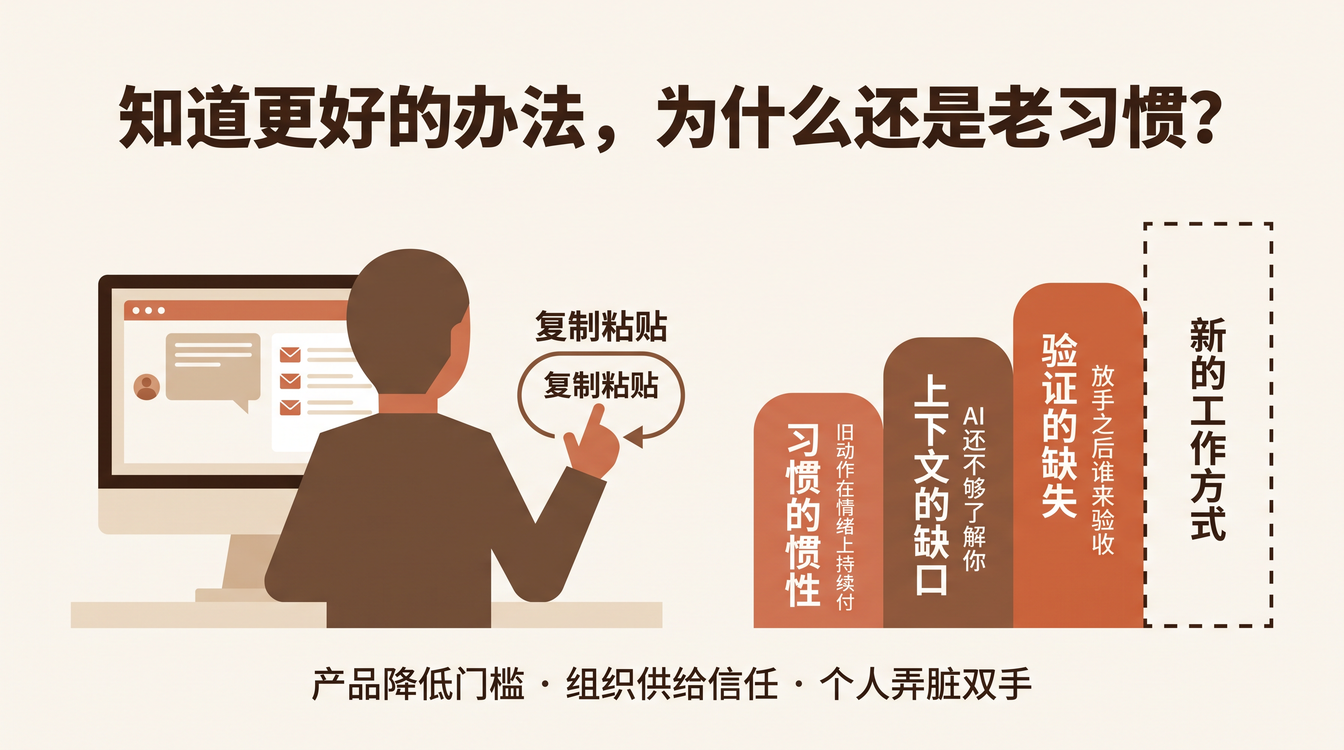
连奥特曼都改不掉复制粘贴的习惯

Even Sam Altman Cannot Break His Copy-Paste Habit

OpenAI 的创始人山姆·奥尔特曼,最近在一次专访里说了一段让我停下来的话:

现在有了 Codex,明明可以换一种办法工作,我却还在沿用以前的习惯。我不应该到处乱点,在不同的聊天软件之间复制粘贴,漫无目的地浏览邮件……然而,我的脑海里却根深蒂固地认为,做这些事情就是工作,就是高效。

注意这段话的主语。这不是一个对 AI 一知半解的传统行业老板,也不是一个拒绝新技术的保守派——这是做出 ChatGPT 和 Codex 的人,是这个世界上离 AI 最近的人。

他知道更好的办法。他手里就有那个更好的办法。他还是改不掉。

如果连他都这样,那「AI 会自然改变我们的工作方式」这个假设,就有必要重新审一遍了。
Even Sam Altman Cannot Break His Copy-Paste Habit

[Read More]

五个问题,判断一个岗位能不能交给数字员工

Not Every Job Can Sustain a Digital Employee

上周有人请我整理一套数字员工的术语,用途是整理会议纪要。

整理的时候我意识到一件事:会议纪要看起来是最容易交给 AI 的岗位。语音识别模型足够强,转写免费,人人会用。按常理,它应该是数字员工最先上岗的岗位。

但我们真动手做的时候,发现不是这样。

第一版会议纪要机器人,把会议里的每一句话都转写出来了。问题是,没人看得懂:

「关于上次说的那件事,就按讨论的办。」——哪件事?怎么讨论的?

「这个意见我同意。」——谁的意见?

「后续小王跟进一下。」——哪个小王?

而且,转写本身也不总是干净的。真正容易出错的,不是通用技术术语,而是企业自己的语言——项目代号、产品名、客户简称、组织缩写、内部黑话。比如「北极星二期」「天穹计划」「A17 客户」「P0 升级」「DWS」「飞鹰版本」,通用模型根本不知道这些词代表什么,转写很容易出现同音字或拆词错误。

看起来是两个问题:术语转不准;就算转准了,也没人看得懂。

其实是同一个问题:缺上下文。术语转不准,是因为模型的词典里没有你公司的词;看不懂,是因为纪要里没有这些人是谁、属于哪个项目、上次讨论了什么决定、谁负责什么事。

这次经历让我们得到一个后来反复验证的判断: 数字员工不是任何岗位都能做,只有「上下文充分」的岗位才能做好。

判断一个岗位是否适合数字员工,只需要看五件事。

Not Every Job Can Sustain a Digital Employee

[Read More]