Anthropic 昨天发布 Opus 5.5,标题新闻是降价:同样的工作负载,成本比上一代低约 40%。
但这篇发布博客里最值钱的不是降价,是一组没上标题的数据。他们拉了 2026 年 3 月到 9 月 Claude Code 的聚合账单,发现每个请求的 输入与输出 token 之比,从 189:1 涨到了 324:1——六个月内,每个请求的上下文膨胀了 2.6 倍。
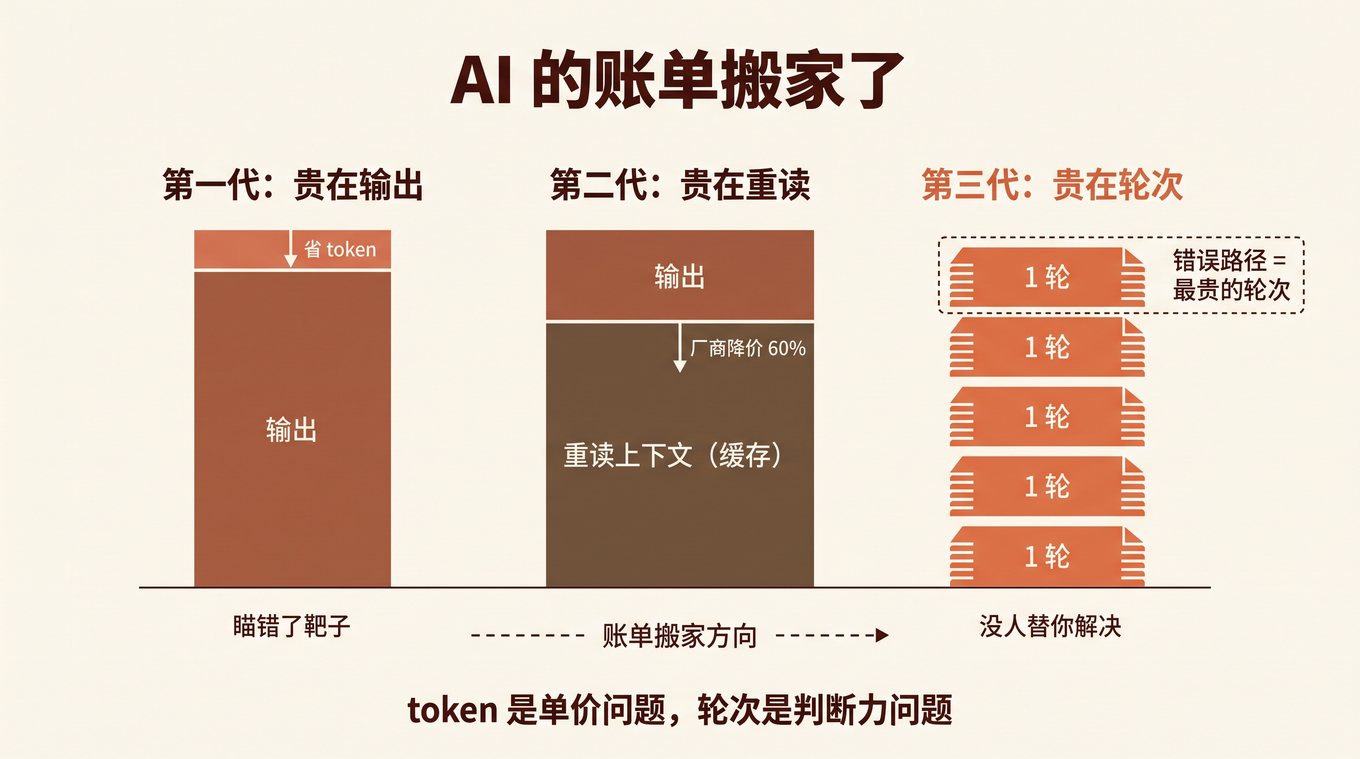
翻译一下:你的 AI 账单,早就不是「写」出来的,是「读」出来的。 输出只占 token 总量的千分之三;就算算上输出单价通常是输入的三五倍,砍掉一半输出,账单也就省下不到一个百分点。生成是零头,重读上下文才是大头。
而且账单还在搬。博客里引用开发者 Addy 的一句话,我认为是全文最重要的一句:
减少一个轮次,比一个缓存 token 还要更省成本。
token 之后是缓存,缓存之后是轮次。今天把这条搬家路线讲清楚——因为它直接决定你该在哪里省钱、在哪里花钱。