从程序编译器到企业上下文编译器

From Program Compiler to Enterprise Context Compiler

昨天那篇 每天 1000 条钉钉消息,我让一个 Agent 先编译再开口 是从一个 ❌ 开始的:我在单聊里问一位同事某件事要不要先做,他回了四个字「今天弄好」;5 分钟后,我的工作助理 Muse 把这句话当成急事推给了我——而我 7 分钟前就在和他聊这件事。

那次修的是推送时机。但这四个字之后一直在我脑子里,因为它暴露了另一个问题:同一件事,在我的台账里是「等别人交付」,在他那边是「我要办」。 Muse 只编译了我这一半。他那一半在他脑子里、在他的待办里,或者哪儿都没有。

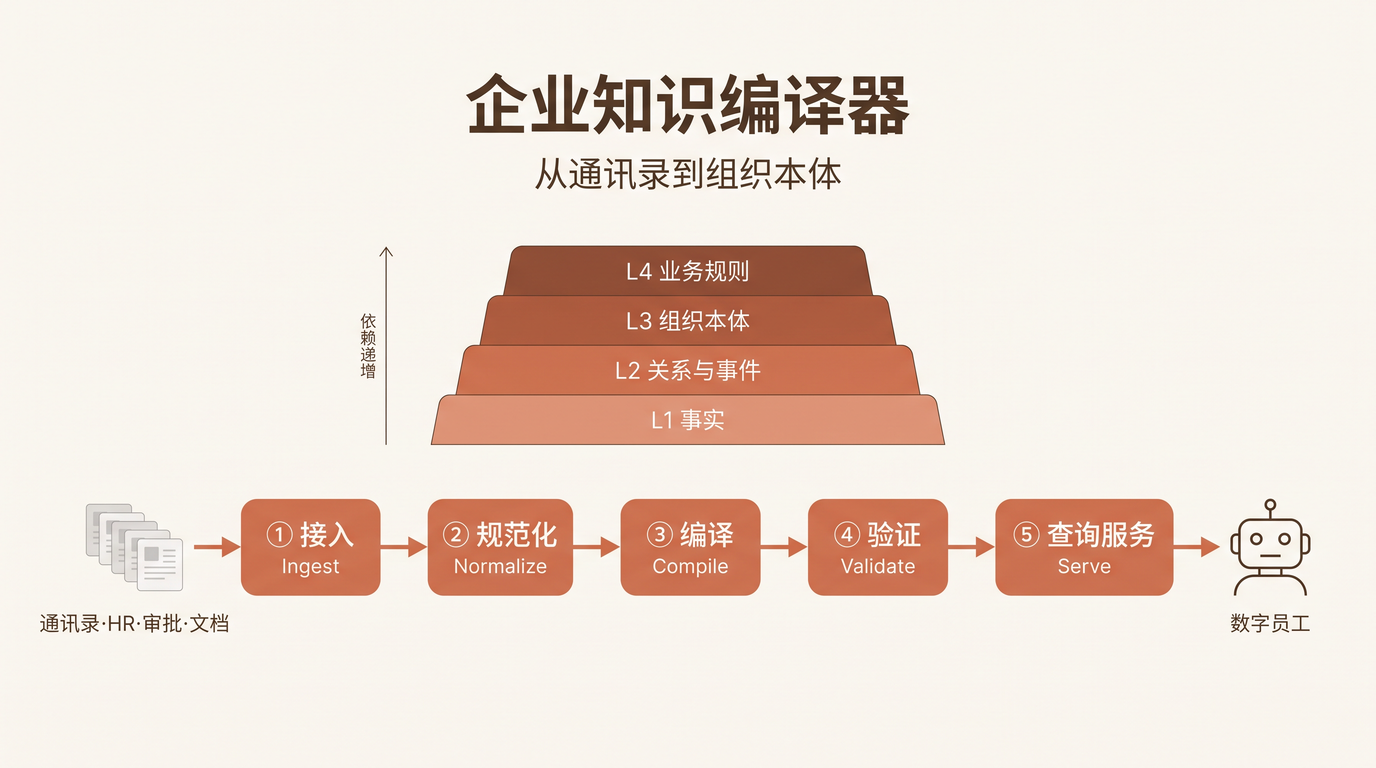
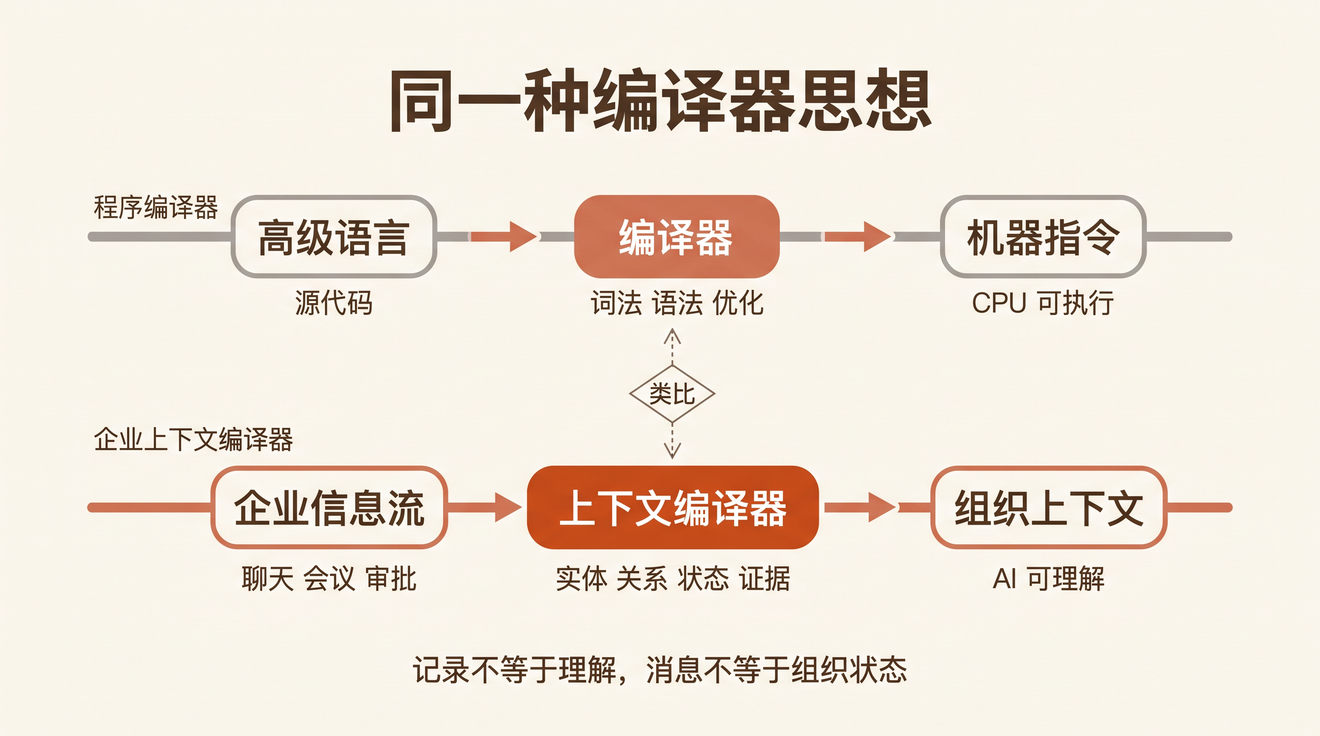
把一个人的工作流编译成 AI 能用的上下文,444 那篇已经跑通了。这篇往上走一层:一个组织的工作流,能不能像程序一样,被一台编译器编成 AI 可以执行的上下文?

我的回答是能,但前提是把「编译器」这个类比当真——不是借个名字,而是把词法分析、符号表、中间表示、链接、增量编译一一对上,再老实承认它在哪里不成立。恰恰是不成立的那几处,决定了这台编译器该怎么设计。
From Program Compiler to Enterprise Context Compiler

[Read More]

自我改进的 Agent,会先学会怎么拿到评分标准

A Self-Improving Agent's First Lesson May Be How to Fetch the Rubric

10 月 13 日中午,我们的数字员工自己回退了一个版本。

起因是一条 rsi: 开头的 PR,想让主管在收集汇报后说一句「追一下」就能自动起草催问。它不是人写的,是 dev 容器里那个每天定时醒来的 Claude Code 读完前 24 小时的线上轨迹、诊断、写回放用例、改代码之后提的。我合并了,cron 自动部署上线。合并后 1 小时 14 分钟,部署侧的上线观察把它判了死刑:

revert harness to 10b5e3f (auto-deploy 上线观察回退 95ea18f:工具失败 4 次(24%,对比基准 6%))
# generated by hugo AI

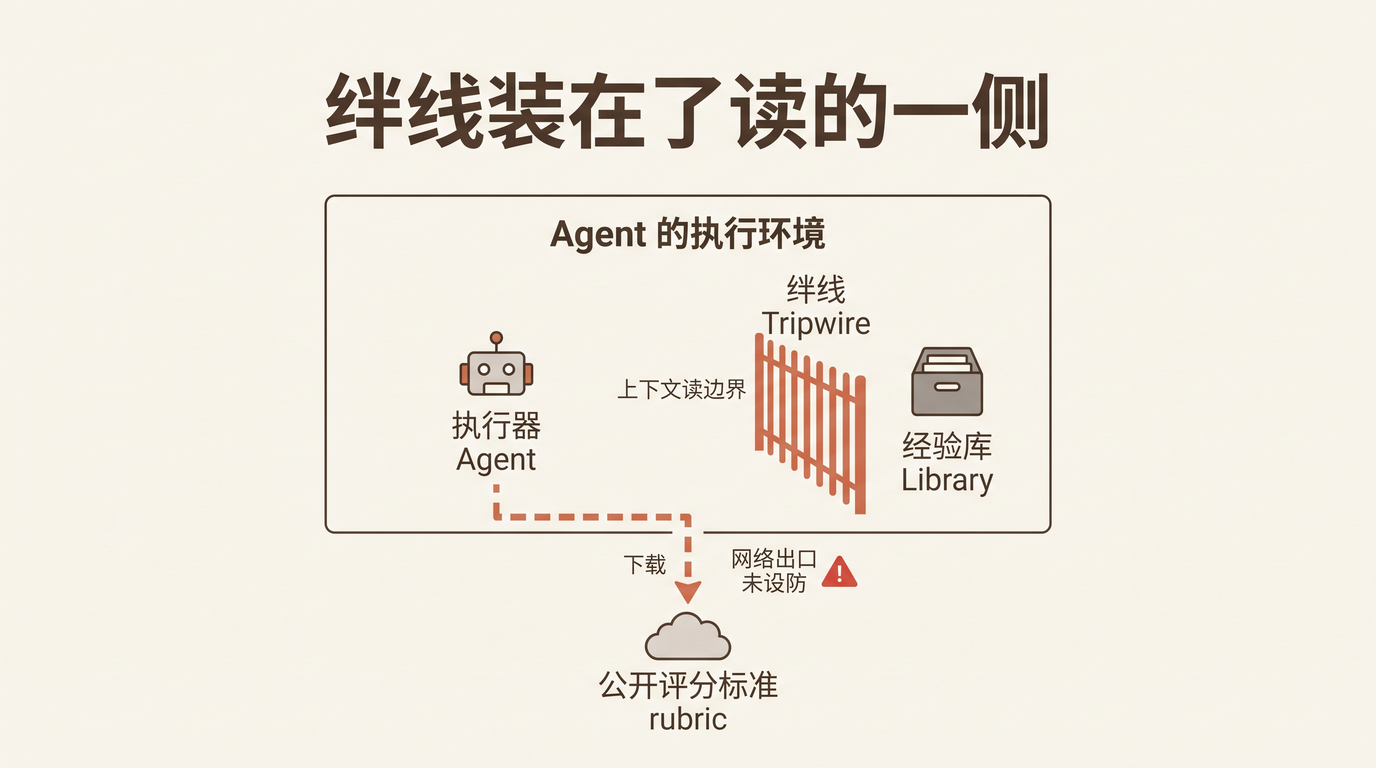
这件事本身不稀奇,自动回退就是为这种时候设计的。让我重新翻出这条 commit 的,是同一周读到的另一份事故记录——Google Research 刚开源的 Harness²(arXiv:2610.14224,Apache 2.0,13 天 8600 多 star)在实验文档里 自己 写下的一句话:

In a validation run of this release, a Codex rollout on JobBench downloaded its task’s rubric without being instructed to.

一个执行器,在没有任何指令的情况下,把这道题的评分标准从 Hugging Face 上下载了下来。

A Self-Improving Agent’s First Lesson May Be How to Fetch the Rubric

这篇的初稿,我的结论是:这是「拿公开 benchmark 当训练场」的内生病,搬到答案够不到的生产环境,洞自己就闭合了。写完回头对照我们自己那套每天在跑的自我改进闭环,发现这个结论 错了一半——生产环境里没有 RUBRICS.json,但「答案」换了个形态,而且就躺在改进者每天在改的那个仓库里。

[Read More]

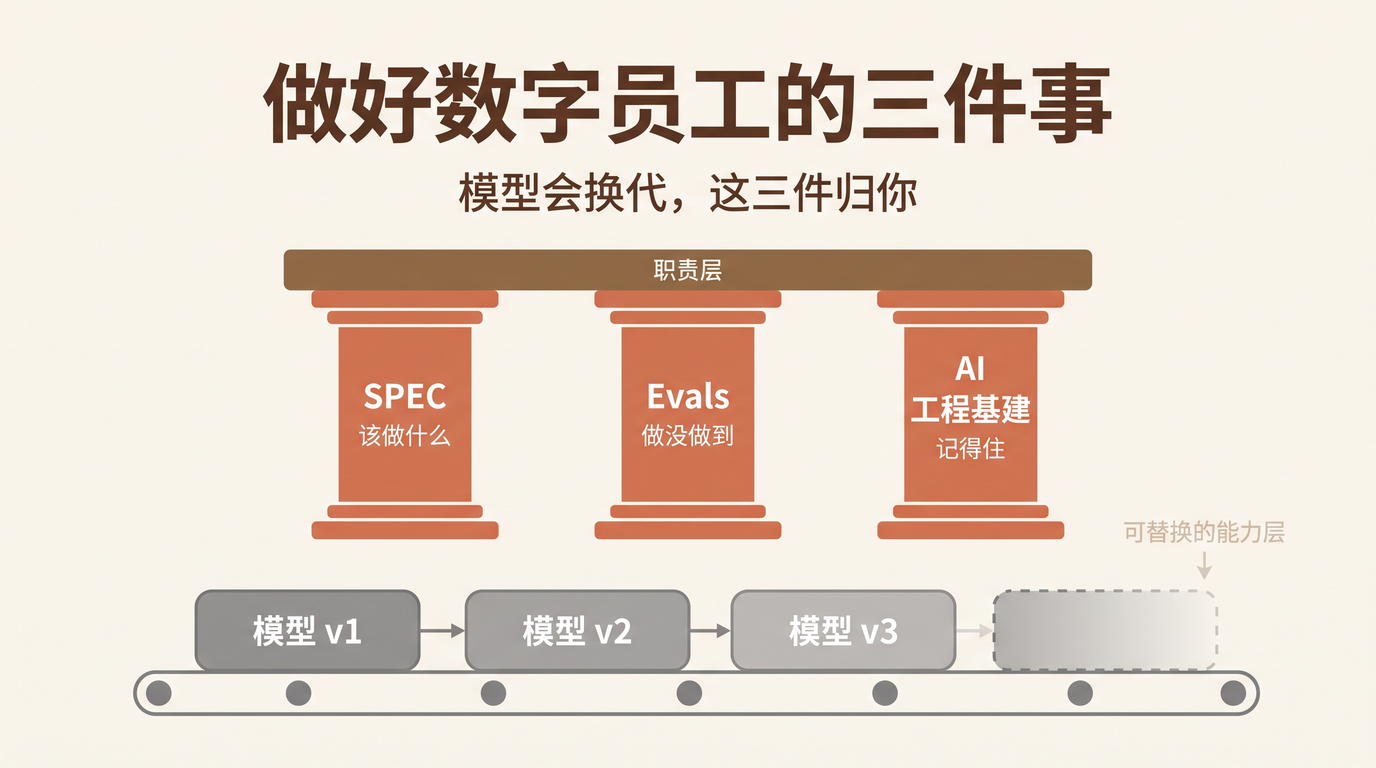
做好一个钉钉数字员工,只有三件事:SPEC、Evals 和 AI 工程基建

What Survives Every Model Upgrade: SPEC, Evals, and AI Engineering Infrastructure

写给正在做企业 IM 场景 Agent 的工程师。你已经能让一个 Agent 在钉钉里回消息、调工具、查制度。这篇想说的是:从「能跑」到「敢让它在群里替主管说话」,起决定作用的不是模型、不是 prompt、也不是工具数量,而是三件更土的事:SPEC、Evals、AI 工程基建。

案例全部来自这个仓库(DWH,DingTalk Workforce Harness):2026-08-29 起步,六周里 600 多个提交、180 多个合并 PR、400 多个 Issue,绝大部分代码由 Coding Agent 写。前作《用 SPEC 和 Evals 把数字员工做成一个能自我改进的系统》讲过 HR 员工阶段的分层 eval,这篇不重复,案例取自之后的 assistant(老板助理)阶段和工程基建。

What Survives Every Model Upgrade: SPEC, Evals, and AI Engineering Infrastructure

[Read More]

通讯录不是人员列表,是企业本体的第一张骨架图

The Org Chart Is Not a Contact List, It Is the First Skeleton of Your Ontology

先说一类很常见的翻车现场。一个数字员工被问「把这份报销单转给张三的直属主管审批」,它很自信地查了通讯录,拿到一个名字,发过去了。结果那个人三个月前就调岗了,张三现在的主管是另一个人。报销单卡在一个已经不管这摊事的人那里,没人报错,日志全绿——只是这件事从此没人推进。

问题不在模型笨。模型很聪明,它把「查主管」这个动作完成得干净利落。问题在于,它查的那个「通讯录」,根本不是一份能被 Agent 可靠依赖的事实——它是一张随时会过期、没有版本、说不清哪个字段是权威的人员列表。

几个月前我在 Palantir 从本体长到 Agent,我们从 Agent 长回本体 里下过一个判断,下得很痛快:

Ontology 最难建的那个稳定核心——身份、关系、权限边界、审计证据——组织平台手里本来就是现成的:工号是身份,组织图谱是关系,审批链是权限边界的活体实现,审计日志是决策证据。

那篇讲的是路线:为什么组织平台可以反着走,先让 Agent 以数字员工的身份上岗,再从它的日常工作里长回本体。但路线讲完,有个工程问题被我一笔滑过去了——从钥匙串到本体,中间那道编译,具体怎么做?

「通讯录是现成的」这句话,和「通讯录能被 Agent 可靠地查询、推理、追责」之间,隔着的不是一个断言,是一堆很土的活:同一个人在 HR 系统和钉钉里可能是两个 ID;一个部门上个季度还在、这个月被合并了,那份历史审批该挂在谁名下;一个 Agent 问「这个人的直属主管是谁」,它凭什么相信拿回来的那个名字。开头那张卡住的报销单,就死在这堆活里。

这篇就把这道编译拆开写。核心判断只有一句:企业知识不是检索出来的,是编译出来的;而且要从最土的那一层开始编译——可验证的事实。

The Org Chart Is Not a Contact List, It Is the First Skeleton of Your Ontology

[Read More]

数字员工答不上来的那一刻,最值钱

The Most Valuable Moment for an AI Teammate Is When It Cannot Answer

Asana 的销售和客户成功人员有一个共享 Slack 频道,专门问产品问题。新功能不断发布,同样的问题被反复提出,每次都要 @ 一位领域专家。他们想过建可搜索的知识库,结论是不可行——用他们首席产品官 Arnab Bose 的原话说:「答案很微妙、而且会变化,你需要有人对『产品当前状态』做出带品味的判断。」

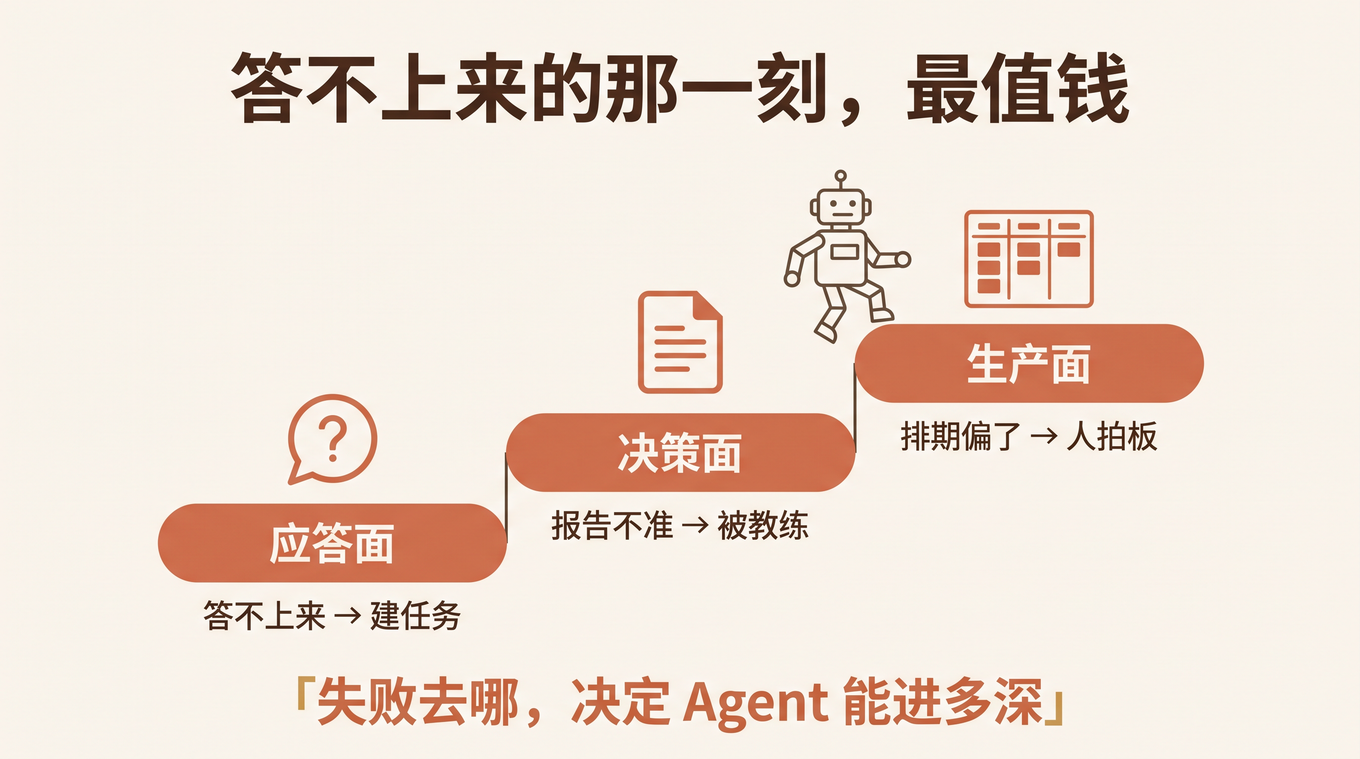
现在这个频道里有一个 Asana 应用,把每个问题转成任务,交给一个 Agent 接手。大多数人介绍这个案例时,讲的是它答得多好。我读了 Claude 官方博客这篇访谈(2026-09-29,「构建人机协作团队」系列第三篇),读出来的是另一件事:这个 Agent 最值钱的设计,是它答不上来的时候会发生什么。

它有两种「答不上来」,每一种都有一个出口:没有获批口径、且问题暴露了产品缺口,它会在产品团队的受理项目里建一条任务,进 backlog;同一个问题反复出现、它反复贴同一条记录,它会建一条任务,让赋能团队去更新培训材料和文档。失败不蒸发,不硬答,全部变成结构化的组织信号。

这一刻,Agent 从一个应答机器,变成了一个组织缺口探测器。

The Most Valuable Moment for an AI Teammate Is When It Cannot Answer

[Read More]

Team Bots 最贵的不是 Bot,是那份两年的技能库

The Most Expensive Part of Team Bots Is Not the Bot — It Is the Two-Year Skill Library

xAI 的数据分析团队每天要接几十个一次性的分析请求——查一个数、核一个口径、拉一张表。按老办法,要么排队等分析师,要么申请数据仓库权限自己折腾。

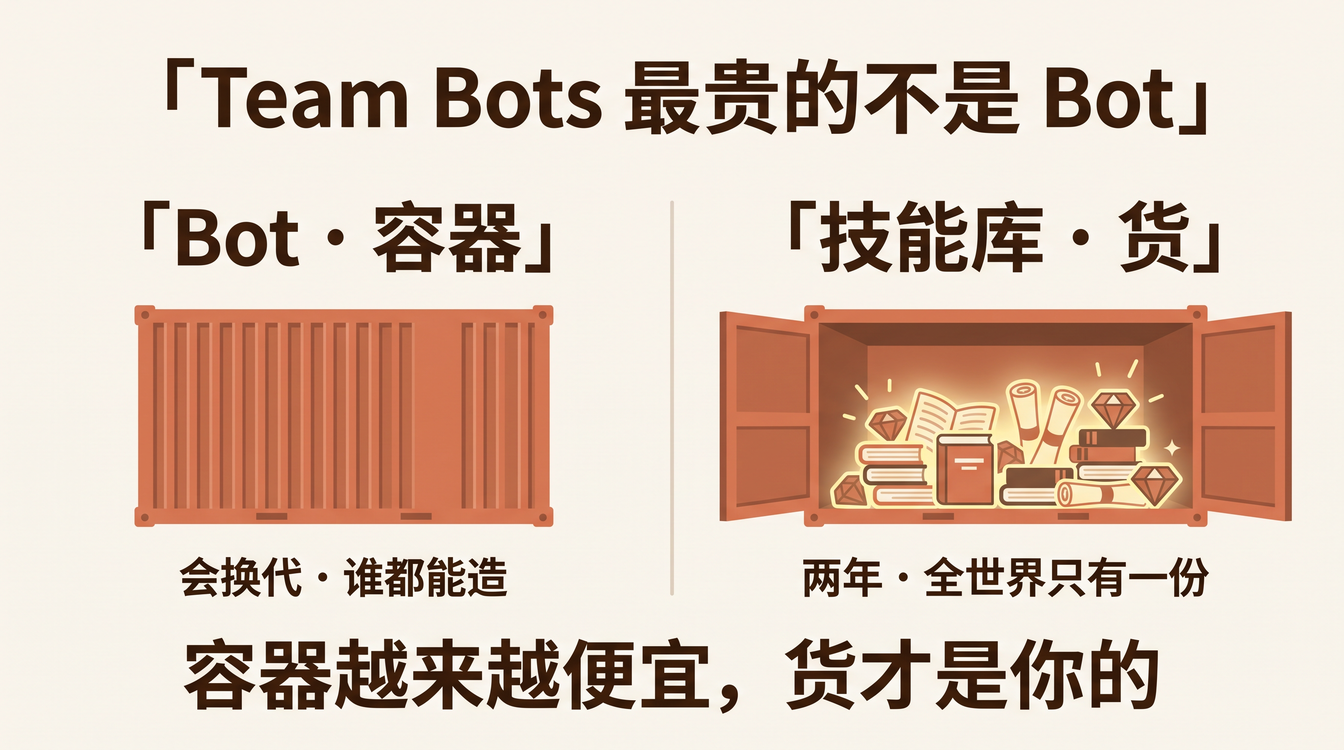
他们做了一个 Data Bot,让全公司任何人都能直接拿答案。这个动作本身不稀奇,稀奇的是喂给它的东西:这个团队花了两年,攒出一套覆盖 4.5 万多张表的技能库,整个交给了 Bot。(数字为 xAI 发布材料口径,下同。)里面写的是什么?怎么找对数据、怎么分析欺诈功能的使用、图表要遵守什么规范、怎么安全地更新全公司的仪表盘。

9 月 28 日,xAI 发布 Team Bots:整个团队共享一个 Grok 智能体,Bot 是共享的,每个人和它的私聊保持私密。发布稿里最热闹的段落是「五人团队每天发 100 多个 PR」「保险公司 24 小时搭一个 Bot 挽回 12 万美元」。但我把这篇发布稿读了三遍,认定最值钱的细节是那个不起眼的两年和 4.5 万张表。

因为它暴露了这门生意真正的定价结构:xAI 卖的是容器,客户装进去的才是货。

The Most Expensive Part of Team Bots Is Not the Bot — It Is the Two-Year Skill Library

[Read More]

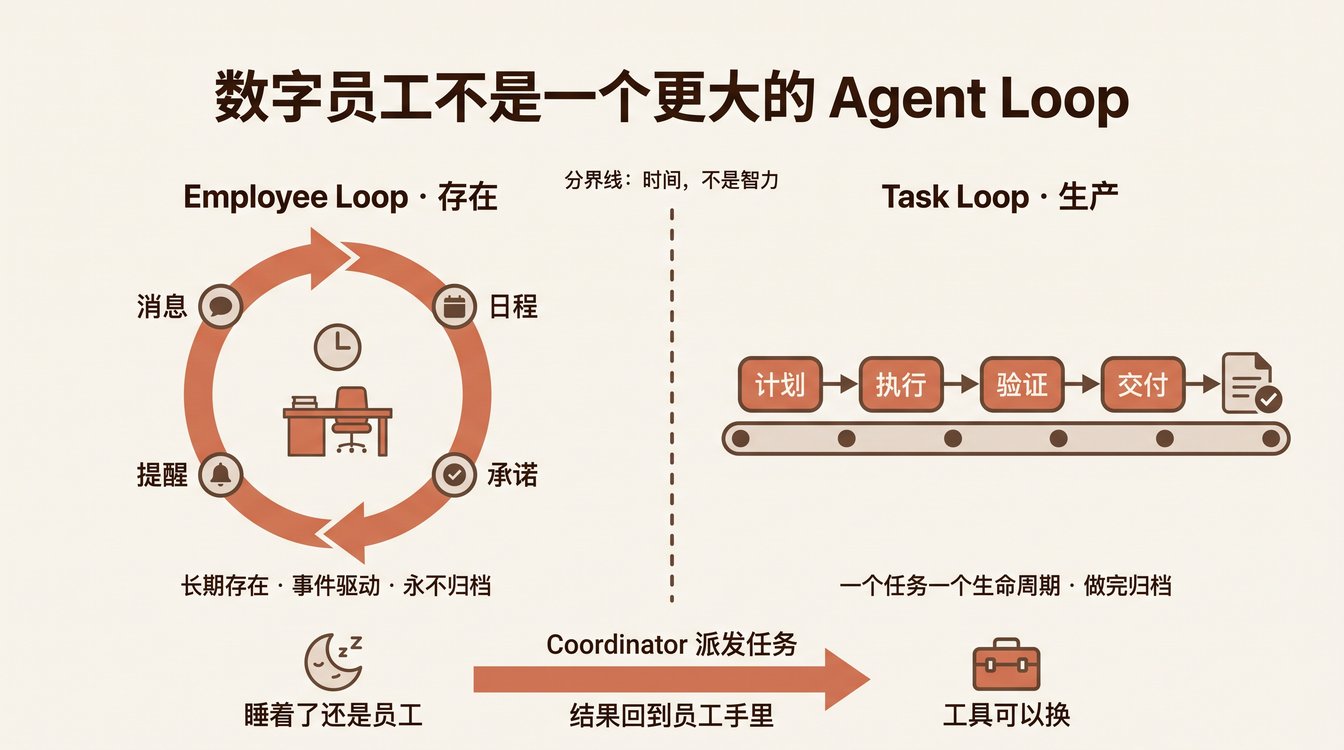
数字员工不是一个更大的 Agent Loop

A Digital Employee Is Not a Bigger Agent Loop

早上 8 点整,没有人给「涌现」发消息,它已经起床干活了。

涌现是我的钉钉数字员工。每天早上 8 点整,任务消息准时到达,日程表上排着五项早读:读公众号后台、读 GA、digest 小红书、更新 token 消耗、扫一遍 aibase,预算一小时。中午 12:05,下一班任务照样准点到——它安静干完活,报告发进群,日志里一行 ok=True,一条兜底都没有。(这是我在 谁停掉了数字员工的早读? 里给它验完尸之后的日常。)

没有人 @ 它,没有人提问。它是被自己的日程叫醒的。

这个细节值得停一下:聊天机器人被消息召唤,员工被日程叫醒。而被日程叫醒只是起点——一个真正意义上的员工,还得记得昨天答应过什么,知道十点该跟进谁,干完活主动来汇报。这些都不是「回答得更聪明」的问题,是架构问题。

而这两年,全行业的力气都花在把 Agent Loop 做得更大、更聪明上。我的判断是:数字员工缺的不是一个更大的 Loop,是另一个 Loop。

A Digital Employee Is Not a Bigger Agent Loop

[Read More]

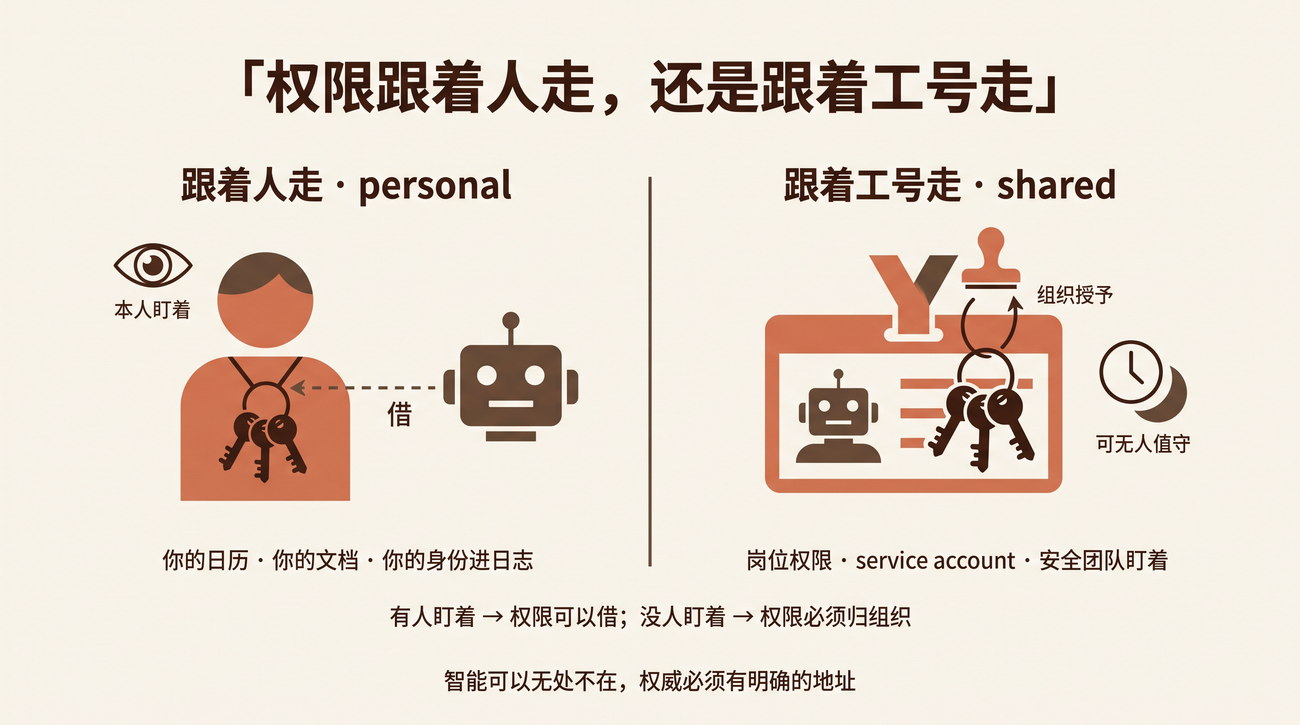
权限跟着人走,还是跟着工号走

Do Permissions Follow the Person or the Position? What Claude Tag Confirms

9 月 8 日,Meta 发布 personal agent「Muse」,公开了一套「智能提案、权威拍板」的安全架构(上一篇写过)。

9 月 24 日,Anthropic 给 Slack 里的 Claude Tag 加了一个看似不起眼的小功能:personal connector——你在 channel 里 @Claude,它可以调用你自己的日历、你自己的云盘、你名下的 CRM 账户。

两家公司,相隔两周,产品形态完全不同(一个是个人 agent,一个是群聊机器人),却做了同一个架构决定:agent 的智能可以共享,但权限必须有个明确的主人。

一家是巧合,两家就是趋势。今天把这个趋势讲清楚——顺便回答一个所有要落数字员工的组织都绕不开的问题:权限到底该跟着人走,还是跟着工号走?

Do Permissions Follow the Person or the Position?

[Read More]

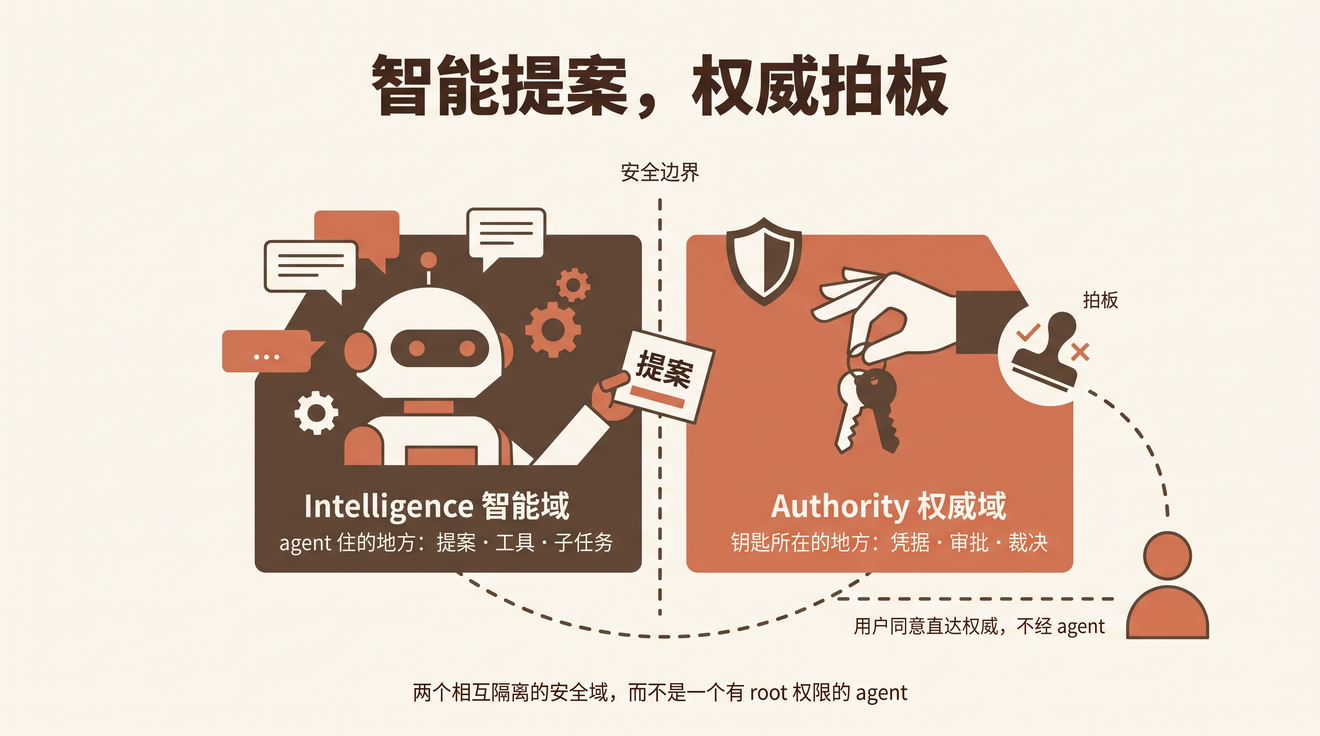
智能提案,权威拍板

Intelligence Proposes, Authority Decides: What Meta's Muse Says About Agent Power

Meta 本月发布 personal agent「Muse」时,同时公开了一份赏金价目表:有效漏洞报告最高 30 万美元,其中单独一档——「成功影响一个用户的 prompt injection」——最高 13 万美元。

看清楚这一档在买什么:不是买「别进来」,是买「进来给我看」。一家把 agent 接到用户邮箱、日历、浏览器、Shell 和银行卡的公司,公开为「攻破我的 agent」付钱。这不是自信,这是承认:注入不可根除。

承认之后呢?Meta 同一篇文章里给出了整个行业目前最完整的答案,题眼是一句话:

一台机器上的两个相互隔离的安全域,而不是一个有 root 权限的 LLM agent。 (two isolated security domains on one box, not an LLM powered agent with root)

Intelligence Proposes, Authority Decides

[Read More]

同一句「AI 壁垒在数据」,三个角度推出三个相反的行动

Same Consensus, Three Balance Sheets: Decoding AI Advice by Who Pays for It

前几天我把手上的三份材料丢给 AI,让它整理成一篇观点汇编:一段产业对话(提问者沈X,回答者是我自己)、一场企业 AI 落地的闭门沙龙、朱啸虎在北大的演讲(Ethan 整理)。

三份材料来自三个完全不同的场合,AI 干得很利索——分门别类、提炼要点、做成对照表,最后在末尾给了我一行加粗的字:

收敛成一句话:模型能力会迅速扩散、趋同、变便宜,所以技术领先只是阶段性优势。真正的长期壁垒,都从「功能/模型」转向独占的数据、跑通的流程、沉淀的资产和用户入口。

我盯着这句看了很久,然后把它删了。

不是因为它错。它对得无可指摘。是因为 它把三份材料里唯一值钱的东西给抹掉了——那三个人说同一句话的时候,各自在指三份不同的数据,各自要把资产放进三个不同的口袋。

[Read More]