从程序编译器到企业上下文编译器

From Program Compiler to Enterprise Context Compiler

昨天那篇 每天 1000 条钉钉消息,我让一个 Agent 先编译再开口 是从一个 ❌ 开始的:我在单聊里问一位同事某件事要不要先做,他回了四个字「今天弄好」;5 分钟后,我的工作助理 Muse 把这句话当成急事推给了我——而我 7 分钟前就在和他聊这件事。

那次修的是推送时机。但这四个字之后一直在我脑子里,因为它暴露了另一个问题:同一件事,在我的台账里是「等别人交付」,在他那边是「我要办」。 Muse 只编译了我这一半。他那一半在他脑子里、在他的待办里,或者哪儿都没有。

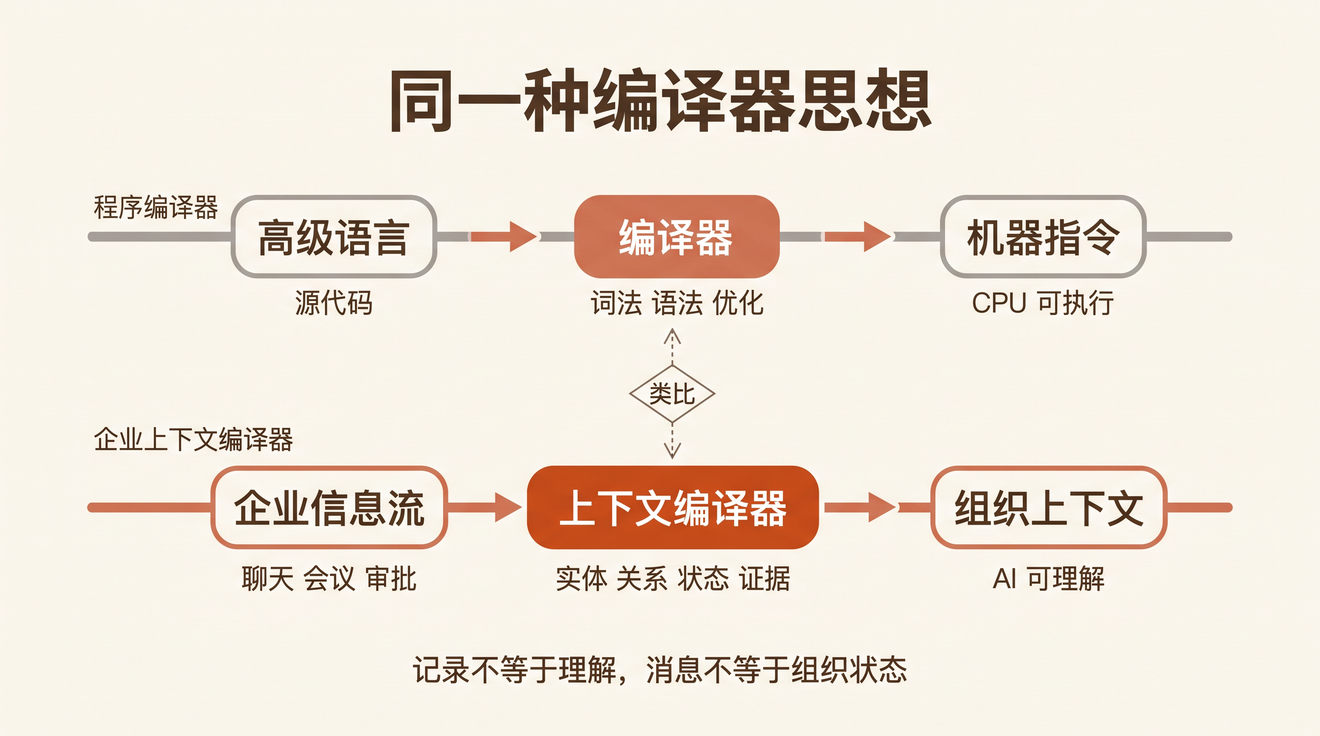
把一个人的工作流编译成 AI 能用的上下文,444 那篇已经跑通了。这篇往上走一层:一个组织的工作流,能不能像程序一样,被一台编译器编成 AI 可以执行的上下文?

我的回答是能,但前提是把「编译器」这个类比当真——不是借个名字,而是把词法分析、符号表、中间表示、链接、增量编译一一对上,再老实承认它在哪里不成立。恰恰是不成立的那几处,决定了这台编译器该怎么设计。
From Program Compiler to Enterprise Context Compiler

[Read More]

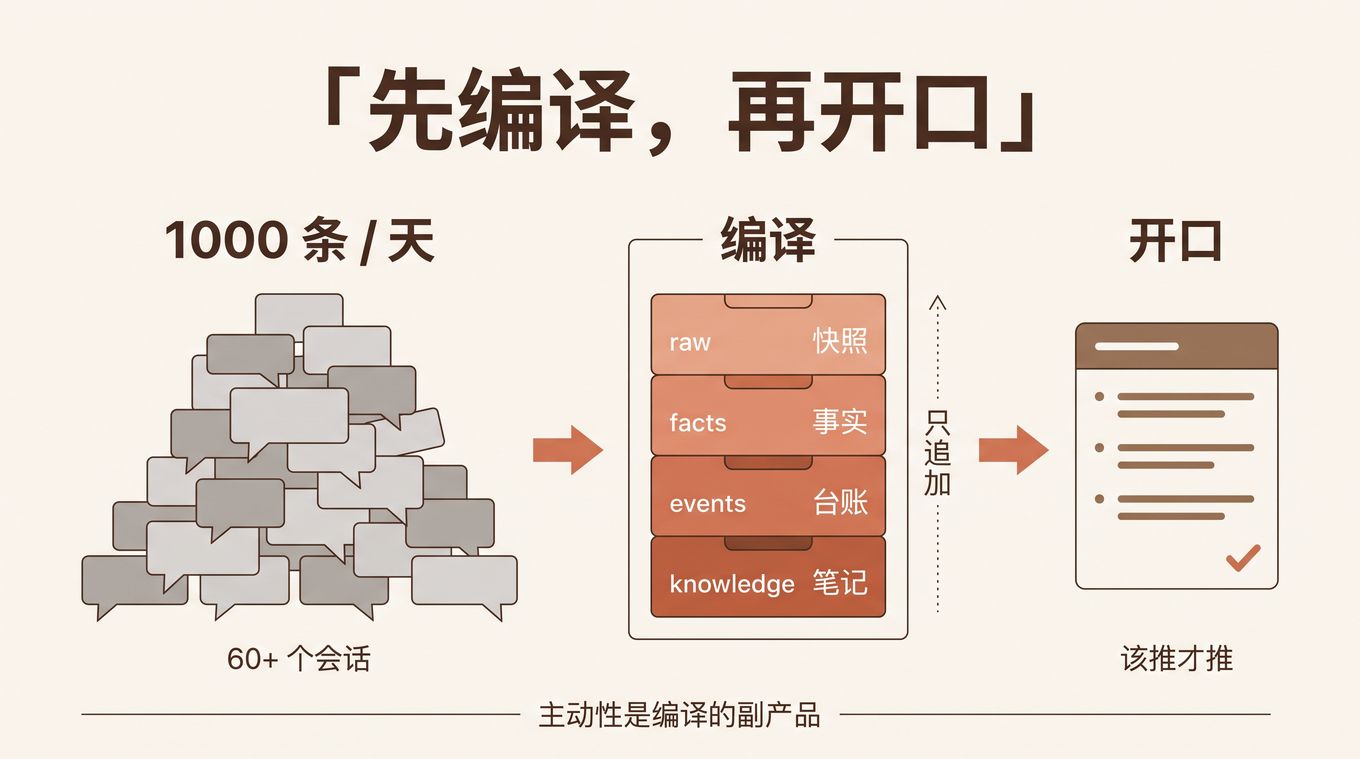
每天 1000 条钉钉消息,我让一个 Agent 先编译再开口

Compile Your Work Stream Before Your Agent Speaks

前几天,我对自己的工作助理打了一个 ❌。

它推过来一张「工作事项提醒」:🔴 等别人交付——某同事今天要把一件事弄好。问题是,这件事我 7 分钟前还在和那位同事单聊。我问他要不要先做,他回「今天弄好」,助理把这句话记进了台账,5 分钟后就把它当成急事推给了我。截止时间是当晚。

信息本身没错,每个字都对得上原话。错在 时机:我正在处理的事,它又来提醒我一遍。这一个 ❌ 让我意识到,我给这个助理(下文叫它 Muse)定的目标——「主动帮我管理钉钉上的工作信息流」——难点从来不在「主动」,而在主动之前那一步:它得先知道哪件事是谁的、现在是什么状态、我此刻在干什么。

这三件事,靠一个更聪明的模型现场去翻聊天记录是翻不出来的。它们得被 编译 出来。

Compile Your Work Stream Before Your Agent Speaks

[Read More]

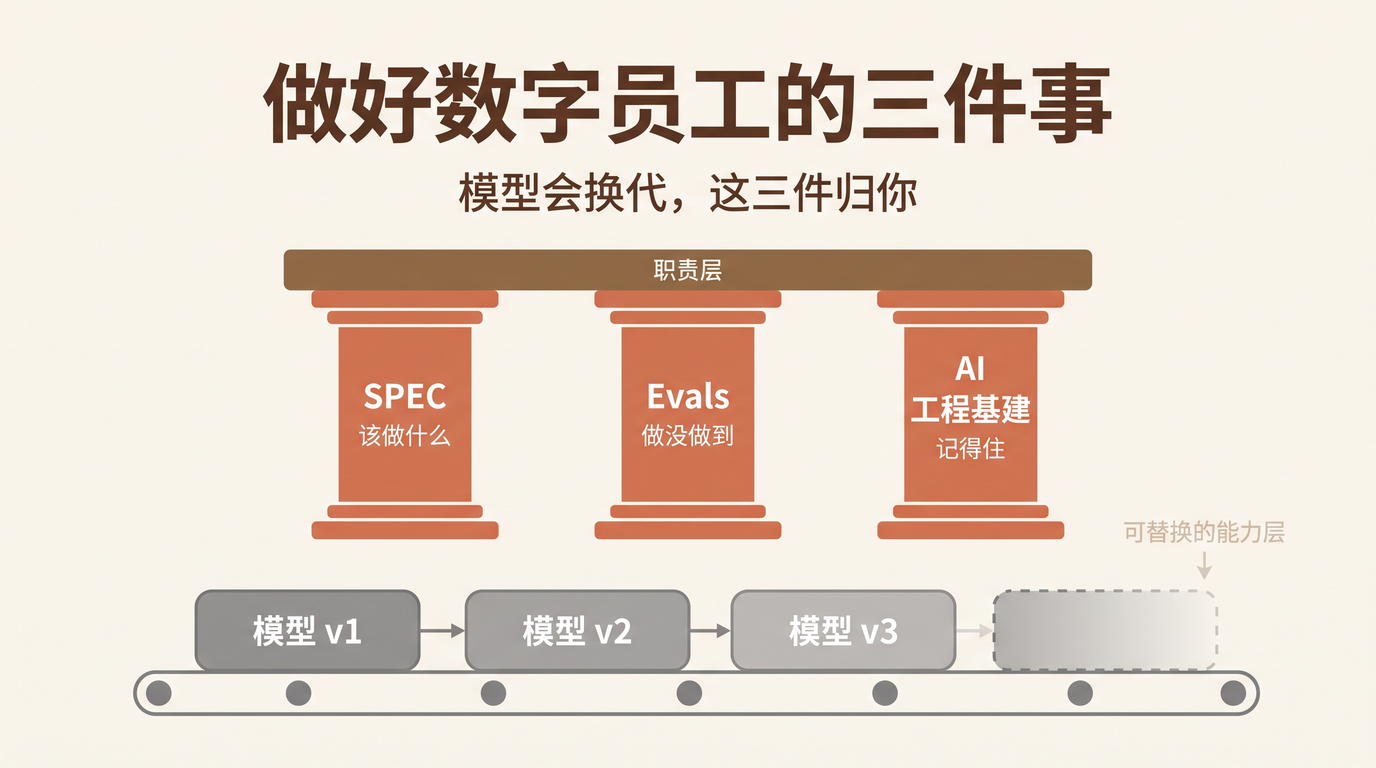
做好一个钉钉数字员工,只有三件事:SPEC、Evals 和 AI 工程基建

What Survives Every Model Upgrade: SPEC, Evals, and AI Engineering Infrastructure

写给正在做企业 IM 场景 Agent 的工程师。你已经能让一个 Agent 在钉钉里回消息、调工具、查制度。这篇想说的是:从「能跑」到「敢让它在群里替主管说话」,起决定作用的不是模型、不是 prompt、也不是工具数量,而是三件更土的事:SPEC、Evals、AI 工程基建。

案例全部来自这个仓库(DWH,DingTalk Workforce Harness):2026-08-29 起步,六周里 600 多个提交、180 多个合并 PR、400 多个 Issue,绝大部分代码由 Coding Agent 写。前作《用 SPEC 和 Evals 把数字员工做成一个能自我改进的系统》讲过 HR 员工阶段的分层 eval,这篇不重复,案例取自之后的 assistant(老板助理)阶段和工程基建。

What Survives Every Model Upgrade: SPEC, Evals, and AI Engineering Infrastructure

[Read More]

通讯录不是人员列表,是企业本体的第一张骨架图

The Org Chart Is Not a Contact List, It Is the First Skeleton of Your Ontology

先说一类很常见的翻车现场。一个数字员工被问「把这份报销单转给张三的直属主管审批」,它很自信地查了通讯录,拿到一个名字,发过去了。结果那个人三个月前就调岗了,张三现在的主管是另一个人。报销单卡在一个已经不管这摊事的人那里,没人报错,日志全绿——只是这件事从此没人推进。

问题不在模型笨。模型很聪明,它把「查主管」这个动作完成得干净利落。问题在于,它查的那个「通讯录」,根本不是一份能被 Agent 可靠依赖的事实——它是一张随时会过期、没有版本、说不清哪个字段是权威的人员列表。

几个月前我在 Palantir 从本体长到 Agent,我们从 Agent 长回本体 里下过一个判断,下得很痛快:

Ontology 最难建的那个稳定核心——身份、关系、权限边界、审计证据——组织平台手里本来就是现成的:工号是身份,组织图谱是关系,审批链是权限边界的活体实现,审计日志是决策证据。

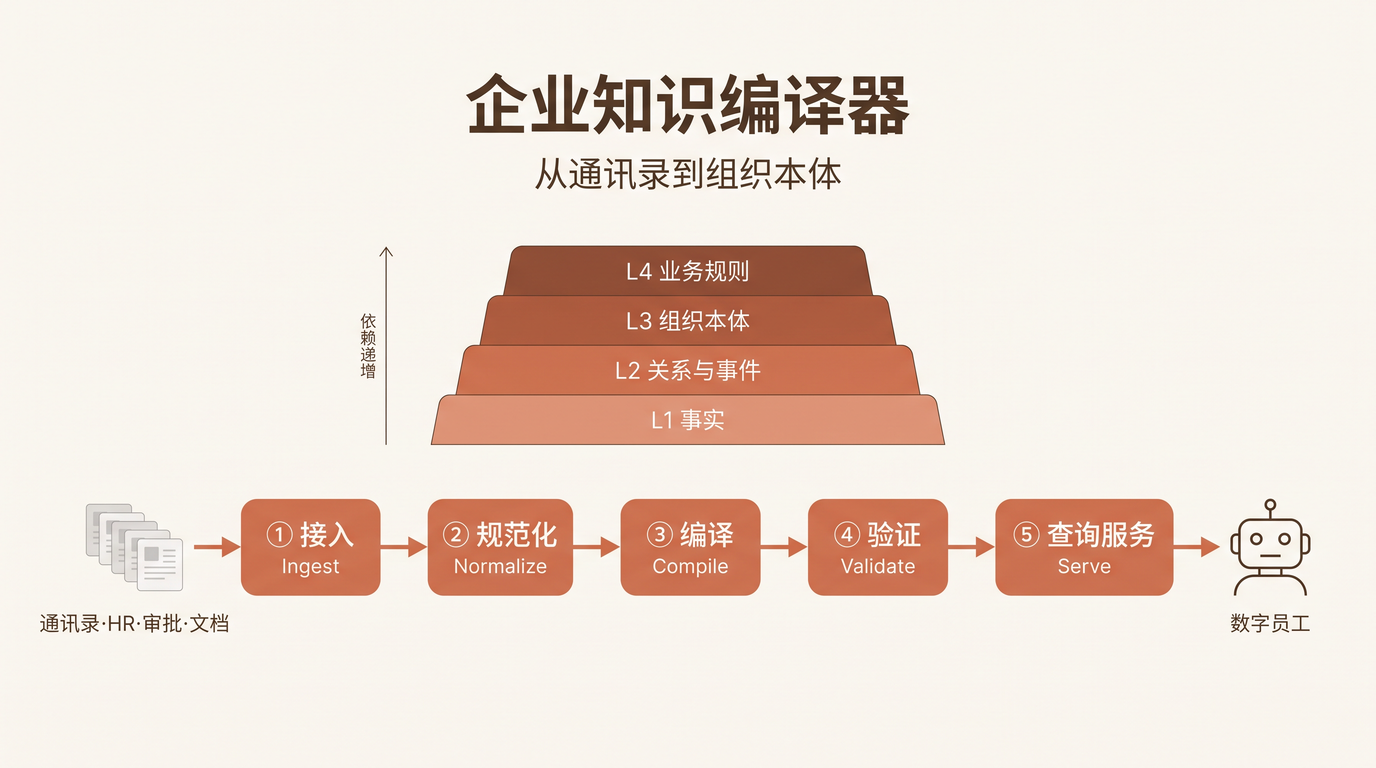
那篇讲的是路线:为什么组织平台可以反着走,先让 Agent 以数字员工的身份上岗,再从它的日常工作里长回本体。但路线讲完,有个工程问题被我一笔滑过去了——从钥匙串到本体,中间那道编译,具体怎么做?

「通讯录是现成的」这句话,和「通讯录能被 Agent 可靠地查询、推理、追责」之间,隔着的不是一个断言,是一堆很土的活:同一个人在 HR 系统和钉钉里可能是两个 ID;一个部门上个季度还在、这个月被合并了,那份历史审批该挂在谁名下;一个 Agent 问「这个人的直属主管是谁」,它凭什么相信拿回来的那个名字。开头那张卡住的报销单,就死在这堆活里。

这篇就把这道编译拆开写。核心判断只有一句:企业知识不是检索出来的,是编译出来的;而且要从最土的那一层开始编译——可验证的事实。

The Org Chart Is Not a Contact List, It Is the First Skeleton of Your Ontology

[Read More]

数字员工不是一个更大的 Agent Loop

A Digital Employee Is Not a Bigger Agent Loop

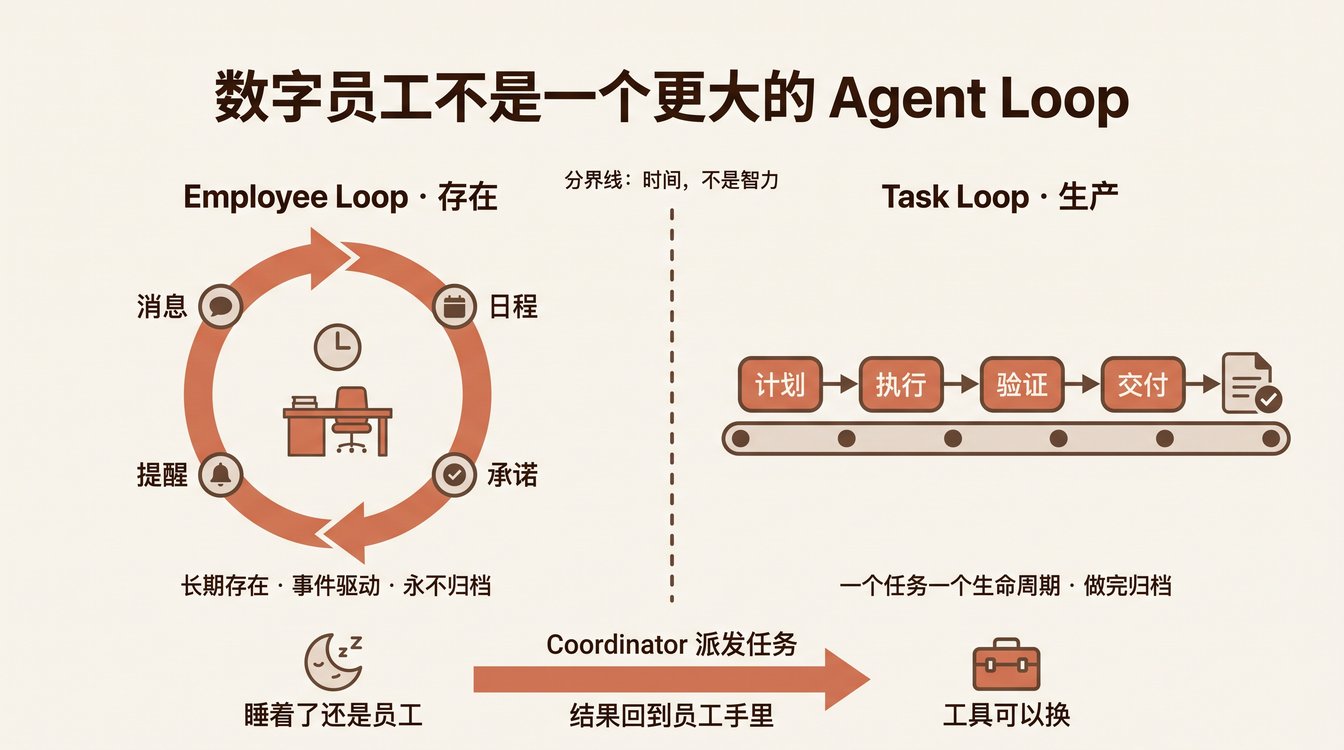
早上 8 点整,没有人给「涌现」发消息,它已经起床干活了。

涌现是我的钉钉数字员工。每天早上 8 点整,任务消息准时到达,日程表上排着五项早读:读公众号后台、读 GA、digest 小红书、更新 token 消耗、扫一遍 aibase,预算一小时。中午 12:05,下一班任务照样准点到——它安静干完活,报告发进群,日志里一行 ok=True,一条兜底都没有。(这是我在 谁停掉了数字员工的早读? 里给它验完尸之后的日常。)

没有人 @ 它,没有人提问。它是被自己的日程叫醒的。

这个细节值得停一下:聊天机器人被消息召唤,员工被日程叫醒。而被日程叫醒只是起点——一个真正意义上的员工,还得记得昨天答应过什么,知道十点该跟进谁,干完活主动来汇报。这些都不是「回答得更聪明」的问题,是架构问题。

而这两年,全行业的力气都花在把 Agent Loop 做得更大、更聪明上。我的判断是:数字员工缺的不是一个更大的 Loop,是另一个 Loop。

A Digital Employee Is Not a Bigger Agent Loop

[Read More]

一切皆员工:我们在 DeepSeek Harness 上装了一支钉钉数字员工团队

Everything Is an Employee: Building a DingTalk Digital Workforce on DeepSeek Harness

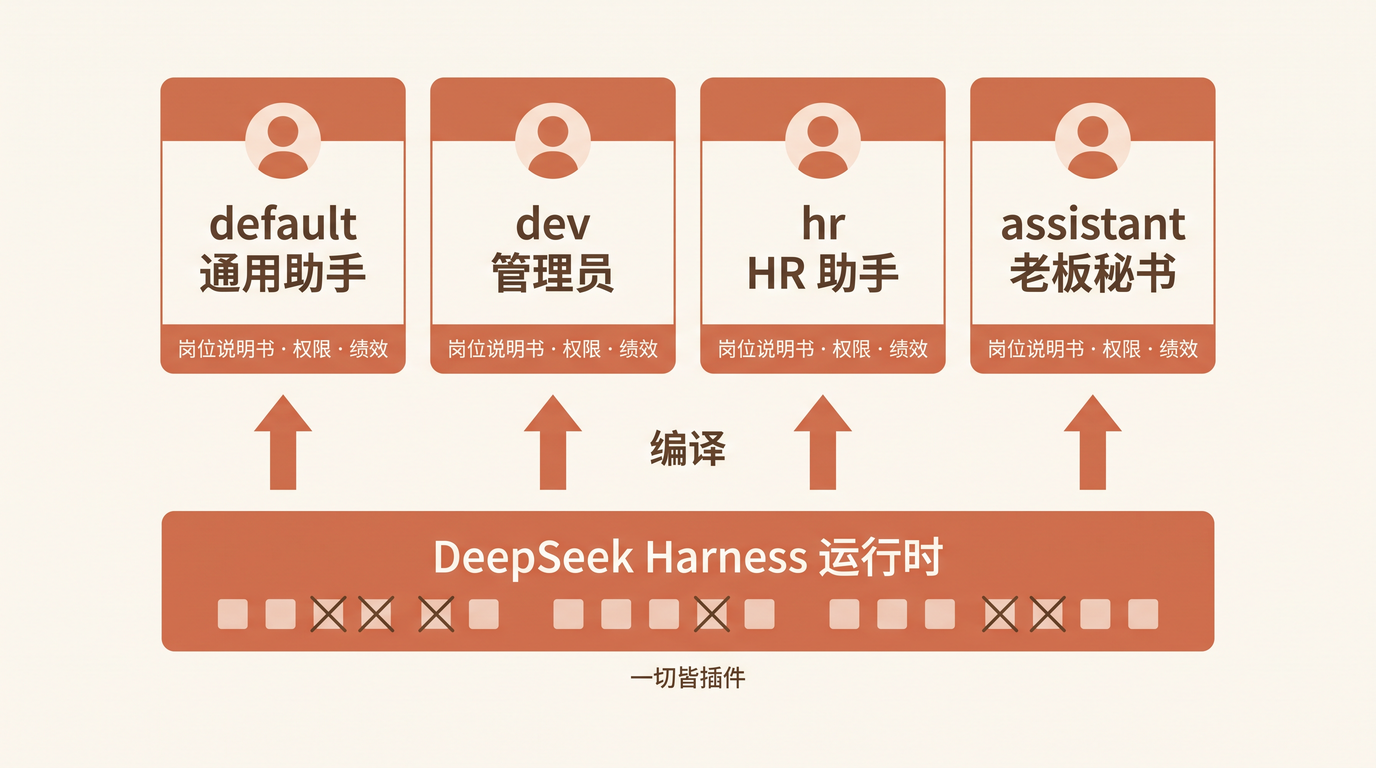
上个月我连写两篇拆解 DeepSeek Harness(dsh):一切皆插件:DeepSeek Harness 的野心与收敛鸿沟 说它开源的不是工具,是运行时;一切皆插件:真正硬核的是三个细节 拆了注册即副作用、事件日志做脊柱、乱序完成按序写回这三个工程承诺。当时我的结论是「可以吹,但不必急着用」——预览版、破坏性变更写在官方文档里,日常编码不如用成熟的 Coding Agent。

几周后打脸了:我们把一支真实的钉钉数字员工团队装在了它上面。项目叫 DWH(DingTalk Workforce Harness),四个员工——通用助手 default、管理员 dev、HR 助手 hr、老板秘书 assistant——各自是一个独立的 dsh 进程,在钉钉里各管一摊、各有权限、互相平级。这篇讲为什么「不必急着用」的判断没错,但「怎么用」的答案错了:开源 Agent 运行时的正确用法,不是把它当产品直接用,而是把它当操作系统,在上面建一层「员工管理制度」。

Everything Is an Employee: Building a DingTalk Digital Workforce on DeepSeek Harness

[Read More]

Grok Bot 能当队友,还当不了员工

From AI Teammate to Digital Employee: Why Onboarding Starts Now

xAI 的 Grok Bot 发布页上,留着一条来自运营岗用户 Emma 的感言(译):

「刚开始的时候,我每 15 分钟就要去查看一次 Bot,事无巨细地盯着它——直到它反过来问我,为什么我总是问这么多问题。现在我放手让它自己干,它反而越用越好。」

这可能是「数字员工」这个产品形态目前拿到的最好背书:不是一个等你提问的工具,而是一个你可以把工作交出去、然后转身去干别的事的队友。

但同一页往下翻,还有一行写给企业用户的小字:加入 waitlist。

喊得最响的「可以把真实工作交给它」,到了企业门口,只换来一句排队等候。这个反差值得认真对待:Grok Bot 上线 24 天,验证了什么?它又到底卡在哪?

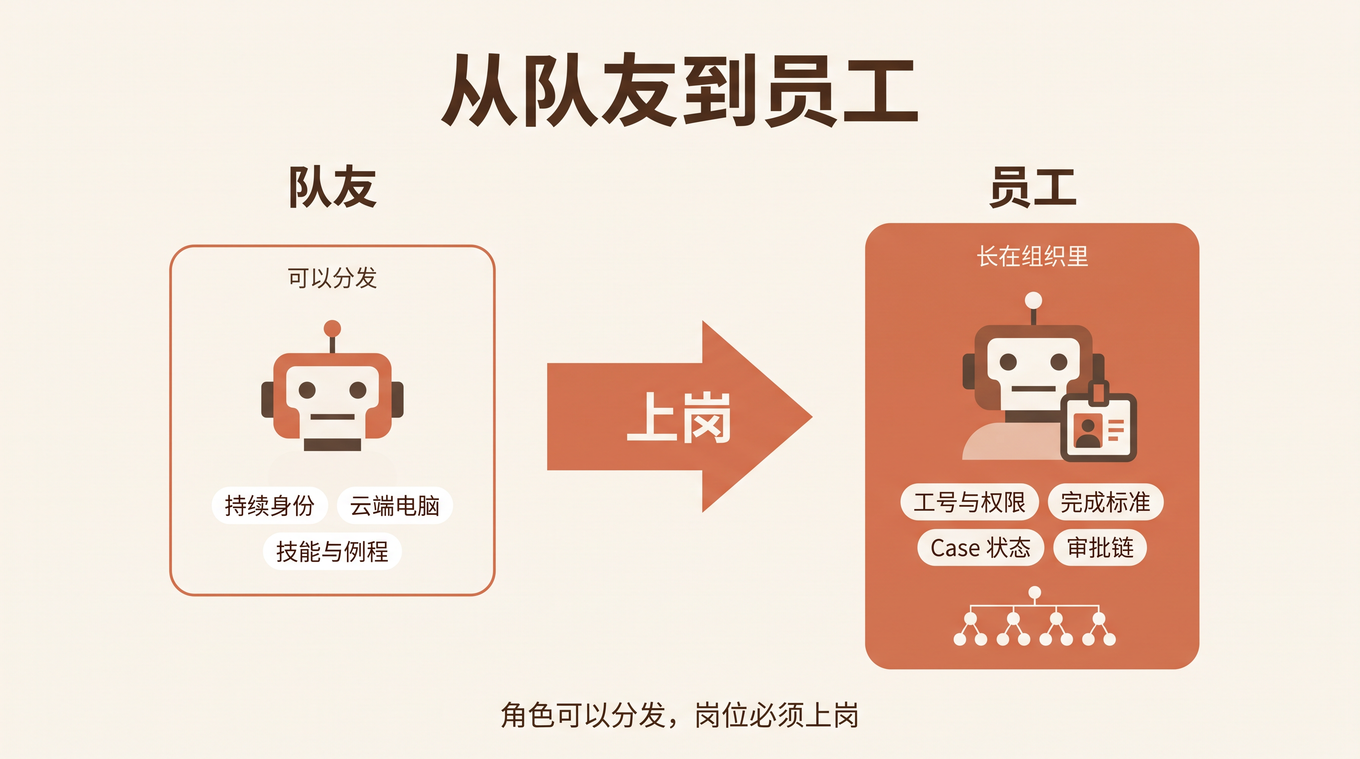
先说结论: Grok Bot 验证了「持续角色」这个产品形态,但企业要的是「岗位」。从角色到岗位,差的最后一段不是模型能力,而是组织基础设施。 而这一段,恰恰是企业现在就应该开始在钉钉里上岗数字员工的原因。

From AI Teammate to Digital Employee: Why Onboarding Starts Now

[Read More]

数字员工上岗半年,我在钉钉上的时间翻了一倍

AI Won't Build a New Entry Point — It Deepens Your Dependence on the Old One

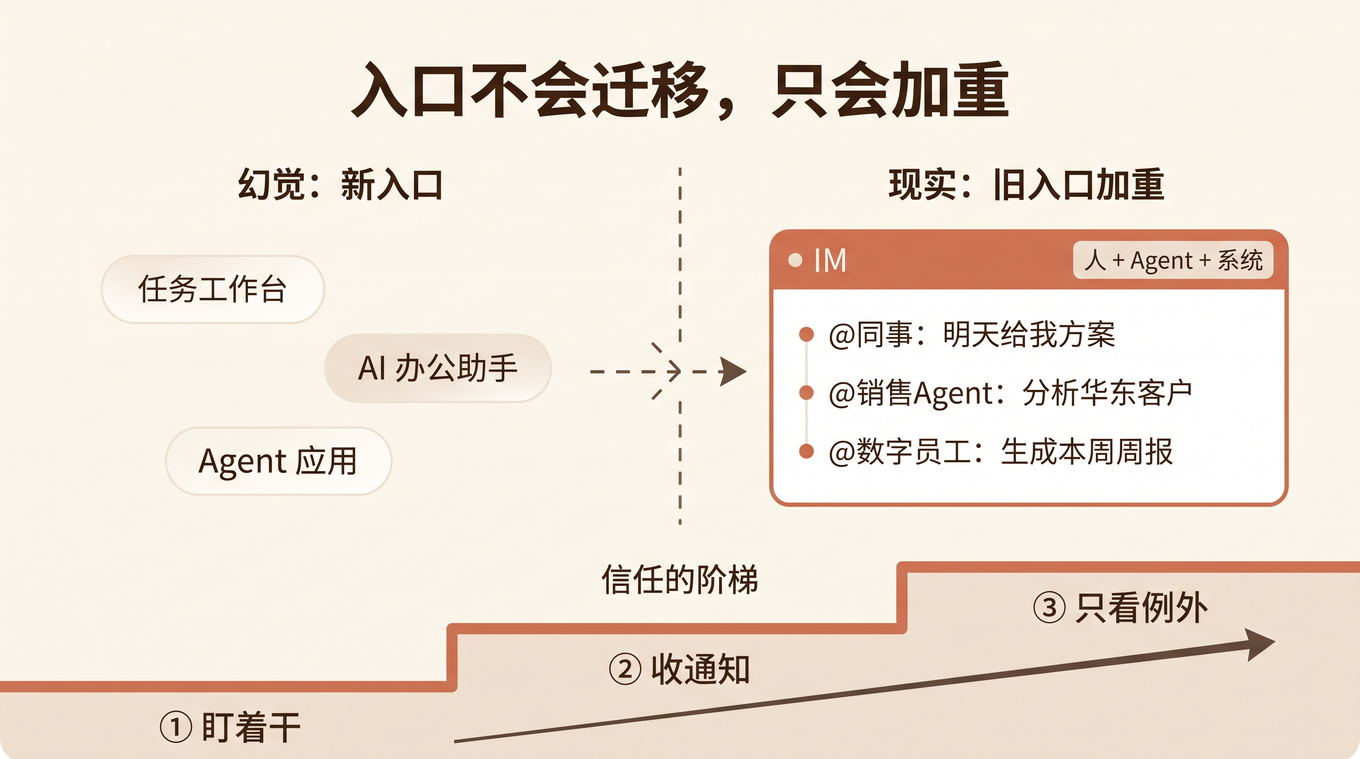
半年前,我给自己上了第一批数字员工。上岗之前,我的想象是这样的:任务交给 Agent,我只管派活和收结果,我在钉钉上的时间应该大幅下降。

半年后,我打开自己的屏幕时间统计:我在钉钉上的时间没有下降——翻了一倍。

起初我以为是个体差异。但和几位同样在带数字员工的同事交流后,发现大家的处境差不多:Agent 越多,人在 IM 里花的时间越多。

这让我必须把一个判断写下来:

AI 不会造出新入口,只会加深你对旧入口的依赖。

AI Won’t Build a New Entry Point — It Deepens Your Dependence on the Old One

[Read More]

FDE 的 20 个问题,不该由人一个一个问

The 20 Discovery Questions Every FDE Asks Should Become a Product

客户第一次见面说:「我们想做一个销售 Agent。」

多数团队会立刻追问:想用哪个模型?知识库有多少文档?要不要私有化?

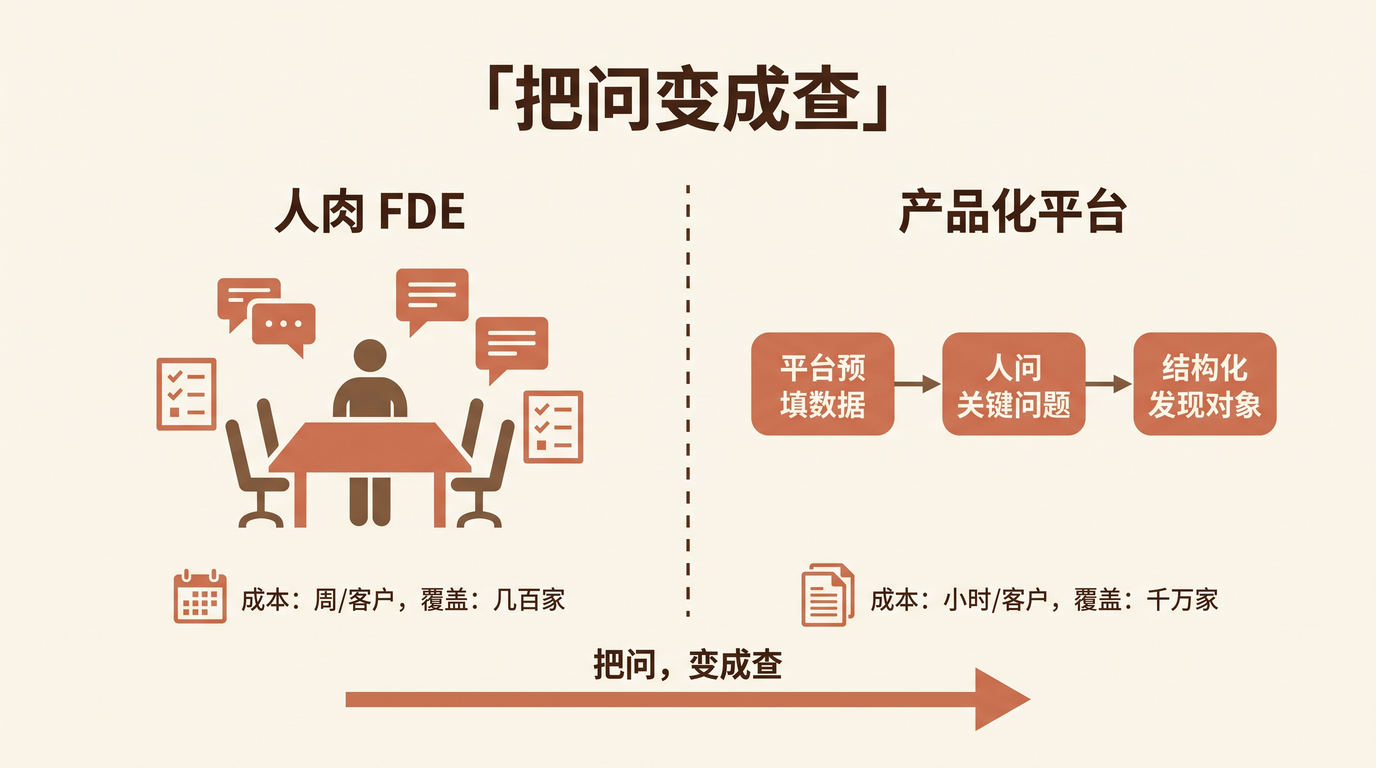
「FDE 前线」最近发了一篇文章,给出了另一套问法——20 个问题,分五组:业务结果、真实流程、数据与系统、风险与权限、采用与责任。第一问就不是「用什么模型」,而是「这条流程最终要产生什么业务结果」。

这 20 问在网上被当成销售技巧清单转发。但我读完后的判断不一样:这不是一份访谈提纲,而是一份组织上下文的采集协议。它真正的价值,和它最大的问题,是同一件事——它太贵了。

The 20 Discovery Questions Every FDE Asks Should Become a Product

[Read More]

钉钉数字员工架构与落地实践

DingTalk Digital Employee: Architecture and Implementation Practices

8 月 27 日晚上,我做了一场《钉钉数字员工架构与落地实践》的分享。六十分钟的正题讲完,真正让我反复回味的,是 Q&A 环节的四个问题。

最后一个最尖锐。提问者先铺垫了他的观察:从演示看,数字员工做的是秘书、提醒、传话、会议纪要这类辅助性工作。然后他话锋一转:

如果我让数字员工承担一部分技术开发工作,它将面对非常复杂的场景和长周期的任务。长周期任务下,执行的成功率会一路衰减。请问你们的数字员工能不能解决复杂的长期问题?如果不能……

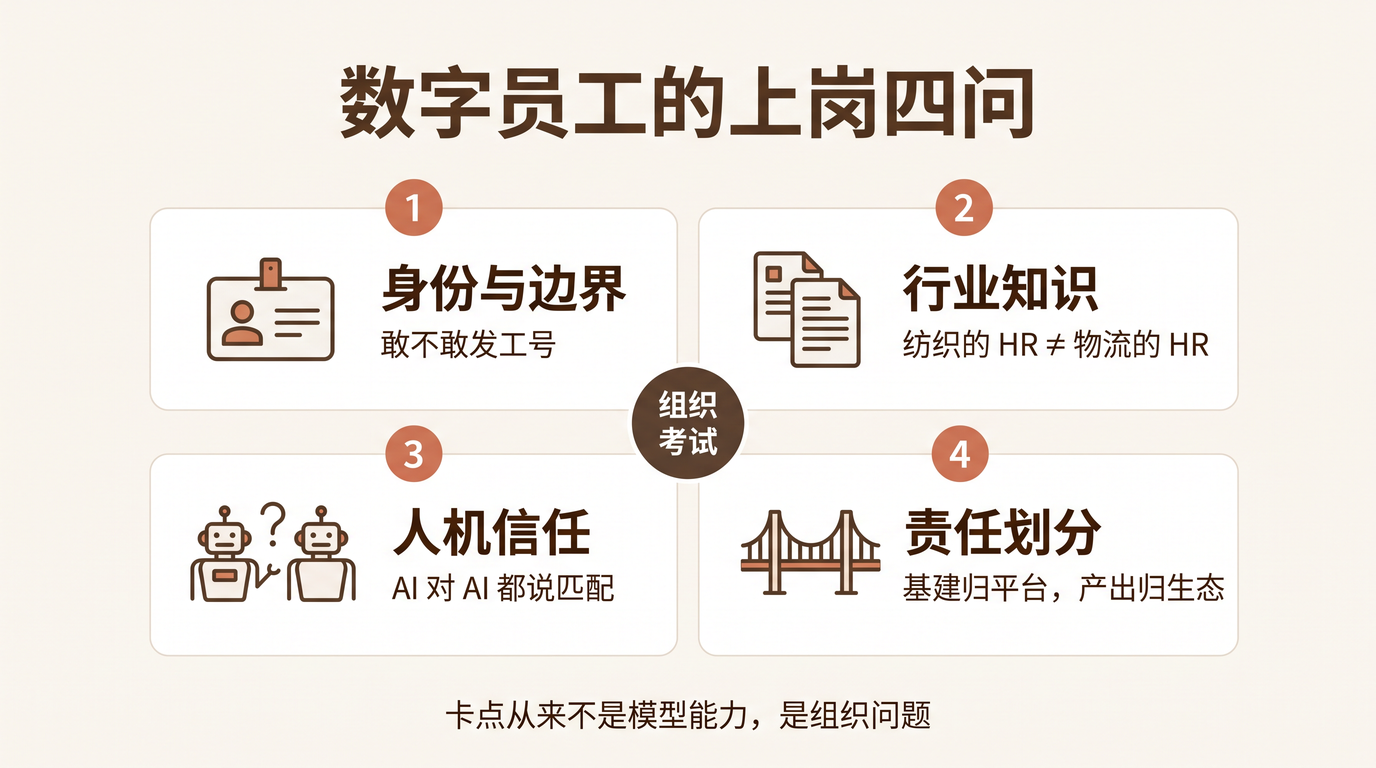
「如果不能」悬在半空。我当时的回答很直接: 钉钉做的是让 AI 能进入企业组织架构的基建——数字员工账号、连接多 Agent,权限管控、运行审计、知识管理,为任务提供上下文等基础能力,还提供入转调离全生命周期管理、执行前主管审批确认放行、岗位能力评估和考核、拟人化交互等功能,但还不能对企业自建或生态交付给企业客户的数字员工的产出效果来负责。

分享结束后,我把这四个问题记了下来。它们看似散,其实指向同一件事: 数字员工的落地卡点,从来不是模型能力,而是四个组织问题。 而四个问题说到底,又可以归到一个词上: 委托 ——把工作交给 AI 之后,这份委托如何在组织里被信任。

DingTalk Digital Employee: Architecture and Implementation Practices

[Read More]