299 美金,够不够把数据留在本地?

Can a $299 Edge Board Keep Your Data Home? A Local 4B Knowledge Compiler Benchmarked Against the Cloud

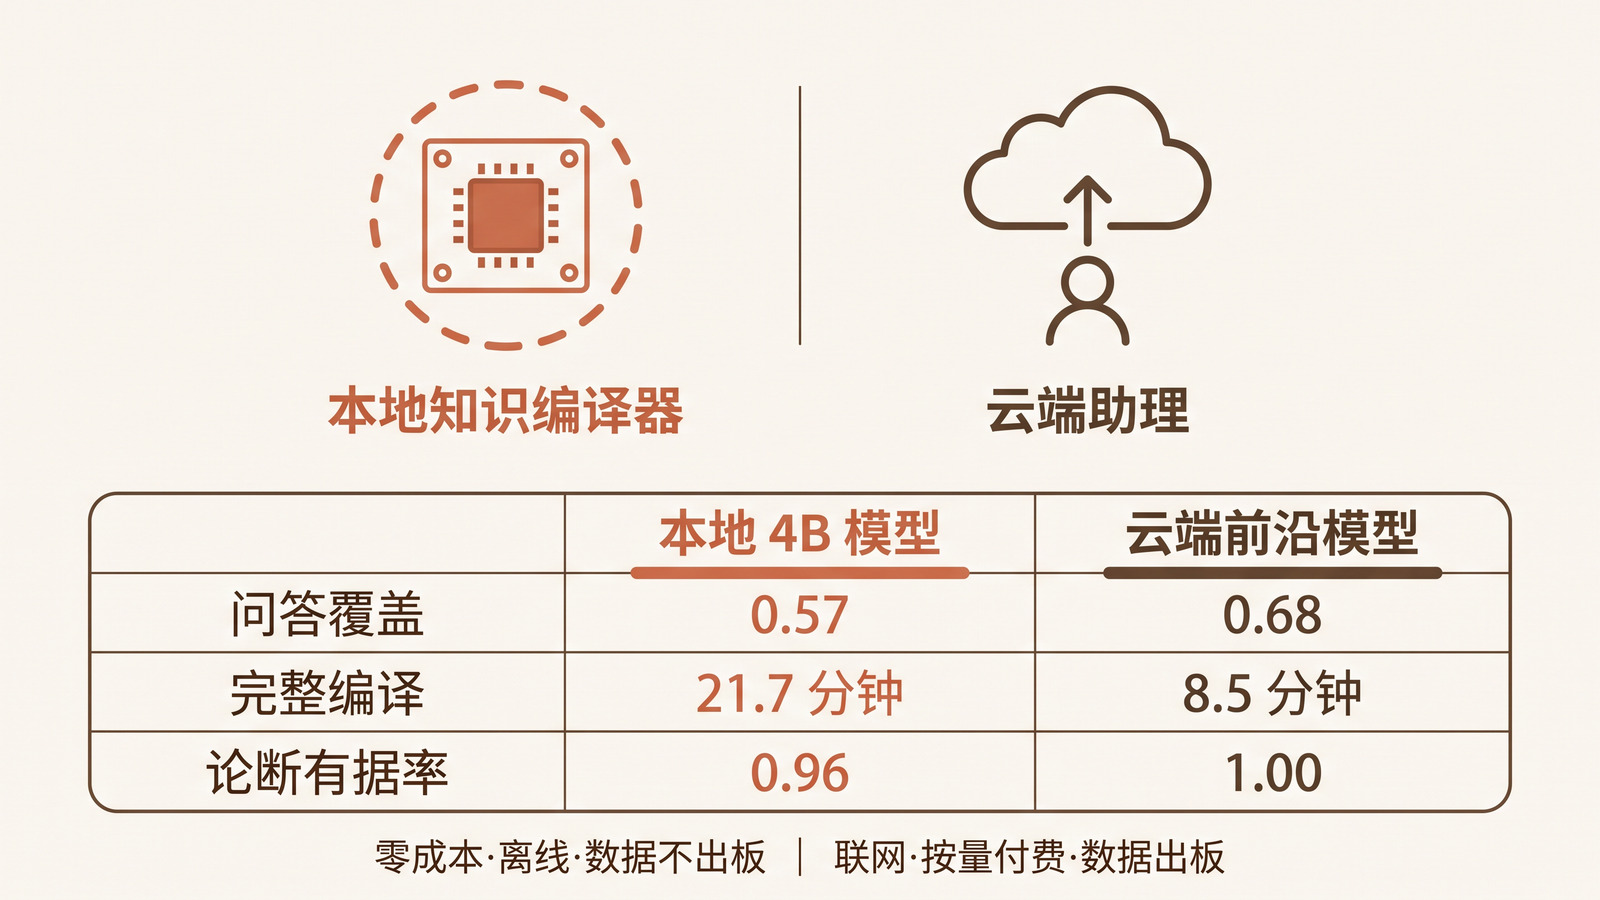
我把自己写过的两篇长文丢进 inbox,然后让一块边缘 AI 板子慢慢嚼。21.7 分钟后,它交出 72 条论断、38 个实体、60 条关系,全部落进一个 SQLite 文件。整个过程没有联网,数据一寸都没离开那块板子。

板子上跑的是一个 4B 的本地模型。我拿它做的事,是给个人知识库当编译器:把非结构化的资料,持续编译成人和 Agent 都能直接用的 Context。同一套代码,我也接上云端的前沿模型跑了一遍做对照——两边跑完,结论有点出乎我的意料:慢 2.6 倍的那一边,质量只差一档;而它换来的是零成本、离线、数据不出板。

当 Muse 们把助理跑在云上,你的数据该放在哪里?
项目地址:https://github.com/hugozhu/knowledge-compiler

本地知识编译器 vs 云端助理

本地 4B 与云端前沿模型的三项对照:指标只差一档,代价却完全不对称——右列的每一分领先,都要用联网、按量付费和数据出板来换

一、Muse 很火,但火的方向有点让人不安

9 月 8 日,Meta 发布了个人 AI Agent Muse:能收发邮件、订机票、网购、管日程,几天内冲上美区 App Store 榜首,随后登陆 Mac。它背后是一整套云端架构——每个用户一个专属云虚拟机,模型是 Meta 的 Muse Spark。OpenAI 随即用 Dots 应战,Instinct 等新玩家也在猛冲融资。

热度之下,争议也在发酵:有用户发现 Muse 读取了自己没有授权的消息,有人被它在 Facebook Marketplace 上泄露了地址。更现实的是企业侧——「数据不出域」是硬约束,把邮件、日历、聊天记录交给云端 Agent,很多公司根本过不了合规那关。

于是形成了一个清晰的空档:云助理把能力做到了极致,但「数据留在自己盒子里」的版本,迟早会有人做。 我的判断是:带本地算力的「硬」桌面个人助理一定会出现,并且会流行。

问题是:本地算力够吗?我手里正好有一块 299 美金的 Arduino VENTUNO Q(Qualcomm Dragonwing IQ8,Hexagon NPU 40 TOPS,16GB 内存,跑 Ubuntu 24.04),于是拿它做了一个实测。

[Read More]
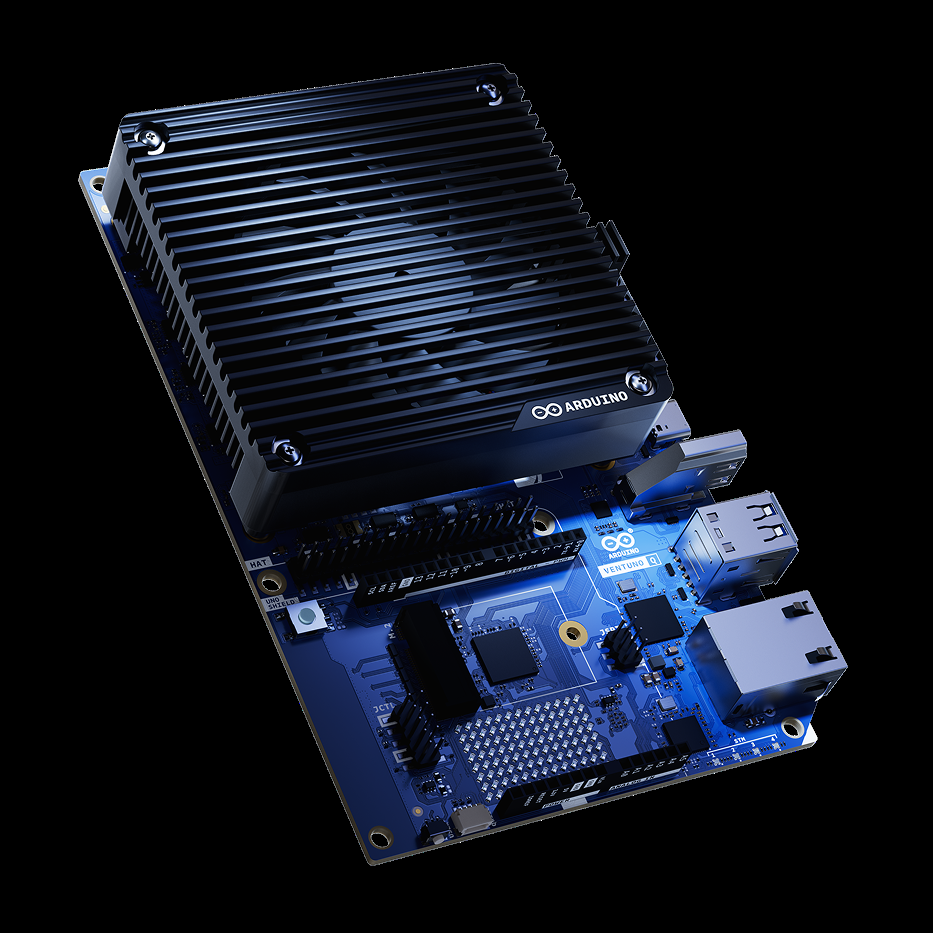
299 美金的个人知识库开发板

A $299 Board That Runs a Real VLM Locally — and Becomes Your Always-On AI Node

本地跑大模型这件事,门槛从来不是模型——Qwen3-4B 的权重谁都能下。门槛是那块能把 4B 模型跑到「可用」的芯片,以及为它付的几百上千美金和几十瓦电费。

我花 299 美金买了一块 Arduino VENTUNO Q,把这件事的门槛砸到了地板上:一块 160×100mm 的开发板,NPU 上跑 Qwen3-4B 文本 16.6 tok/s、跑 Qwen3-VL-4B 看图 13 tok/s,纯本地、零边际成本、常驻不关机。

开始教程之前,先把一件事说清楚:这篇文章的所有配置,都是用 OpenCode 以对话方式完成的,没有一行命令是我手敲的,效率比手工高得多。 OpenCode 作为 agent 直接在板子上执行 shell、读写文件,背后配 DeepSeek V4 Flash(快、便宜、上下文长),查资料、装环境、部署模型、写服务、排错,甚至板子上那份上手文档的初稿,全部在一个会话里贯通。这种做法的效率提升非常直接:不用手工复制命令,不用在搜索引擎和终端之间来回切换,agent 踩了坑当场修,下文的每一条命令都是它当时实际执行、验证通过的记录。最后配出来的本地 VLM 服务本身就是一个 OpenAI 兼容后端,又反过来接进 OpenCode 用——用 AI 搭 AI,闭环了。

这篇是完整上手教程——从开箱到把它变成一个 OpenAI 兼容的常驻服务,接进你的 Agent 工具链。中间有三个能让你白耗一个下午的坑,我一并写清楚。

Arduino VENTUNO Q 官方产品图

Arduino VENTUNO Q 官方产品图(仅作描述性引用)

[Read More]