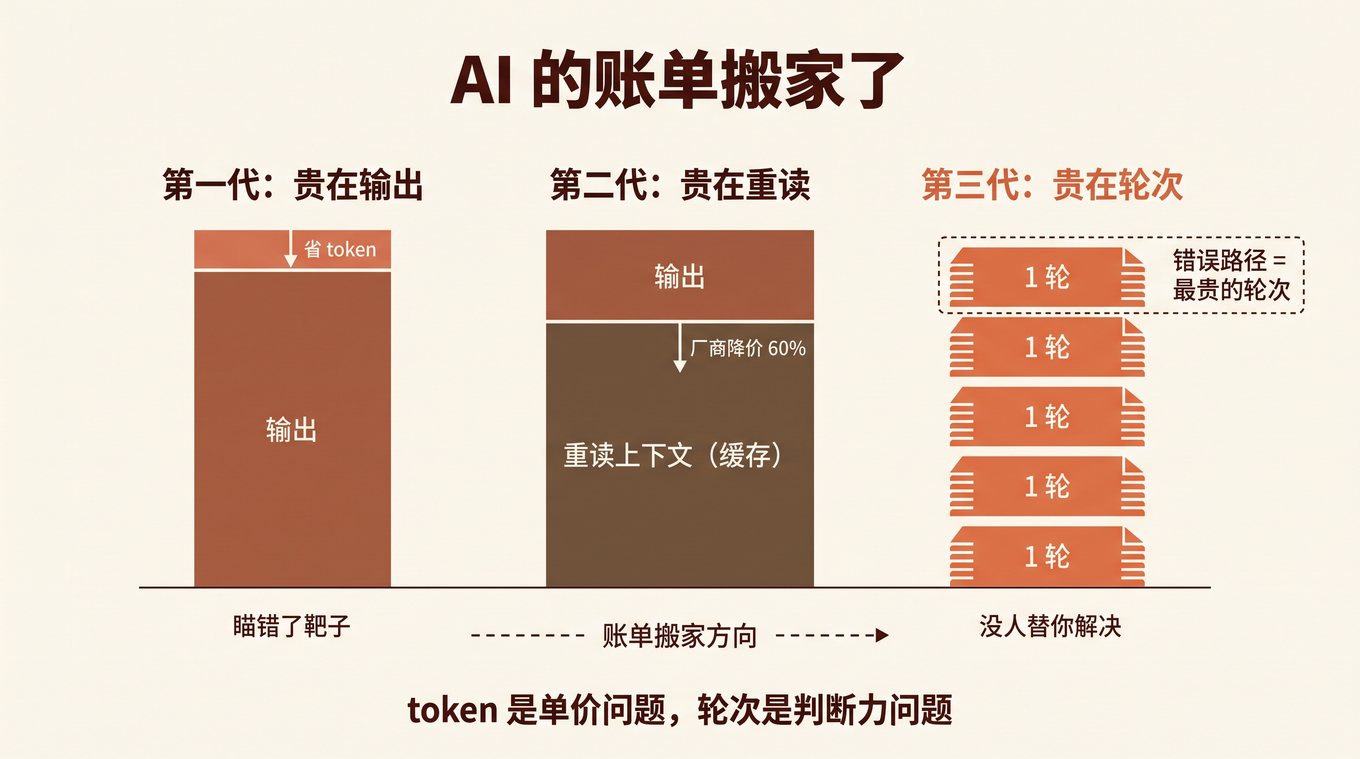
AI 的账单搬家了:从 token 到轮次

The Bill Has Moved: From Tokens to Turns

Anthropic 昨天发布 Opus 5.5,标题新闻是降价:同样的工作负载,成本比上一代低约 40%。

但这篇发布博客里最值钱的不是降价,是一组没上标题的数据。他们拉了 2026 年 3 月到 9 月 Claude Code 的聚合账单,发现每个请求的 输入与输出 token 之比,从 189:1 涨到了 324:1——六个月内,每个请求的上下文膨胀了 2.6 倍。

翻译一下:你的 AI 账单,早就不是「写」出来的,是「读」出来的。 输出只占 token 总量的千分之三;就算算上输出单价通常是输入的三五倍,砍掉一半输出,账单也就省下不到一个百分点。生成是零头,重读上下文才是大头。

而且账单还在搬。博客里引用开发者 Addy 的一句话,我认为是全文最重要的一句:

减少一个轮次,比一个缓存 token 还要更省成本。

token 之后是缓存,缓存之后是轮次。今天把这条搬家路线讲清楚——因为它直接决定你该在哪里省钱、在哪里花钱。
The Bill Has Moved: From Tokens to Turns

[Read More]

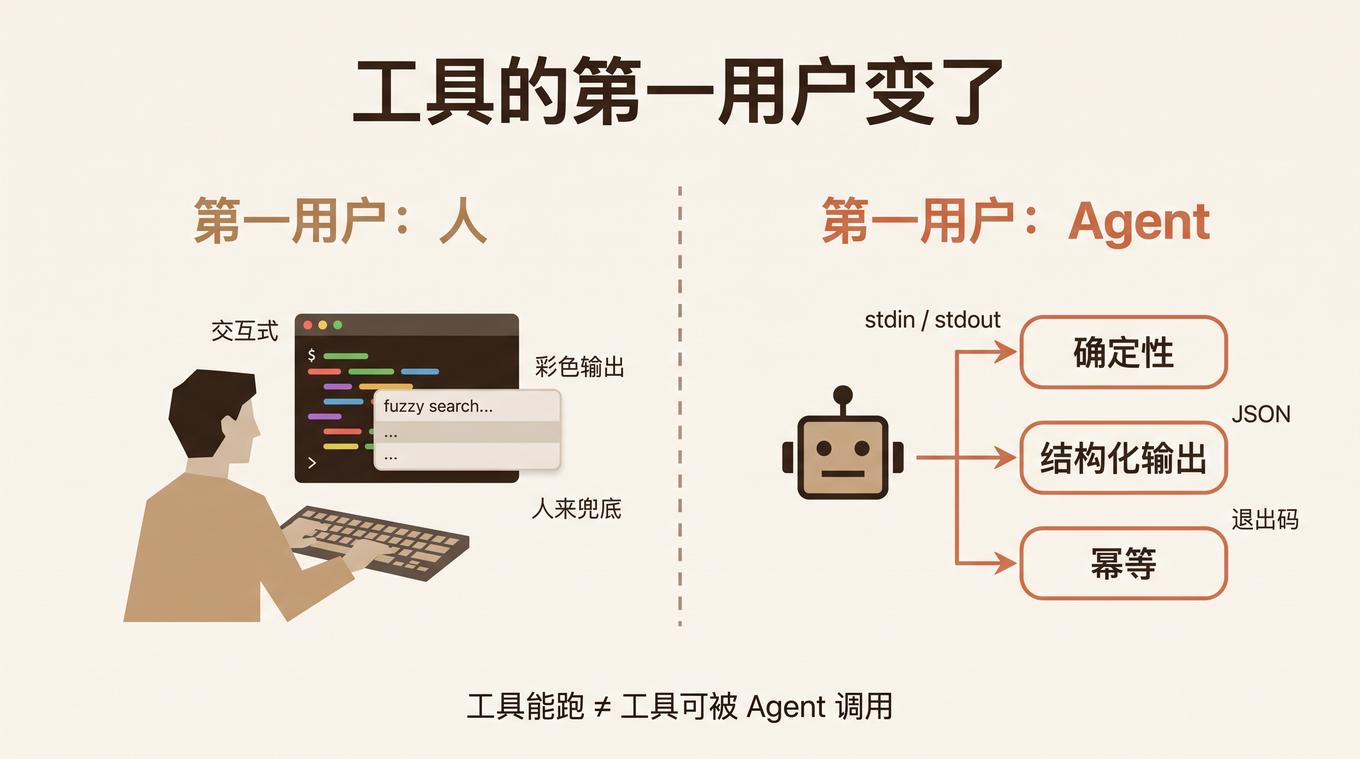
Agent 开发者的工具箱:标准比清单重要

An Agent-First Toolchain — Criteria Matter More Than the List

前几天有人给我发了一份「2026 年 Agent 开发者工具箱」清单,整整 15 个名字:git、gh、docker、uv、node、pnpm、nvm、rg、jq、curl、fzf、just、direnv、python、go。分层清晰,还配了星级。

我顺手在自己这台跑 Agent 的机器上核对了一遍,结果很有意思:15 个里我只装了 7 个。

for t in git gh docker uv node pnpm nvm rg jq curl fzf tmux direnv just mise; do
  command -v "$t" >/dev/null && echo "$t: yes" || echo "$t: NO"
done
# generated by hugo AI

git、gh、uv、node、pnpm、rg、curl 在;docker、jq、fzf、tmux、direnv、just、mise 一个都没有。机器没罢工,Agent 每天照样在上面干活。

所以我没有急着去补齐那 8 个缺口,而是先问了一个更基本的问题:这份清单是按什么标准选的?是给人用的,还是给 Agent 用的?

这两个问题的答案,会导出两份完全不同的清单。

An Agent-First Toolchain — Criteria Matter More Than the List

[Read More]

AI 时代工程师的新交付物:图灵完备的 Agent

From shipping code to shipping Turing-complete autonomous agents

上个月面试一个候选人,简历很漂亮,做过三年 LLM 应用开发。我问他:「你觉得你做的东西,本质上是在交付什么?」

他说:「交付模型能力。把 LLM 的能力封装成 API,让业务方能用。」

我又问:「如果业务方说,我要一个能自主完成端到端任务的系统,不只是回答问题——你交付的东西能做到吗?」

他愣了一下:「那得加很多工程,不只是调 API。」

我说:对,这就是我今天想聊的——当交付物从「模型能力」变成「自主系统」时,你的工程标准该是什么样。

[Read More]

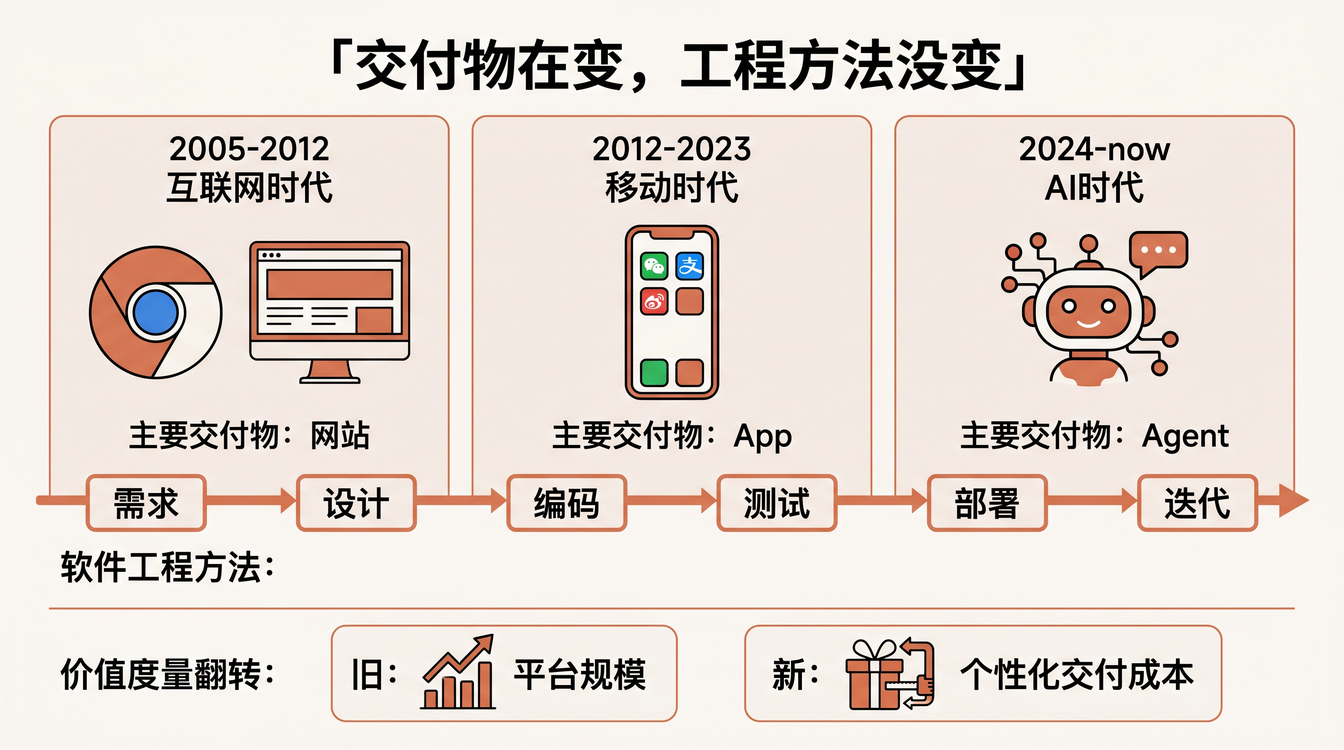
从做网站到做 Agent:工程师没变,交付物变了

Software engineering stays the same — what changes is the deliverable and the value metric

上周和一个做了十五年全栈的朋友吃饭。他最近从大厂出来,拿到两个 offer:一个是去创业公司做 Agent,一个是去传统企业做数字化。他选了后者,理由是「Agent 太新了,不确定性太大」。

我问他:你觉得做网站和做 App 有什么区别?

他想了想:「差不多,都是接需求、写代码、上线、迭代。」

我又问:那做 Agent 呢?

他说:「也是接需求、写代码、上线、迭代。只是交付物从页面变成了 Agent。」

他自己把答案说出来了,但没意识到这句话有多重要。

从网站到 App 到 Agent:交付物在变,工程方法没变

[Read More]

手冲咖啡.SKILL

Pour-Over Coffee as Agent Skill

每一杯手冲咖啡,都是一次 Skill 的执行。

研磨度、水温、注水手法、断水时机——这些看似随意的参数,在专业咖啡师手里是一套精确的、可重复的、经过成百上千次迭代的程序。AI Agent 的 Skill 也一样:把「凭感觉做事」变成「按配方执行」,把个人经验沉淀为组织能力。

这篇文章本身就是一份 Skill。它的格式遵循 SKILL.md 规范,它的内容是手冲咖啡与 AI Skill 设计之间的深层同构。

Brew Notes — 手冲咖啡 Skill 方法论全景图

[Read More]

修 Bug 的真正目的:让 AI 下次能自己修

Harness Engineering — Bug Fix as AI Training Data

一个工程师修了一个 Bug,ROI 是多少?

传统算法:节省了一次排查时间。AI 时代的算法:如果这个修复沉淀为 Harness 的一部分,AI 以后能自动修多少个类似的 Bug。

这就是思维范式的根本转变——你修的每一个 Bug,都是一次训练数据。不是训练模型,而是训练你项目周围的那套 Harness。

[Read More]

代码复制成本归零:工程师的价值正在向上漂移

When copying code costs nothing, taste becomes the new moat

上周六下午,我在 GitHub 上刷到一个 5k star 的开源 CLI 工具——一个看起来挺漂亮的本地日志聚合器。我心血来潮:能不能用 Claude Code 复刻一个?

三个小时后,核心功能跑起来了。彩色输出、文件 watch、正则过滤、多源合并,一应俱全。我兴奋了大概五分钟,然后意识到一件让我心里一沉的事:

我根本不需要这个工具。

那为什么三个小时前我会觉得"做出一个这样的东西"是有价值的?

因为在我过去十几年的职业训练里,“能做出来"本身就是稀缺的。一个能从零搭出完整工具的工程师,值钱。但今天下午,这个稀缺性在我自己的笔记本上被亲手碾碎了。

[Read More]

LLM 押注在 Coding Agent 上是正确的

当每个人都能写代码,IT 系统的瓶颈不再是技术,而是想象力

三个月前,我用 Claude Code 花了一个下午搭了一套完整的钉钉消息监控系统:自动抓取指定群的消息、按关键词分类、生成每日摘要、定时推送到我的私聊。整套流程从数据采集到定时任务,大约 500 行 TypeScript。

同样的事情,如果走公司正规 IT 流程——提需求、排期、开发、测试、上线——保守估计三个月,还不一定能排上。

这件事让我确信一个判断:LLM 厂商把重注押在 Coding Agent 上,是目前最正确的战略选择。 不是因为 Coding Agent 能替代程序员,而是因为它把"用代码解决问题"这件事的门槛,从"需要一个工程团队"降到了"需要一个能清楚描述问题的人"。

[Read More]

AI 原生的思考方式:不能被 Token 解决的问题,才配叫问题

上周,一个做 ToB SaaS 的朋友跟我吐槽:他花了两周让 AI 帮忙写了一套完整的 CRM 后端,代码质量不错,测试覆盖率也够。但上线三天就被叫停了——因为产品方向本身就是错的,客户根本不需要这个功能。

两周的 Token 消耗,毁于一个没被认真思考过的问题。

[Read More]