知识编译最佳工程实践

Knowledge Compilation Engineering: Harness Plus Models

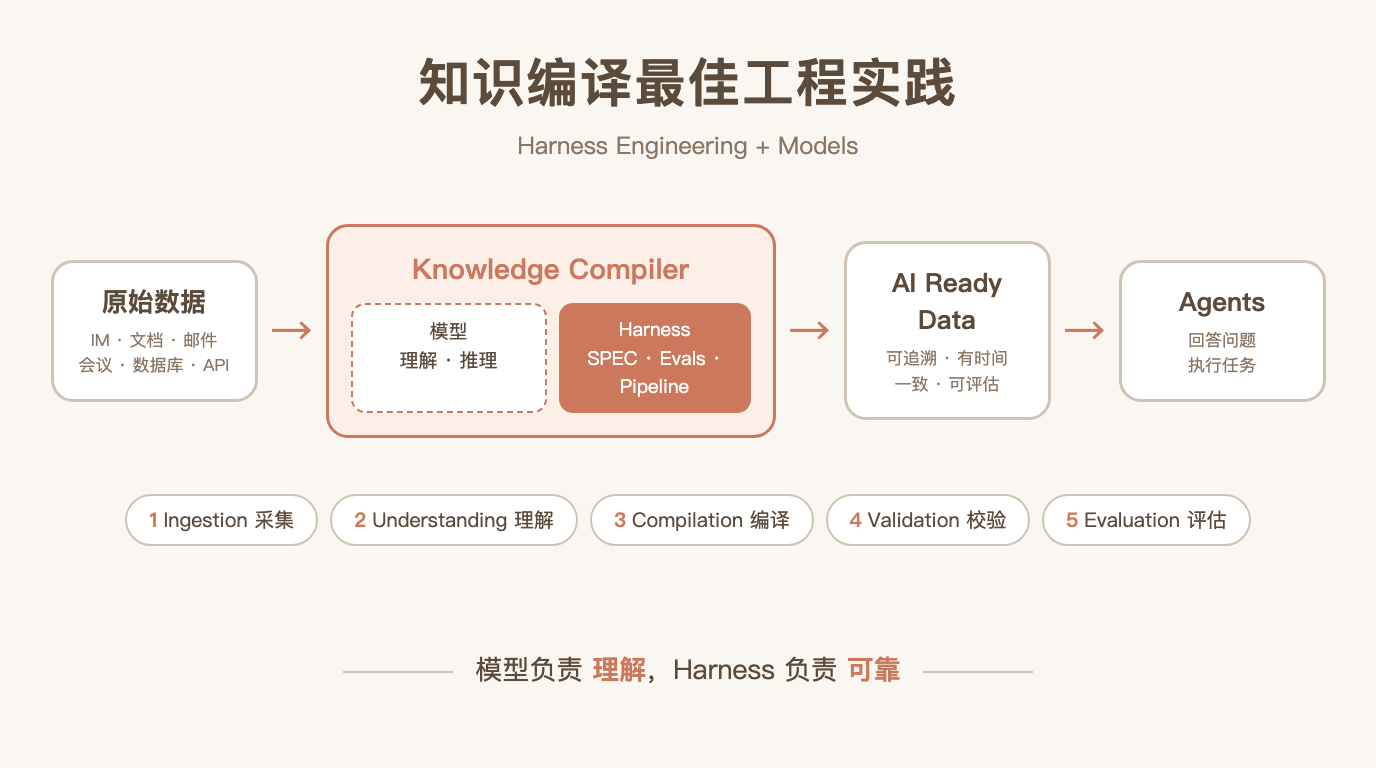
前阵子给工作助理 Muse 算账的时候,我发现一个很尴尬的数字:它每天写一篇工作日记,最早的做法是让模型带着工具自己去翻素材,一次要烧掉约 83 万 token,因为同一份上下文被来回重发了 9 次左右。改成「代码先把素材采齐、模型只调用一次」之后,降到约 6 万 token,耗时几乎不变。

省钱只是表面。更让我在意的是,第一种做法里模型每次都在 重新理解同一批原始消息:谁是谁、哪句话是承诺、哪件事已经关掉了。理解了一遍又扔掉,下次再来一遍,而且每次理解的结果还不完全一样。

这件事让我对知识编译(Knowledge Compilation)形成了一个明确的判断:

目前实现知识编译最合适的工程范式,是 Harness Engineering + Models。模型负责理解和推理,Harness 负责把理解和推理变成一个可靠、可持续运行、可评估、可迭代的工程系统。

这个边界很重要。只有模型,你得到的是一次次聪明但不可复现的理解;只有 Harness,你得到的是一套规则写死、碰到自然语言就失效的 ETL。两者分开各管一摊,知识编译才能成为一个工程系统。

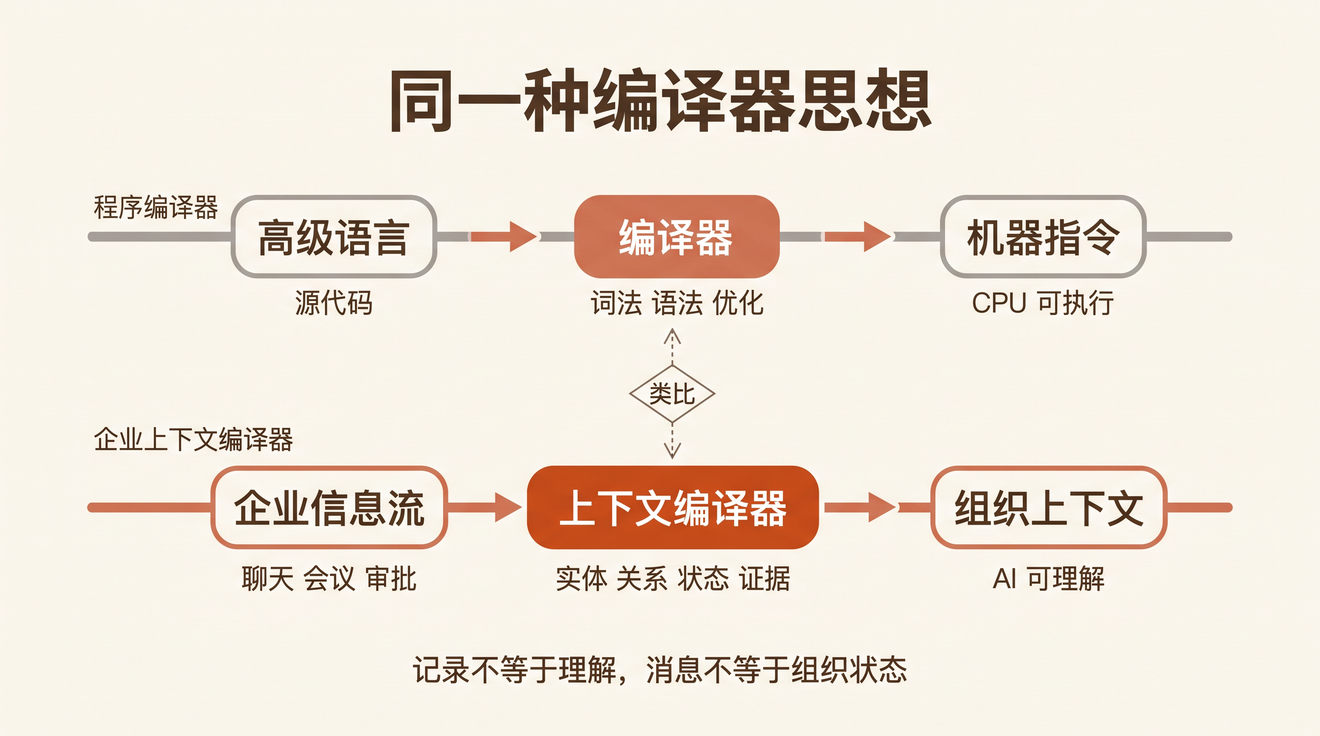
我在 从程序编译器到企业上下文编译器 里讲了「企业上下文编译器」是什么:词法分析、符号表、IR、链接、增量编译怎么一一对上。这篇不重复那个类比,回答的是下一个问题:用什么工程范式把它造出来,以及怎样把它抽象成一套通用的知识编译架构。
Knowledge Compilation Engineering: Harness Plus Models

[Read More]

从程序编译器到企业上下文编译器

From Program Compiler to Enterprise Context Compiler

昨天那篇 每天 1000 条钉钉消息,我让一个 Agent 先编译再开口 是从一个 ❌ 开始的:我在单聊里问一位同事某件事要不要先做,他回了四个字「今天弄好」;5 分钟后,我的工作助理 Muse 把这句话当成急事推给了我——而我 7 分钟前就在和他聊这件事。

那次修的是推送时机。但这四个字之后一直在我脑子里,因为它暴露了另一个问题:同一件事,在我的台账里是「等别人交付」,在他那边是「我要办」。 Muse 只编译了我这一半。他那一半在他脑子里、在他的待办里,或者哪儿都没有。

把一个人的工作流编译成 AI 能用的上下文,444 那篇已经跑通了。这篇往上走一层:一个组织的工作流,能不能像程序一样,被一台编译器编成 AI 可以执行的上下文?

我的回答是能,但前提是把「编译器」这个类比当真——不是借个名字,而是把词法分析、符号表、中间表示、链接、增量编译一一对上,再老实承认它在哪里不成立。恰恰是不成立的那几处,决定了这台编译器该怎么设计。

From Program Compiler to Enterprise Context Compiler

[Read More]

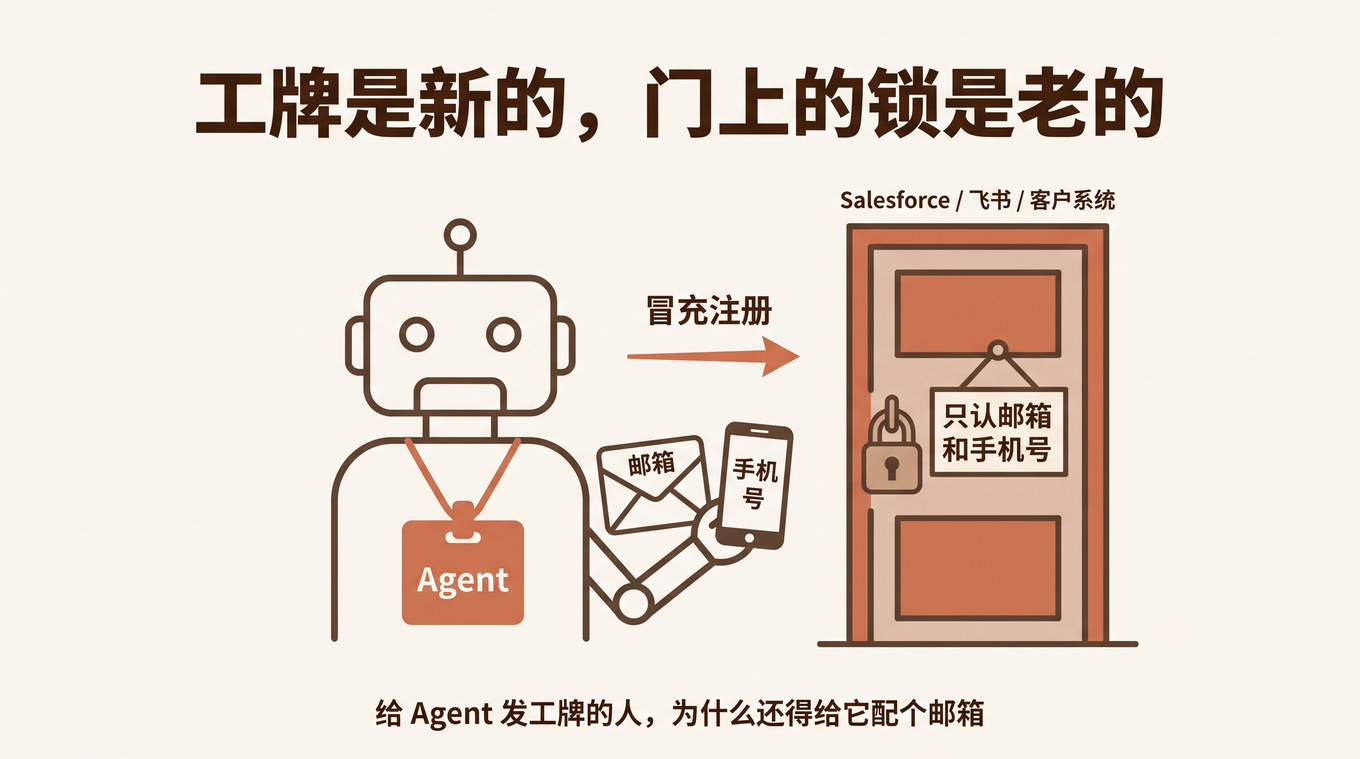
给 Agent 发工牌的人,为什么还得给它配个邮箱

The Agent Gets a Badge, but the Door Still Wants an Email

谢扬做了一个新产品叫 Qoni,定位是给 Personal Agent 用的身份基建。赛博禅心那篇报道的标题起得很准:给 Agent 发一张工牌。

思路我一看就熟。今年 6 月我在 当 Agent 有了工牌:钉钉群里的 Agent IAM 架构设计 里设计过几乎一样的东西——Agent 每次执行任务前,换一张 限定事务、限定时段、最小权限 的临时通行证;沙箱本身不持有任何凭证;每一步操作都记在委托它的人名下。Qoni 的 Dana 例子和这套设计对得上:授权页勾了「读客户资料」「发邮件」、没勾「删除」,有效期 15 分钟;09:43 Agent 去删客户资料,被拦下;09:44 Dana 撤销授权,工牌作废。

三个月后有人把我画在纸上的架构做成了产品,这是好事。 说明这个方向不是我一厢情愿。

但这篇报道里有一个细节,我读到时停了一下。它在「入职」那一节:

因为 Salesforce、飞书这些工作 SaaS「并不认识什么 Agent 工牌」,但好在大家还都是认邮箱/手机号的,那么 Qoni 也就给这些 Agent 配了自己的邮箱和手机号,像新员工入职一样去注册账号、收验证码。

给 Agent 发工牌的产品,为了让工牌真能用,做的第一件事是——给每个 Agent 再配一个邮箱和一个手机号。

这个动作里藏着整个 Agent 身份问题的死结,而几乎所有报道都滑过去了。

The Agent Gets a Badge, but the Door Still Wants an Email

[Read More]

通讯录不是人员列表,是企业本体的第一张骨架图

The Org Chart Is Not a Contact List, It Is the First Skeleton of Your Ontology

先说一类很常见的翻车现场。一个数字员工被问「把这份报销单转给张三的直属主管审批」,它很自信地查了通讯录,拿到一个名字,发过去了。结果那个人三个月前就调岗了,张三现在的主管是另一个人。报销单卡在一个已经不管这摊事的人那里,没人报错,日志全绿——只是这件事从此没人推进。

问题不在模型笨。模型很聪明,它把「查主管」这个动作完成得干净利落。问题在于,它查的那个「通讯录」,根本不是一份能被 Agent 可靠依赖的事实——它是一张随时会过期、没有版本、说不清哪个字段是权威的人员列表。

几个月前我在 Palantir 从本体长到 Agent,我们从 Agent 长回本体 里下过一个判断,下得很痛快:

Ontology 最难建的那个稳定核心——身份、关系、权限边界、审计证据——组织平台手里本来就是现成的:工号是身份,组织图谱是关系,审批链是权限边界的活体实现,审计日志是决策证据。

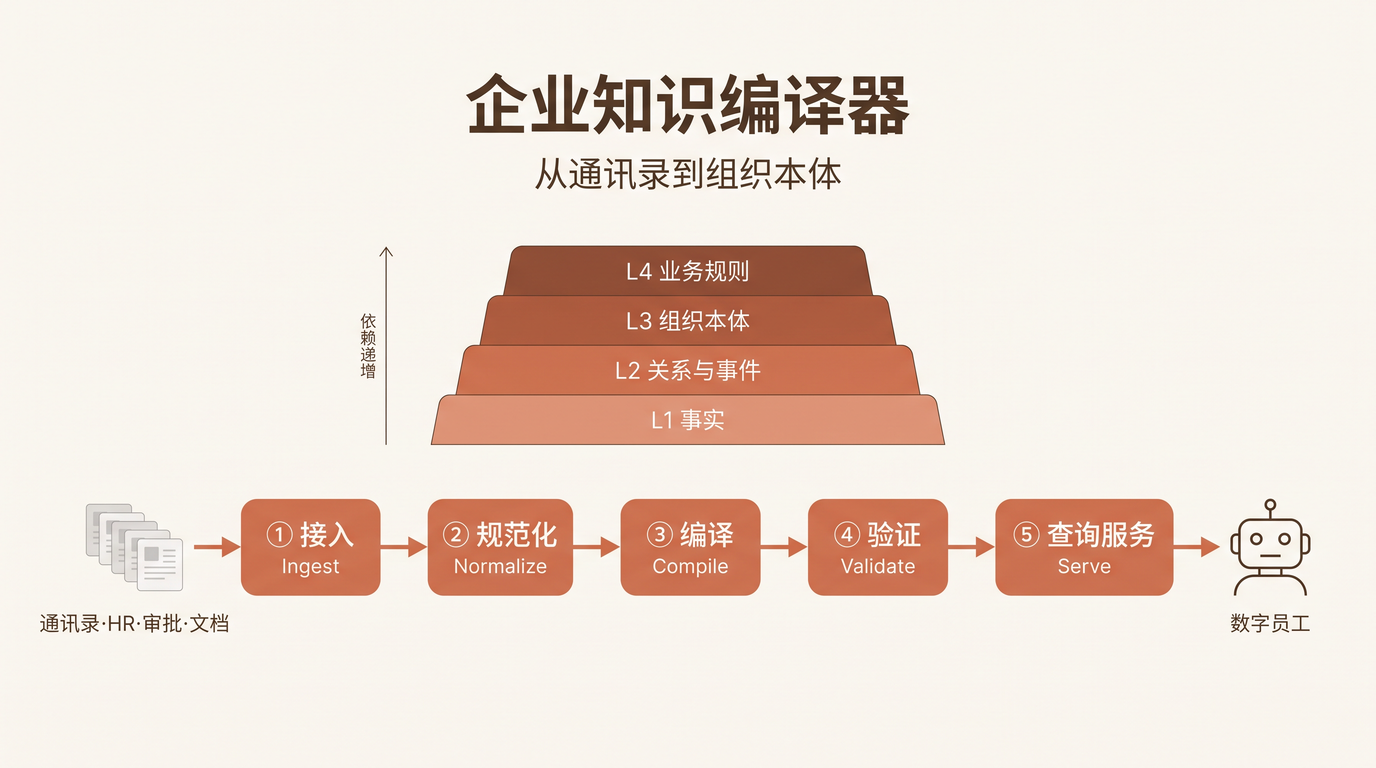
那篇讲的是路线:为什么组织平台可以反着走,先让 Agent 以数字员工的身份上岗,再从它的日常工作里长回本体。但路线讲完,有个工程问题被我一笔滑过去了——从钥匙串到本体,中间那道编译,具体怎么做?

「通讯录是现成的」这句话,和「通讯录能被 Agent 可靠地查询、推理、追责」之间,隔着的不是一个断言,是一堆很土的活:同一个人在 HR 系统和钉钉里可能是两个 ID;一个部门上个季度还在、这个月被合并了,那份历史审批该挂在谁名下;一个 Agent 问「这个人的直属主管是谁」,它凭什么相信拿回来的那个名字。开头那张卡住的报销单,就死在这堆活里。

这篇就把这道编译拆开写。核心判断只有一句:企业知识不是检索出来的,是编译出来的;而且要从最土的那一层开始编译——可验证的事实。

The Org Chart Is Not a Contact List, It Is the First Skeleton of Your Ontology

[Read More]

数字员工的活人感,一半是知道什么时候闭嘴

Half of Liveliness Is Knowing When to Stay Silent

我在一个业务群里看到过这样的三条消息,时间戳原样抄下来:

05:01  天刚亮,打个照面。
10:00  上午好,开工了,随时招呼一声。
10:00:55  本次执行已结束,但有消息是否送达尚未确认,请查看运行记录。
(群里没有任何活人发言)
# generated by hugo AI

发消息的是我们自己的数字员工。三条里没有一条错——问候很客气,状态提示很负责,措辞也没毛病。可我在屏幕这头看着,只觉得尴尬。

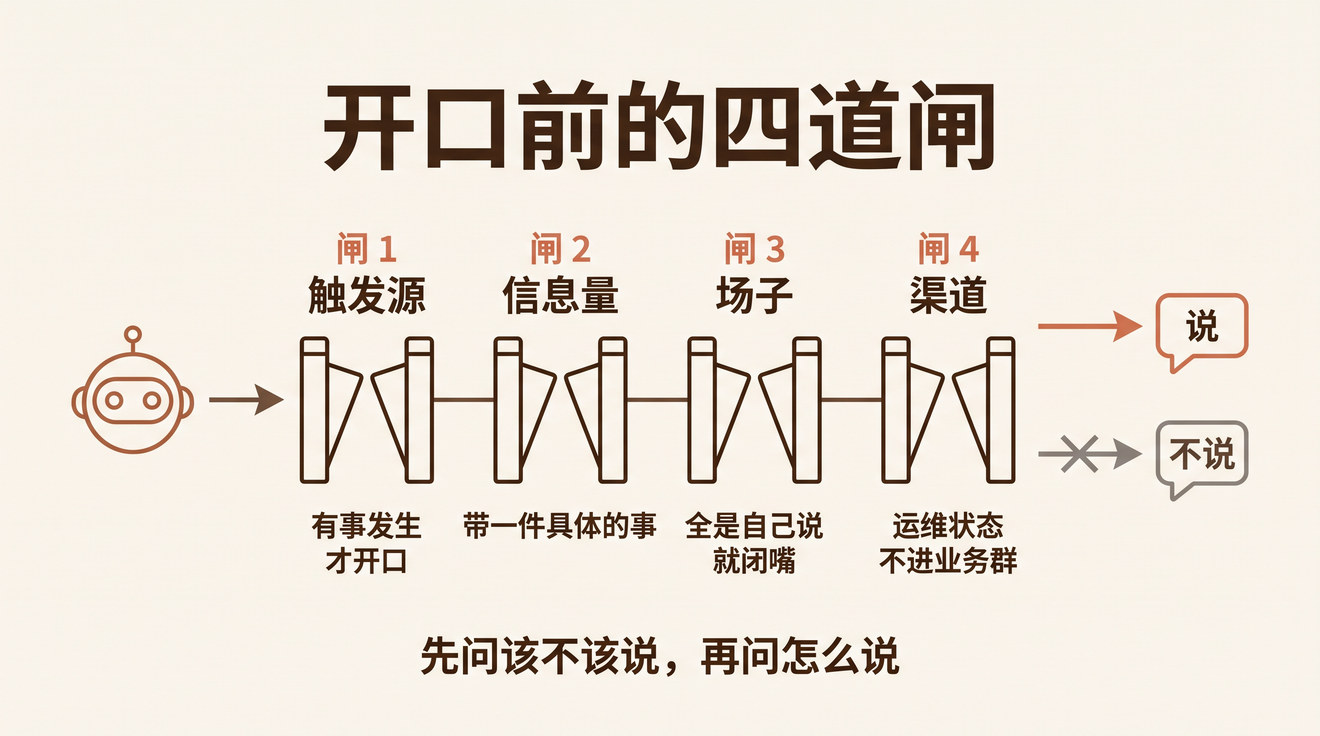
尴尬在哪,我想了几天才想清楚:05:01 那一刻,群里没有一个活人在。它不是在跟谁打招呼,它是在跟一个空房间打招呼。 而不到一分钟之后那条运行状态提示,等于它转过身,把后台日志贴到了业务群的公告栏上。

我在 数字员工的活人感,不是设计出来的,是长出来的 里写过:活人感不是皮肤,是行为,是「可验证的一致性」。那篇给了六条行为特征——记忆、主动性、边界、一致性、成长、节奏,又给了六个把它做出来的动作。但这三条消息让我发现那篇漏了一整维:特征和动作全是加法,没有一条讲什么时候该做减法。

这篇补上那一维。我的判断是:数字员工的活人感,一半来自它知道什么时候不说话。

Half of Liveliness Is Knowing When to Stay Silent

[Read More]

执行变便宜了,过滤器没有

Execution Got Cheap; Your Filters Didn't

OpenAI 负责 ChatGPT 与 Codex 的 Tibo Sottiaux(Codex 的创建者之一,现管 Core Products & Platform)在 The Pragmatic Engineer 的播客里描述了他自己现在的工作方式:开会开到一半想到一个问题,过去他会先记下来,回头找对应团队聊一聊;现在他直接拿起手机,把这个问题用语音说出去,扔给 agent 跑——用户反馈到底怎么样、哪些功能根本没人用可以砍掉、某个团队最近在忙什么。他说他遇到的大部分问题,三十分钟之内就能拿到第一版报告。

晚上没想完的事,他直接派 Codex 通宵去查,第二天早上起来看结果。周末做原型,用他自己的话说是「把想法从脑子里冲出去」,一天之内拿到反馈。

这些细节我核过一手字幕,都是真的。而真正让我停下来的是另一句——他说现在的情况是「突然有上百个 agent 在往同一个东西上贡献,而这可能在一个周末里就发生」。

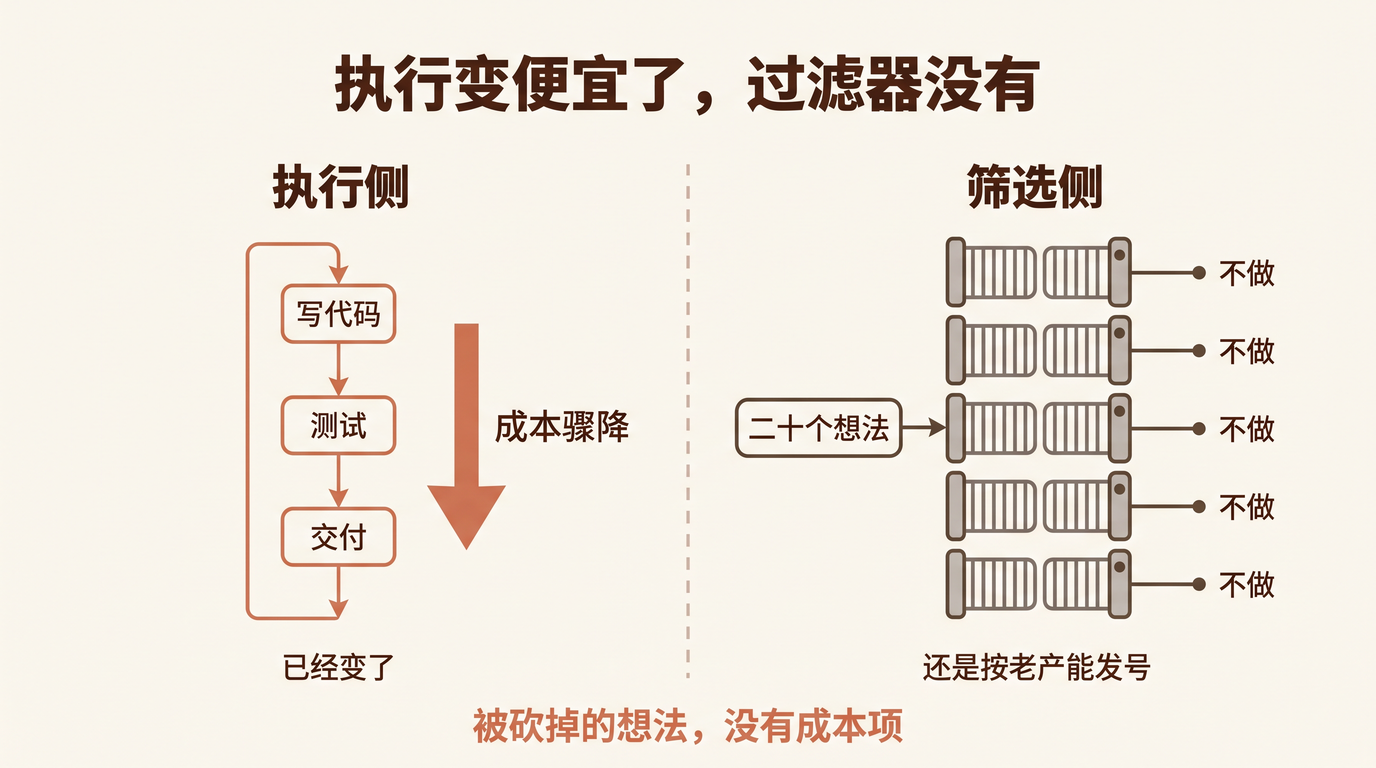
这句话的份量不在 agent 数量,在于它意味着:对他个人来说,执行配额已经不存在了。 他不需要排期,不需要申请,不需要说服任何人这件事值得做——想到就发出去,半小时后有结果。

那问题来了:为什么在他这样的公司里成立的事情,放到绝大多数公司里,一个想法从冒出来到被处理,还是要等三个月?

我的答案是:因为执行变便宜了,过滤器没有。

Execution Got Cheap; Your Filters Didn’t

[Read More]

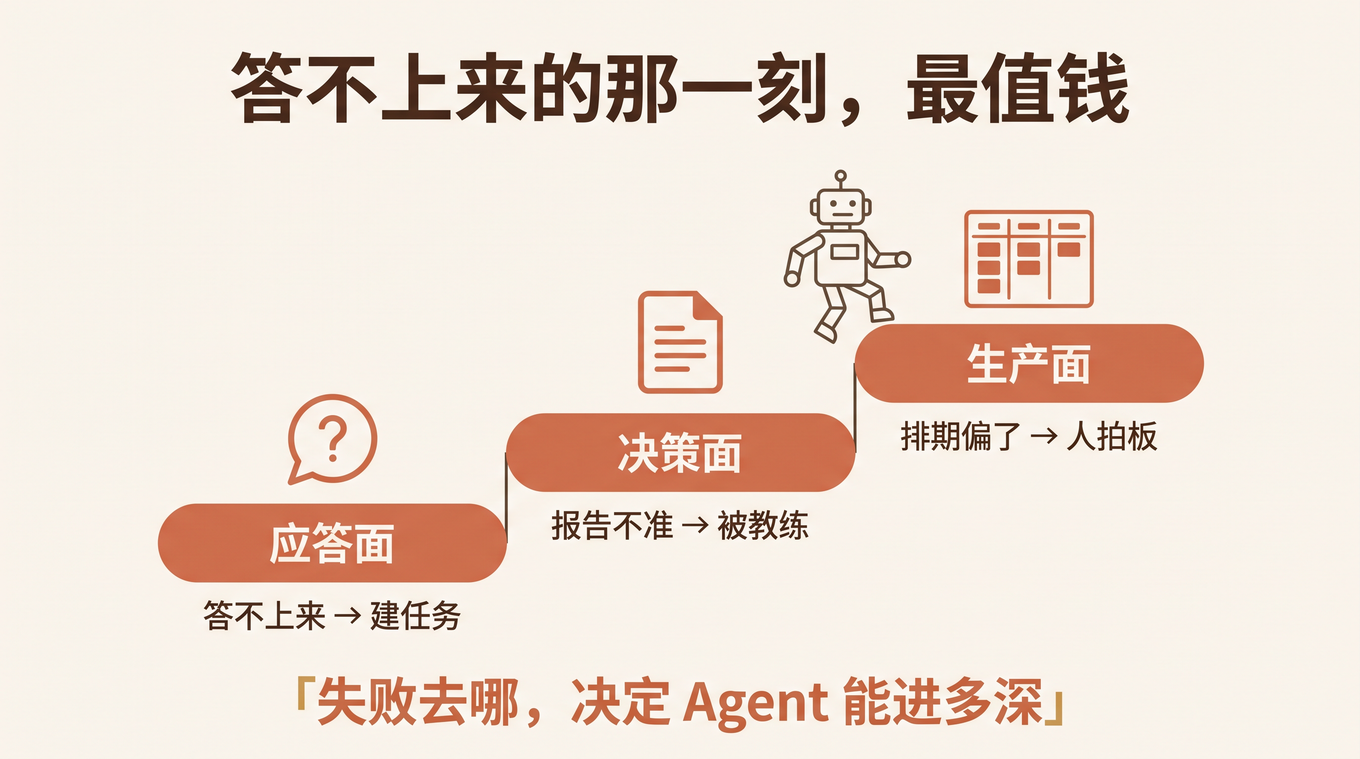
数字员工答不上来的那一刻,最值钱

The Most Valuable Moment for an AI Teammate Is When It Cannot Answer

Asana 的销售和客户成功人员有一个共享 Slack 频道,专门问产品问题。新功能不断发布,同样的问题被反复提出,每次都要 @ 一位领域专家。他们想过建可搜索的知识库,结论是不可行——用他们首席产品官 Arnab Bose 的原话说:「答案很微妙、而且会变化,你需要有人对『产品当前状态』做出带品味的判断。」

现在这个频道里有一个 Asana 应用,把每个问题转成任务,交给一个 Agent 接手。大多数人介绍这个案例时,讲的是它答得多好。我读了 Claude 官方博客这篇访谈(2026-09-29,「构建人机协作团队」系列第三篇),读出来的是另一件事:这个 Agent 最值钱的设计,是它答不上来的时候会发生什么。

它有两种「答不上来」,每一种都有一个出口:没有获批口径、且问题暴露了产品缺口,它会在产品团队的受理项目里建一条任务,进 backlog;同一个问题反复出现、它反复贴同一条记录,它会建一条任务,让赋能团队去更新培训材料和文档。失败不蒸发,不硬答,全部变成结构化的组织信号。

这一刻,Agent 从一个应答机器,变成了一个组织缺口探测器。

The Most Valuable Moment for an AI Teammate Is When It Cannot Answer

[Read More]

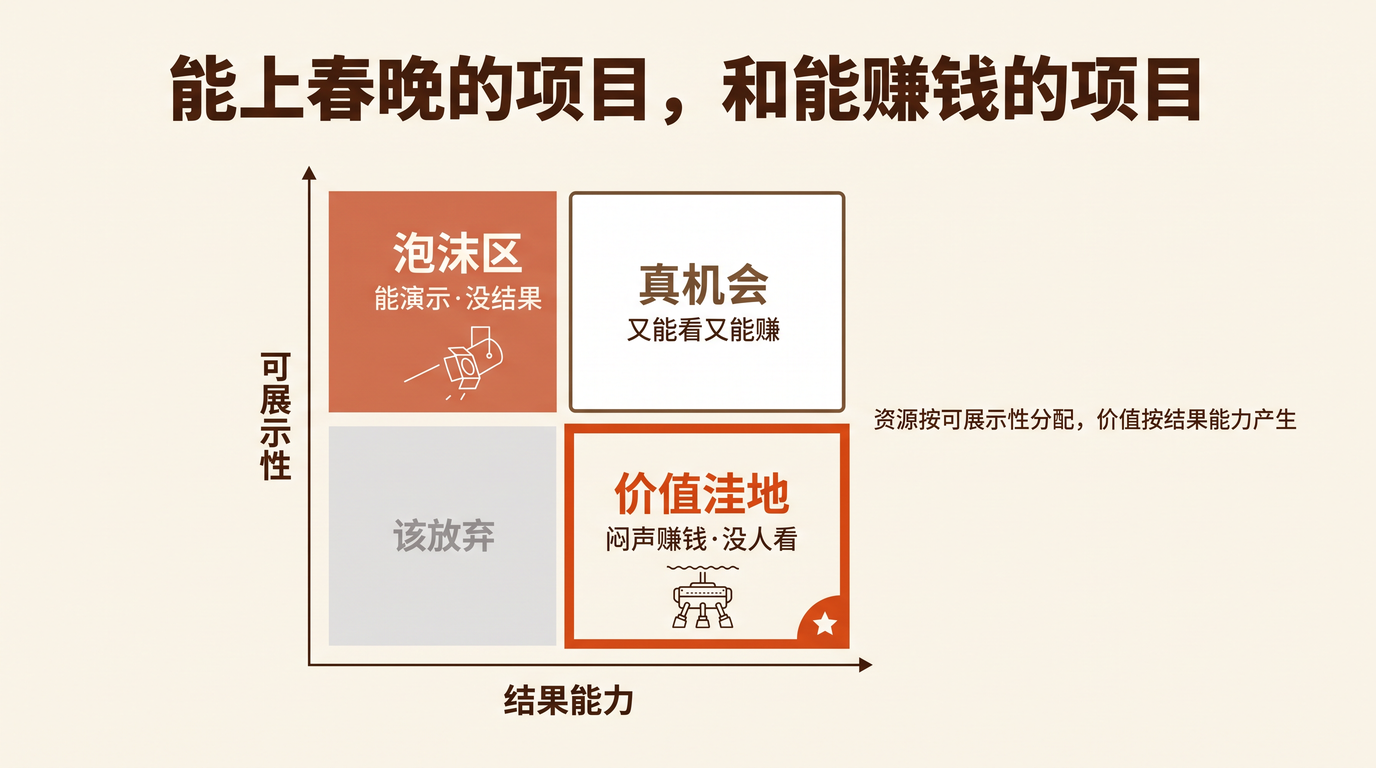
能上春晚的项目,和能赚钱的项目

The Demonstrability Bias: Why the Best Investments Often Make Bad Demos

朱啸虎讲过一个他亲手投过的反例。

一家公司,专门派机器人在海底洗船。商业化做得非常好——客户真金白银付费,订单扎实,水下泛化还容易:洗船、洗海上光伏柱子、港口清淤、帮海关查走私(走私分子把货藏在船底,以前要潜水员下去抽查,机器下去就容易多了)。

但朱啸虎说,这家公司有个致命问题:它没法展示。它在海底洗船,根本没办法展示给别人看,能看到的场景很有限。

而同一时期,人形机器人赛道有近 200 家公司挤在一起,彼此差异极小,真实商业化订单稀薄(大部分是政府订单或科研订单),宇树的估值却冲到 4000 亿。朱啸虎的原话很直接:「因为故事好讲。上春晚这种活动,人形机器人的可展示性非常高。很多投资人更喜欢看到这种高度可展示性的东西。」

一家在海底默默赚钱、估值便宜;一群在台上翻跟头、估值冲天。区别不在谁更能创造价值,而在 谁能被看见。

这就是我今天想讲的东西:可展示性偏差——资本、注意力、资源,正在系统性地流向「能演示给人看」的项目,而不是「能产生结果」的项目。

The Demonstrability Bias: Why the Best Investments Often Make Bad Demos

[Read More]

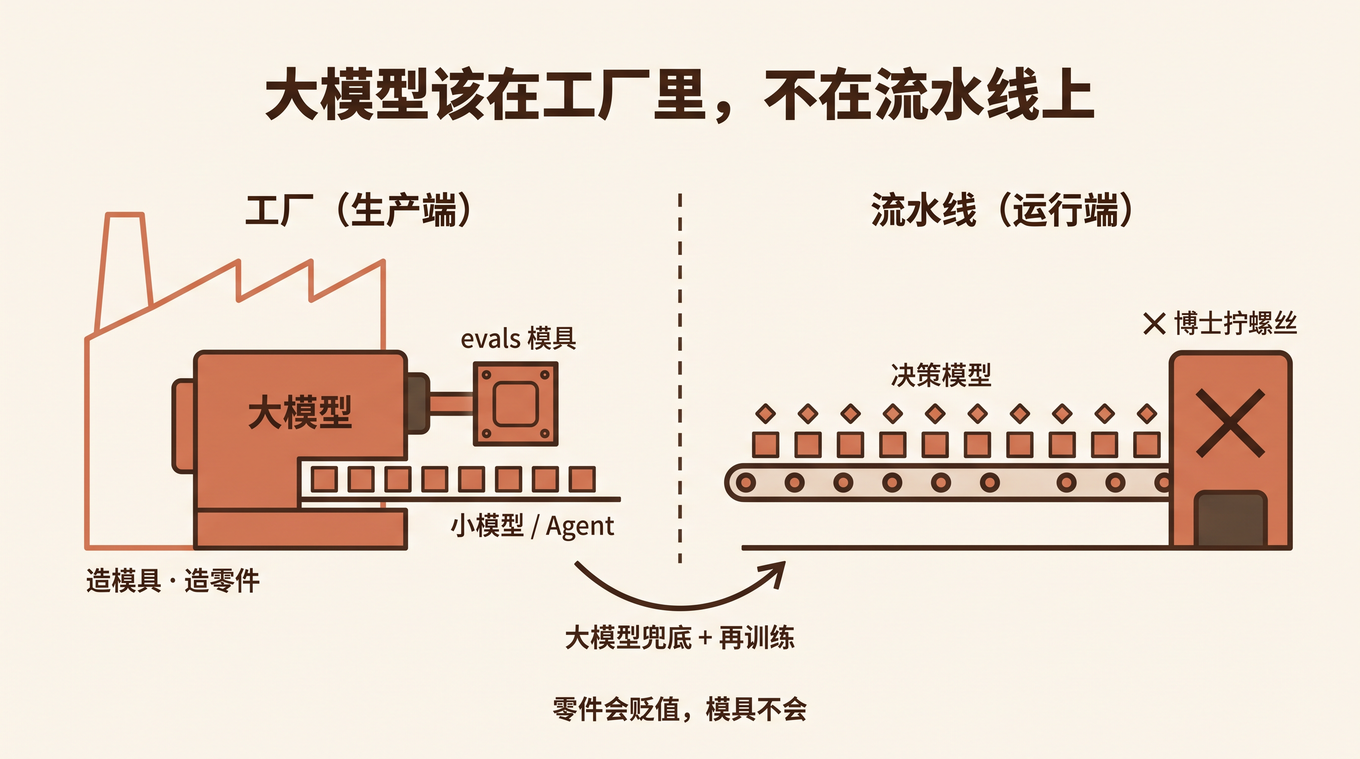
大模型该在工厂里,不在流水线上

The Frontier Model Belongs in the Factory, Not on the Line

9 月中旬,一家叫 TypeSafe AI 的公司出隐身。创始人 Diogo Almeida 是 RLHF/InstructGPT 的共同发明人,GPT-4 致谢名单里有他的名字——可以说,是他教会了大模型「说人话」。而他隐身两年后发布的产品,却出人意料:一个不会说一句话的模型。

这个模型叫 Jev,定位「决策模型」:输入任意状态和预定义的问题,输出只有三种——选择题、打分、是非题,每个都附带校准过的置信度。口号只有三个词:Decisions, not strings(要决策,不要字符串)。输入 $0.042/百万 token,输出免费,端到端 70–500 毫秒。

市场反应激烈:发布帖 420 万浏览,5 天撤掉 waitlist 全面开放,browser-use 团队次日开源集成(仓库已 12.5k 星),Vercel、OpenRouter、LangChain 一周内全部上架,连蹭热度的 memecoin 都出现了。

一个「不会说话」的模型,凭什么这么火?

因为它赌对了一件事:大模型的岗位不在每一次调用里,而在调用背后——大模型该在工厂里,不在流水线上。

The Frontier Model Belongs in the Factory, Not on the Line

[Read More]

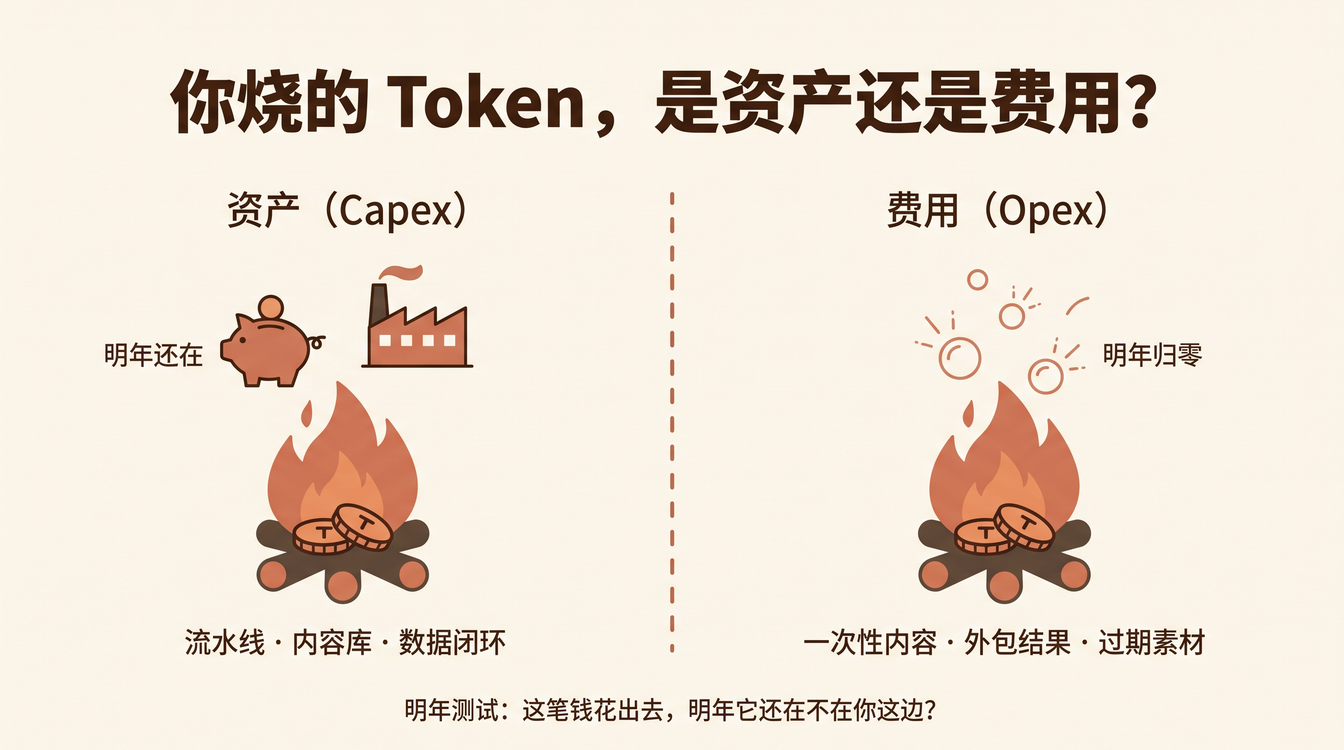
你烧的 token,是资产还是费用?

Capex or Opex: The Next-Year Test for Every AI Dollar

在《当智能变得免费,什么东西在涨价》里,我拆了那张「AI 无法低成本复制什么」的环图。顺着这个题目继续想,想到一个更落地的对比:

企业花钱买 AI,是为结果买单;个人花钱买 AI,是提效给自己赚钱。

两句话听起来是同一件事的两面。但放到账本上看,是两种完全不同的账——而且大多数人把自己的账记错了。

Capex or Opex: The Next-Year Test for Every AI Dollar

[Read More]