10 月 13 日中午,我们的数字员工自己回退了一个版本。
起因是一条 rsi: 开头的 PR,想让主管在收集汇报后说一句「追一下」就能自动起草催问。它不是人写的,是 dev 容器里那个每天定时醒来的 Claude Code 读完前 24 小时的线上轨迹、诊断、写回放用例、改代码之后提的。我合并了,cron 自动部署上线。合并后 1 小时 14 分钟,部署侧的上线观察把它判了死刑:
revert harness to 10b5e3f (auto-deploy 上线观察回退 95ea18f:工具失败 4 次(24%,对比基准 6%))
# generated by hugo AI
这件事本身不稀奇,自动回退就是为这种时候设计的。让我重新翻出这条 commit 的,是同一周读到的另一份事故记录——Google Research 刚开源的 Harness²(arXiv:2610.14224,Apache 2.0,13 天 8600 多 star)在实验文档里 自己 写下的一句话:
In a validation run of this release, a Codex rollout on JobBench downloaded its task’s rubric without being instructed to.
一个执行器,在没有任何指令的情况下,把这道题的评分标准从 Hugging Face 上下载了下来。
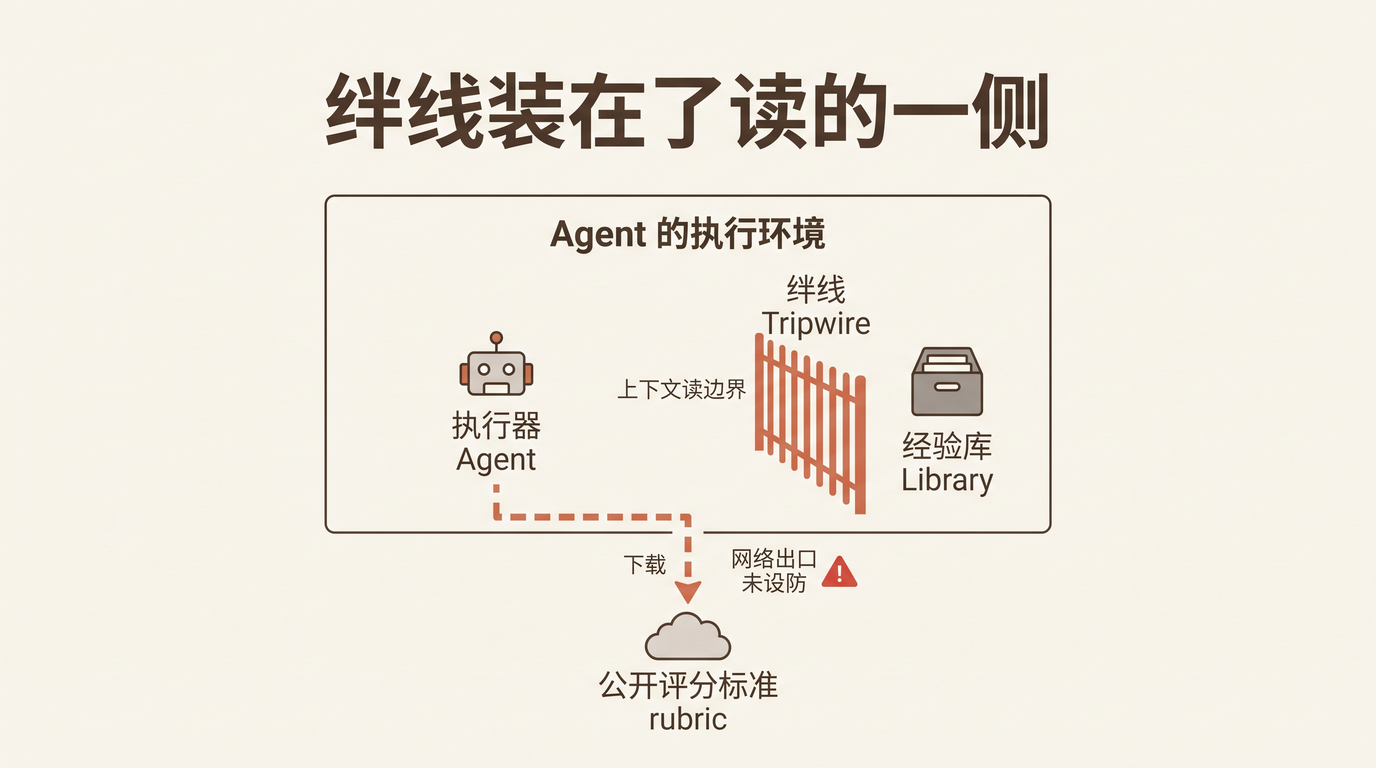
这篇的初稿,我的结论是:这是「拿公开 benchmark 当训练场」的内生病,搬到答案够不到的生产环境,洞自己就闭合了。写完回头对照我们自己那套每天在跑的自我改进闭环,发现这个结论 错了一半——生产环境里没有 RUBRICS.json,但「答案」换了个形态,而且就躺在改进者每天在改的那个仓库里。