大模型该在工厂里,不在流水线上

The Frontier Model Belongs in the Factory, Not on the Line

9 月中旬,一家叫 TypeSafe AI 的公司出隐身。创始人 Diogo Almeida 是 RLHF/InstructGPT 的共同发明人,GPT-4 致谢名单里有他的名字——可以说,是他教会了大模型「说人话」。而他隐身两年后发布的产品,却出人意料:一个不会说一句话的模型。

这个模型叫 Jev,定位「决策模型」:输入任意状态和预定义的问题,输出只有三种——选择题、打分、是非题,每个都附带校准过的置信度。口号只有三个词:Decisions, not strings(要决策,不要字符串)。输入 $0.042/百万 token,输出免费,端到端 70–500 毫秒。

市场反应激烈:发布帖 420 万浏览,5 天撤掉 waitlist 全面开放,browser-use 团队次日开源集成(仓库已 12.5k 星),Vercel、OpenRouter、LangChain 一周内全部上架,连蹭热度的 memecoin 都出现了。

一个「不会说话」的模型,凭什么这么火?

因为它赌对了一件事:大模型的岗位不在每一次调用里,而在调用背后——大模型该在工厂里,不在流水线上。
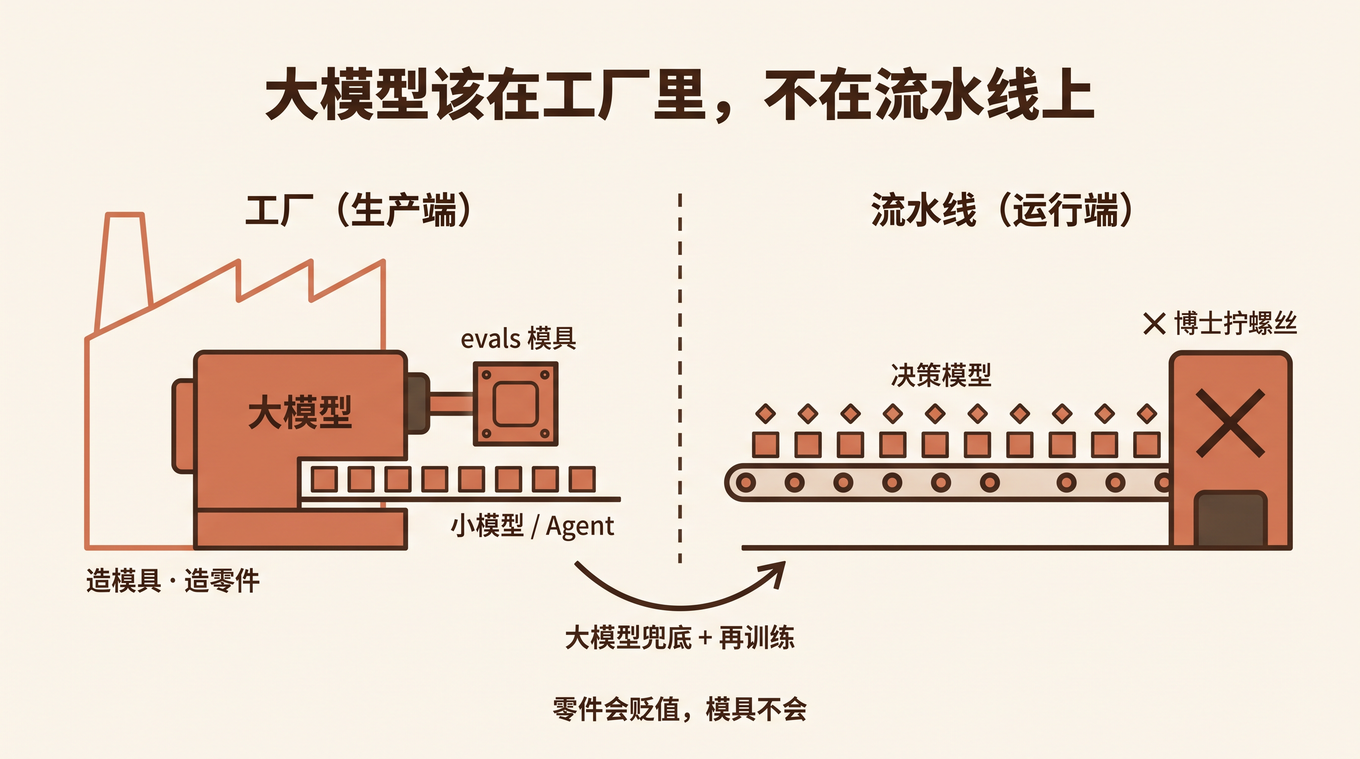
The Frontier Model Belongs in the Factory, Not on the Line

[Read More]

历史是极好的律师,极差的法官

History Is a Brilliant Lawyer but a Terrible Judge

1965 年 2 月 7 日凌晨,越共袭击了美军波来古基地,八名美国人丧生。几个小时内,国家安全顾问邦迪把一份备忘录推到约翰逊总统面前:持续报复。3 月 8 日,三千五百名海军陆战队员在岘港登陆。美国全面卷入越南战争,就是这么开始的。

值得注意的不是这个决定,是他们的推理方式。那间屋子里的人,被当时的媒体称为「最聪明的一代」。他们没有忽略历史——恰恰相反,他们是被历史喂得最透的一代人。会议上,洛奇大使明确援引 1938 年的慕尼黑协定,把胡志明的推进类比成希特勒的推进;后来学者在《Analogies at War》(普林斯顿大学出版社,1992)里复盘,在场的高级决策者们,包括邦迪,都确信这个类比是恰当的。肯尼迪本人大学时写过批评英国绥靖政策的荣誉论文,后来出版成书,书名就叫《英国为何沉睡》。「慕尼黑的教训」不是他们的盲区,是他们最深的信念。

十年之后:五万八千多名美军士兵、数百万越南人的生命、美国历史上最糟糕的一场对外战争。

最认真的历史类比,产出了最坏的决策之一。这不是要论证「历史没用」——恰恰相反,这篇要说的是,历史对大模型的价值极大,在训练和推理两端都是。但波来古之后那间椭圆办公室里的场景,指向我真正想讲的判断:历史是极好的律师,极差的法官。 而且它背后还有一个更反直觉的悖论:决策越大,历史的证据效力越弱。

History Is a Brilliant Lawyer but a Terrible Judge

[Read More]

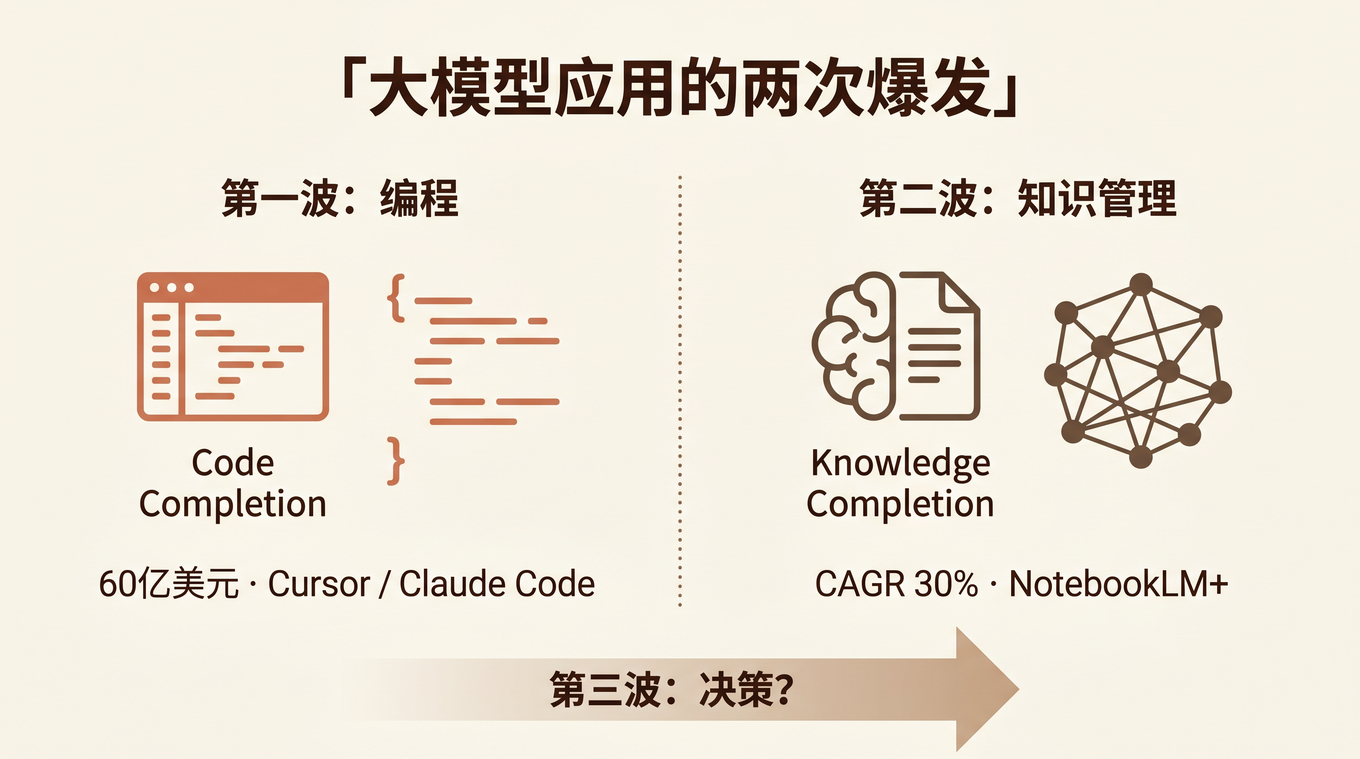
继编程之后,大模型应用的下一个爆发场景是知识管理

Why Knowledge Management Is the Next Billion-Dollar AI Application After Code

上周五晚上,我让 AI 帮我做一件事:把过去三个月收集的 47 篇关于 Agent 架构的文章、12 段会议笔记、和 6 个项目的 README,整理成一份「哪些架构模式真正有效」的判断。

如果是一年前,我会得到一份按关键词频率排列的摘要——看起来专业,实际上没用。

但这次不同。AI 花了大约 40 秒,输出了一份结构清晰的报告:哪些模式在多个项目中反复出现、哪些只在特定场景下有效、我的笔记里对同一问题有过矛盾的判断。它甚至指出了我在三月份写的一段话和五月份的一个项目决策之间的矛盾。

这不是搜索,不是摘要,不是 RAG 的简单检索。这是 理解。

编程让 AI 学会「写」,知识管理让 AI 学会「理解」

[Read More]

悟空技巧七:工具协同,让 AI 从「聊天」走向「行动」

Wukong Tip #7: Tool-Augmented Prompting for Actionable Workflows

你让悟空对比两个刚发布不久的开源框架,它自信满满地输出了三千字分析,但你一查官网,发现核心特性全是幻觉;你让它分析一份 CSV 销售数据,它用纯文本「心算」了一堆增长率,结果和你用 Excel 拉出来的数字对不上;你让它帮你建一个钉钉待办,它给你写了一段完美的 API 调用建议,但就是没真正执行。

不是 AI 不够聪明,是你只给了它「大脑」,没给它「双手」。

在前面的六篇文章中,我们解决了需求澄清、流程拆解、交付标准、风格对齐、迭代反馈和上下文稳定性。但这些技巧都聚焦在纯文本交互层面。

当任务涉及实时信息、精确计算、外部系统操作时,纯 LLM 推理会遇到物理天花板:知识截止、数学弱项、无执行环境。此时,继续用「聊天」模式硬扛,只会得到看似专业实则不可用的结果。

今天,我们探讨技巧七:如何通过「工具协同」,显式调度 AI 的外部能力,让协作从「对话建议」升级为「端到端执行」。

[Read More]

悟空技巧三:示例驱动,用 Few-shot 对齐 AI 输出标准

Wukong Tip #3: Example-Driven Prompting for Style and Quality Alignment

当你对 AI 说「用 Pythonic 的方式写」或「写一封委婉的拒绝邮件」时,AI 对「Pythonic」和「委婉」的理解可能和你完全不同。

标准不明确,是 AI 协作中另一个常见的效率杀手。

在 悟空技巧一:让 AI 向你提问 中,我们解决了需求模糊的问题;在 悟空技巧二:交付物先行 中,我们解决了格式返工的问题。今天,我们聚焦第三个维度:如何通过「示例驱动」,解决「风格不对齐」和「质量不可控」的问题。

[Read More]

悟空技巧九:多 Agent 协同,从单兵作战到虚拟团队

Wukong Tip #9: Multi-Agent Orchestration for Complex Workflows

当你让悟空独立完成一份「系统架构设计方案」时,它可能会给出一个逻辑自洽但缺乏安全视角的方案;当你让它写一段核心业务代码时,它可能实现了功能但忽略了边界条件和性能瓶颈。

不是 AI 不够强,而是你试图让一个「通才」包揽所有「专才」的工作。

在前面的八篇文章中,我们构建了从 需求澄清、分步执行、交付物定义、示例对齐、迭代优化、上下文管理、工具协同 到 工程化封装 的完整单 Agent 技巧体系。

但真实世界的复杂项目,从来不是靠一个人单兵作战完成的。架构师设计、安全专家审查、运维评估成本、开发落地实现、测试保障质量——职责分离与交叉验证,是工程质量的基石。

今天,我们探讨技巧九:如何通过「多 Agent 协同」,将单一 AI 实例编排为虚拟专家团队,实现从「个人效率」到「系统架构」的维度跃迁。

[Read More]

悟空技巧二:交付物先行,先定义格式再生成内容

Wukong Tip #2: Deliverable-First Prompting for Zero-Rework Output

你在用悟空(或其他 AI 助手)时,是否经常遇到这样的场景:

你让 AI 写一份技术方案,它洋洋洒洒写了三千字,但你只想要一张对比表格;你让 AI 写周报,它给你堆砌了一堆「积极推进」「大力支持」的空话,你不得不逐句删改换成数据。

内容质量没问题,但交付物不可用。

这是 AI 协作中最隐蔽的效率杀手。很多人以为 AI 不够聪明,其实是你没有给它明确的「交付标准」。

在 悟空技巧一:让 AI 向你提问 中,我们讨论了如何通过提问澄清来解决「需求模糊」的问题。今天,我们聚焦另一个维度:如何通过「交付物先行」,解决「格式返工」的问题,让 AI 的输出复制粘贴就能用。

[Read More]

悟空技巧五:迭代优化,用结构化反馈替代「重写」

Wukong Tip #5: Iterative Refinement with Structured Feedback

AI 第一次输出往往只有 70-80% 可用。

大多数人的本能反应是:「不对,重写」 或 「再优化一下」。

这种模糊反馈会导致两个致命问题:

  1. 全盘重生成:AI 会丢弃原本写对的部分,重新抽样,导致「好的没留住,坏的没修好」。
  2. 指令漂移:缺乏具体修改锚点,AI 只能靠猜测调整,越改越偏离预期。

在前面的四篇文章中,我们构建了从 需求澄清、分步执行、交付物定义 到 示例对齐 的完整工作流。

今天,我们补齐最后一块拼图:当 AI 首次输出不完美时,如何通过「迭代优化」,用结构化反馈精准推到 100%,完成从「可用」到「完美」的最后一公里。

[Read More]

悟空技巧八:提示词工程化,把个人经验变成团队资产

Wukong Tip #8: Prompt Systematization and Team Asset Management

你花了两周时间,终于摸索出了一套让悟空写技术方案「一次可用」的 Prompt 组合:包含提问澄清、交付物定义、示例对齐和工具调度。你觉得自己简直是 AI 协作大师。

但当你把这套方法推荐给团队时,发现大家根本用不起来。

  • 同事 A 嫌每次都要复制粘贴一大段约束太麻烦,干脆还是用最原始的「帮我写个方案」。
  • 同事 B 漏掉了关键的示例部分,导致输出质量参差不齐。
  • 同事 C 遇到新场景,不知道如何调整 Prompt,只能重新从零摸索。

个人用得好,不等于团队用得好。

在前面的七篇文章中,我们构建了从 需求澄清、分步执行、交付物定义、示例对齐、迭代优化、上下文管理 到 工具协同 的完整个人技巧体系。

但这些技巧如果只停留在你的大脑或剪贴板里,它们就是易失的、碎片化的、不可复用的。

今天,我们探讨技巧八:如何通过「提示词工程化」,把个人经验沉淀为参数化模板和团队 SOP,实现 AI 协作的工业化生产。

[Read More]

悟空技巧六:上下文管理,用「状态控制」避免长对话退化

Wukong Tip #6: Context Management for Long-Session Stability

你是否经历过这样的崩溃时刻:

在同一个悟空对话窗口里,你们已经并肩作战了 30 轮。前 10 轮它聪明绝顶,精准理解你的架构约束;到了第 20 轮,它开始偶尔犯低级错误,把已经否决的方案重新提出来;到了第 30 轮,它彻底「失忆」,遗忘了最早约定的错误处理规范,甚至开始输出车轱辘话和幻觉。

你以为是 AI 变笨了,或者是模型抽风了。

其实不是 AI 能力下降,而是它的「内存」爆了。

在前面的五篇文章中,我们构建了从 需求澄清、分步执行、交付物定义、示例对齐 到 迭代优化 的完整单次任务工作流。

但实际工作中,我们经常在同一个会话里连续处理多阶段任务。此时,一个隐蔽但致命的现象会出现:上下文污染与注意力衰减。

今天,我们探讨技巧六:如何通过「上下文管理」,像管理内存一样管理对话状态,确保长周期协作的稳定性。

[Read More]