大多数企业 AI 的终点是人,Palantir 的终点是业务

Most Enterprise AI Ends at a Human — Palantir's Ends at the Business

上周,我翻我们数字员工的一条真实执行链路:一条消息进来,Agent 理解意图,调用 dws 能力执行,结果回到钉钉。全程没有「人看报表」这一环——数据的终点不是被谁看见,而是业务本身被改变。

这条链路短到不起眼。但它让我意识到,自己正在做一件大多数企业 AI 还没做成的事——同一时间,绝大多数企业的 AI 项目,正卡在「把结果给人看」这一步出不来。

最近读到「森林瀑布」的一篇长文《Palantir 还是太全面了》,把 Palantir 的官网和产品文档逐页扒了一遍。文章里有一句话,我认为点破了企业 AI 的分水岭:

「AI 到底连接到了什么。如果 AI 连接的只是一个搜索框,它还是聊天机器人。如果 AI 连接的是企业 Ontology、业务规则、Action 和真实业务系统,它才真正开始进入企业的操作层。」
[Read More]

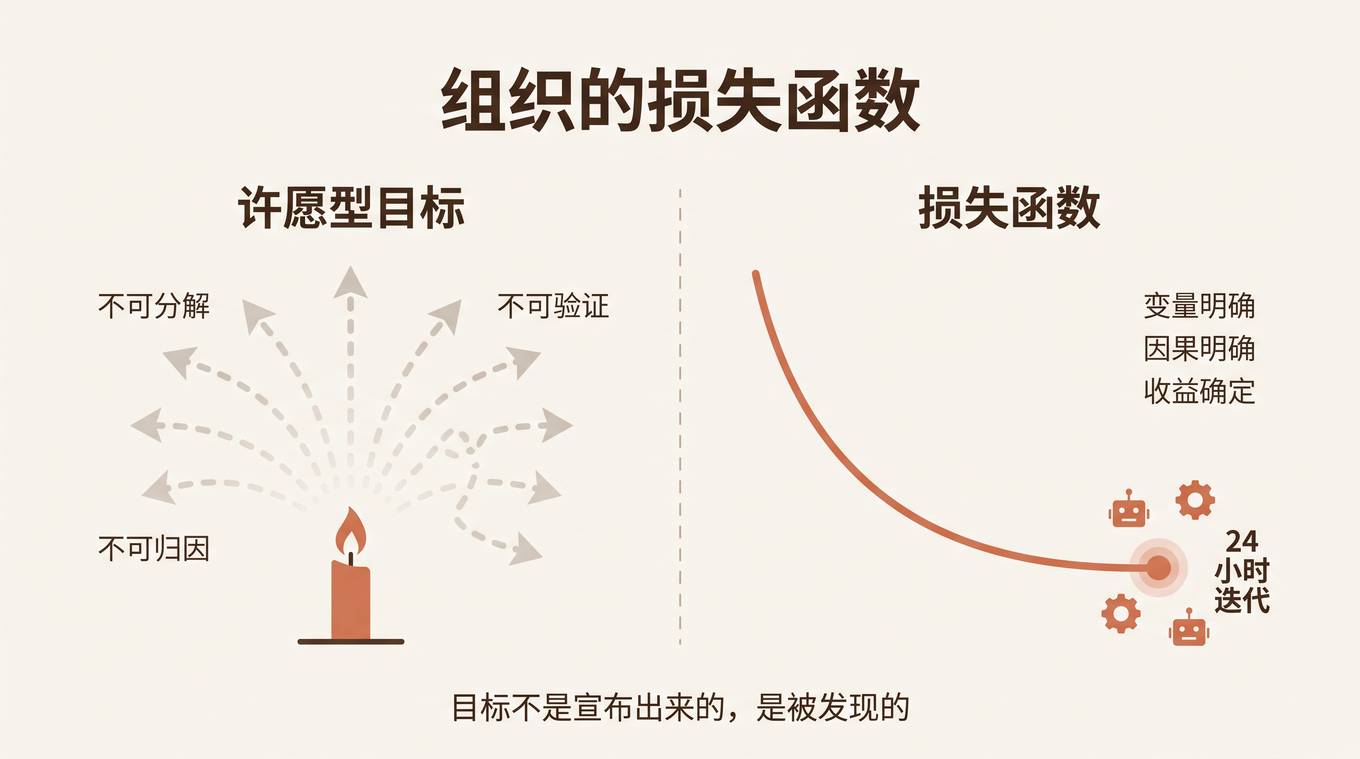
组织的损失函数:为什么你的 OKR 只是许愿

Your OKRs Are Just Wishes: What Organizations Really Need Is a Loss Function

和朋友讨论组织的 AI 化时,有一句话点破了本质:

「训练过模型的人都懂:损失函数错了,训练步数越多,跑得越偏。」

组织也一样。目标错了,团队越勤奋,死得越快。

训练速度从来不是问题,梯度方向才是。而大多数组织最大的危机是:它们从未认真检查过,自己正在优化的那个东西,到底是一个目标,还是一个愿望。

Your OKRs Are Just Wishes: What Organizations Really Need Is a Loss Function

[Read More]

Eval 是品位

Evals Are Taste

上周发完 一切皆插件:DeepSeek Harness 的野心与收敛鸿沟,一位带研发团队的读者给我发消息:「十次修改能不能收敛,你说取决于 eval。那我们让团队多写点测试用例,是不是就能收敛了?」

「多写点测试」是标准答案,也是错误答案。

它错在把 eval 当成一个纯的工程问题——好像数量上去了,收敛自然就来。但真正决定收敛的,不是 eval 有多少,而是 eval 集长什么样。而 eval 集长什么样,取决于一个更不好量化的东西。

品位。

Evals Are Taste

[Read More]

Evals 是新的 PRD

Evals Are the New PRD

上个月,我们团队一位产品经理花了两周写了一份 40 页的 PRD,描述一个智能审批 Agent 的需求。用户故事、流程图、异常分支、验收标准,写得滴水不漏。

她把 PRD 丢给 Coding Agent,说:「按这个做。」

三天后 Agent 交付了。代码能跑,测试通过,接口对齐。但她试了五分钟就皱眉:「这不是我要的东西。」

哪里不对?她说不清。审批流程是对的,权限校验是对的,消息通知是对的。但 Agent 处理「领导已读不回超过 48 小时」的策略,不是她脑子里想的那个。PRD 里写的是「超时后自动提醒」,Agent 就老老实实给所有超时审批发了一轮提醒——包括那些「领导出差没看手机」的非紧急件。她真正想要的是「先判断这条审批是否紧急,紧急的才提醒,不紧急的等下次汇总」。

这个判断,她没写进 PRD。因为她觉得这是「常识」。

Agent 没有常识。Agent 只有你给它的判据。

Evals Are the New PRD

[Read More]