Anthropic 在 10 月 7 日发布了 Claude Haiku 5.5。我盯着官方那张 benchmark 表看了一会儿,目光没停在新一代的分数上,而是停在了它旁边那一列——上一代 Haiku 4.5。
那一列有几个数字很刺眼:
                        Haiku 4.5    Haiku 5.5
Terminal-Bench 4.0        0.0%   →    39.2%
OSWorld 2.1(离线子集)    15.7%   →    72.4%
Humanity's Last Exam      10.2%   →    45.9%
Chartography               6.4%   →    46.4%
# generated by hugo AI
Terminal-Bench 4.0,0.0%。
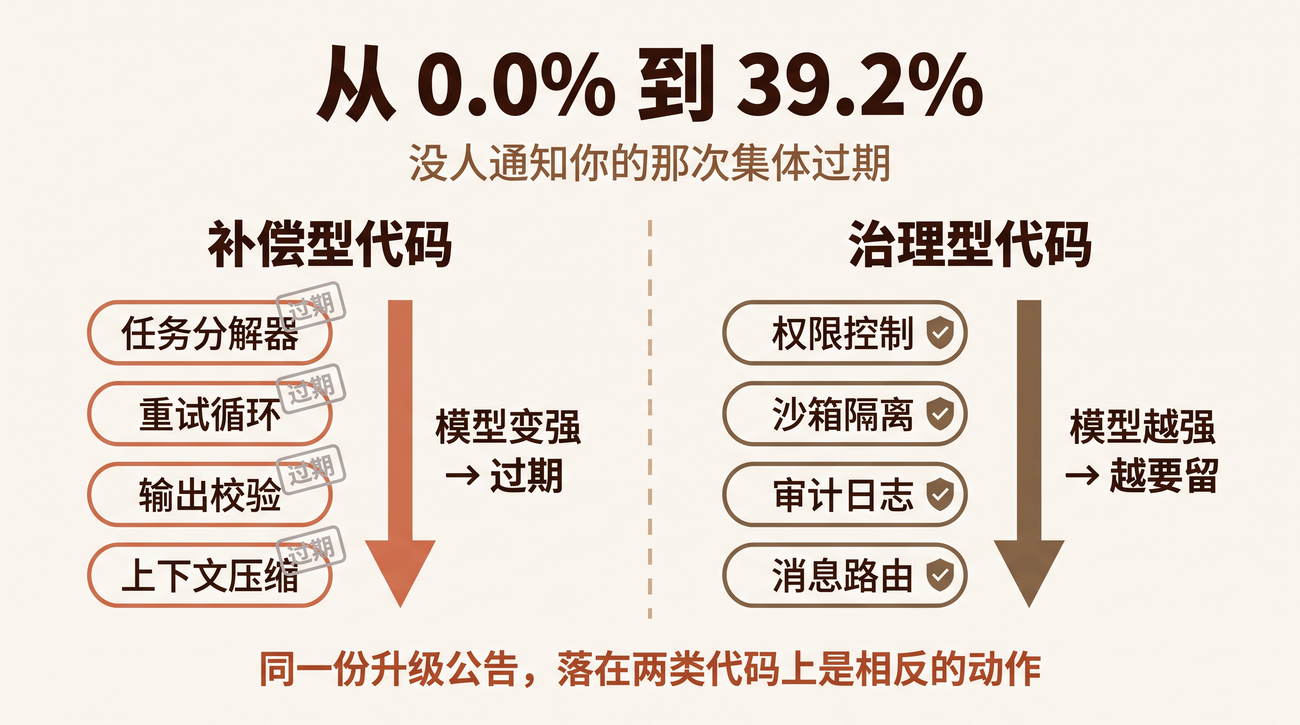
这不是「差一点」。0 分意味着这个模型在 agentic 编码任务上 系统性失灵——不是偶尔做错,是几乎做不出任何一个能通过的任务。任何一个去年拿 Haiku 4.5 做过 agent 的工程师都知道,面对一个 0 分的模型,你不可能靠改 prompt 让它跑通。你只能靠工程去兜:把任务拆得更碎、加重试、加多轮自我修正、加输出校验、加人工检查点。
而这一次升级,那个 0.0% 变成了 39.2%。
我第一反应不是「新模型真强」。我第一反应是:过去一年里,所有人为「Haiku 做不到」而写的那些补偿代码,从 10 月 7 日起,集体变成了负资产——而且没有任何人会收到通知。