从程序编译器到企业上下文编译器

From Program Compiler to Enterprise Context Compiler

昨天那篇 每天 1000 条钉钉消息,我让一个 Agent 先编译再开口 是从一个 ❌ 开始的:我在单聊里问一位同事某件事要不要先做,他回了四个字「今天弄好」;5 分钟后,我的工作助理 Muse 把这句话当成急事推给了我——而我 7 分钟前就在和他聊这件事。

那次修的是推送时机。但这四个字之后一直在我脑子里,因为它暴露了另一个问题:同一件事,在我的台账里是「等别人交付」,在他那边是「我要办」。 Muse 只编译了我这一半。他那一半在他脑子里、在他的待办里,或者哪儿都没有。

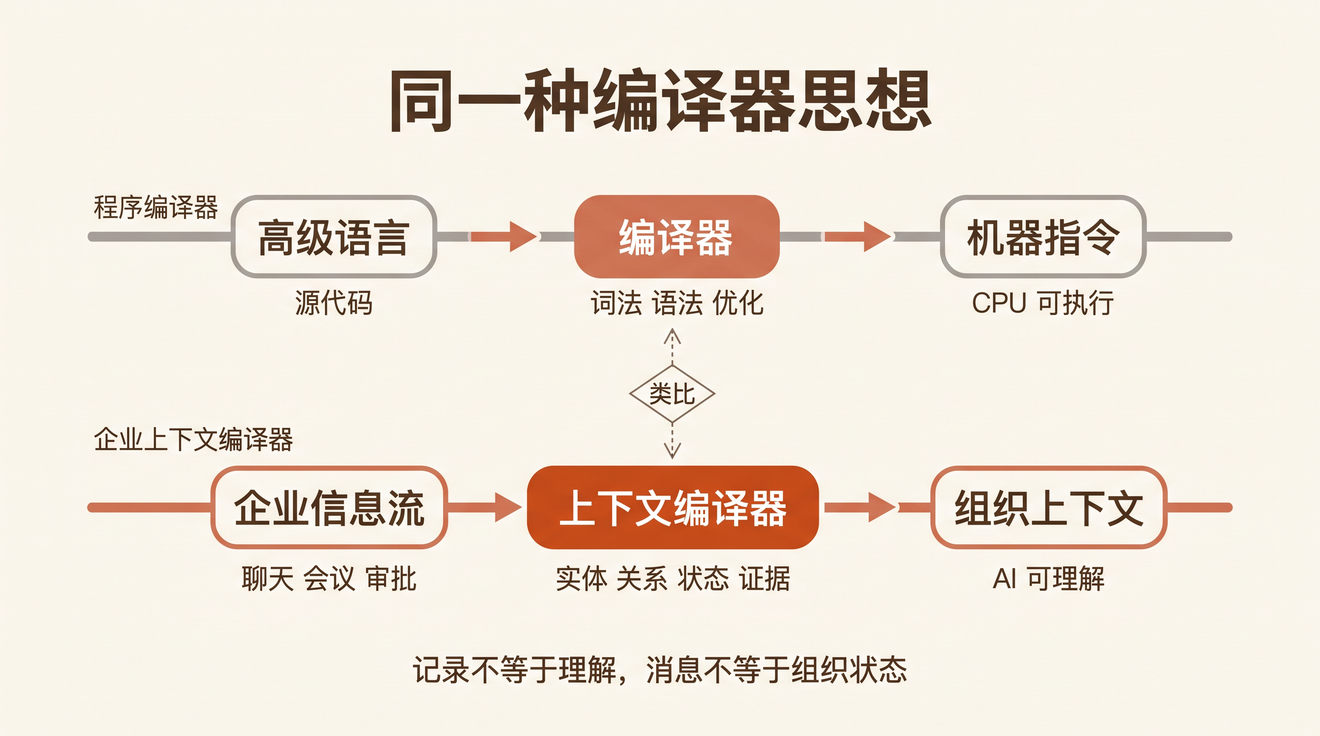
把一个人的工作流编译成 AI 能用的上下文,444 那篇已经跑通了。这篇往上走一层:一个组织的工作流,能不能像程序一样,被一台编译器编成 AI 可以执行的上下文?

我的回答是能,但前提是把「编译器」这个类比当真——不是借个名字,而是把词法分析、符号表、中间表示、链接、增量编译一一对上,再老实承认它在哪里不成立。恰恰是不成立的那几处,决定了这台编译器该怎么设计。
From Program Compiler to Enterprise Context Compiler

[Read More]

通讯录不是人员列表,是企业本体的第一张骨架图

The Org Chart Is Not a Contact List, It Is the First Skeleton of Your Ontology

先说一类很常见的翻车现场。一个数字员工被问「把这份报销单转给张三的直属主管审批」,它很自信地查了通讯录,拿到一个名字,发过去了。结果那个人三个月前就调岗了,张三现在的主管是另一个人。报销单卡在一个已经不管这摊事的人那里,没人报错,日志全绿——只是这件事从此没人推进。

问题不在模型笨。模型很聪明,它把「查主管」这个动作完成得干净利落。问题在于,它查的那个「通讯录」,根本不是一份能被 Agent 可靠依赖的事实——它是一张随时会过期、没有版本、说不清哪个字段是权威的人员列表。

几个月前我在 Palantir 从本体长到 Agent,我们从 Agent 长回本体 里下过一个判断,下得很痛快:

Ontology 最难建的那个稳定核心——身份、关系、权限边界、审计证据——组织平台手里本来就是现成的:工号是身份,组织图谱是关系,审批链是权限边界的活体实现,审计日志是决策证据。

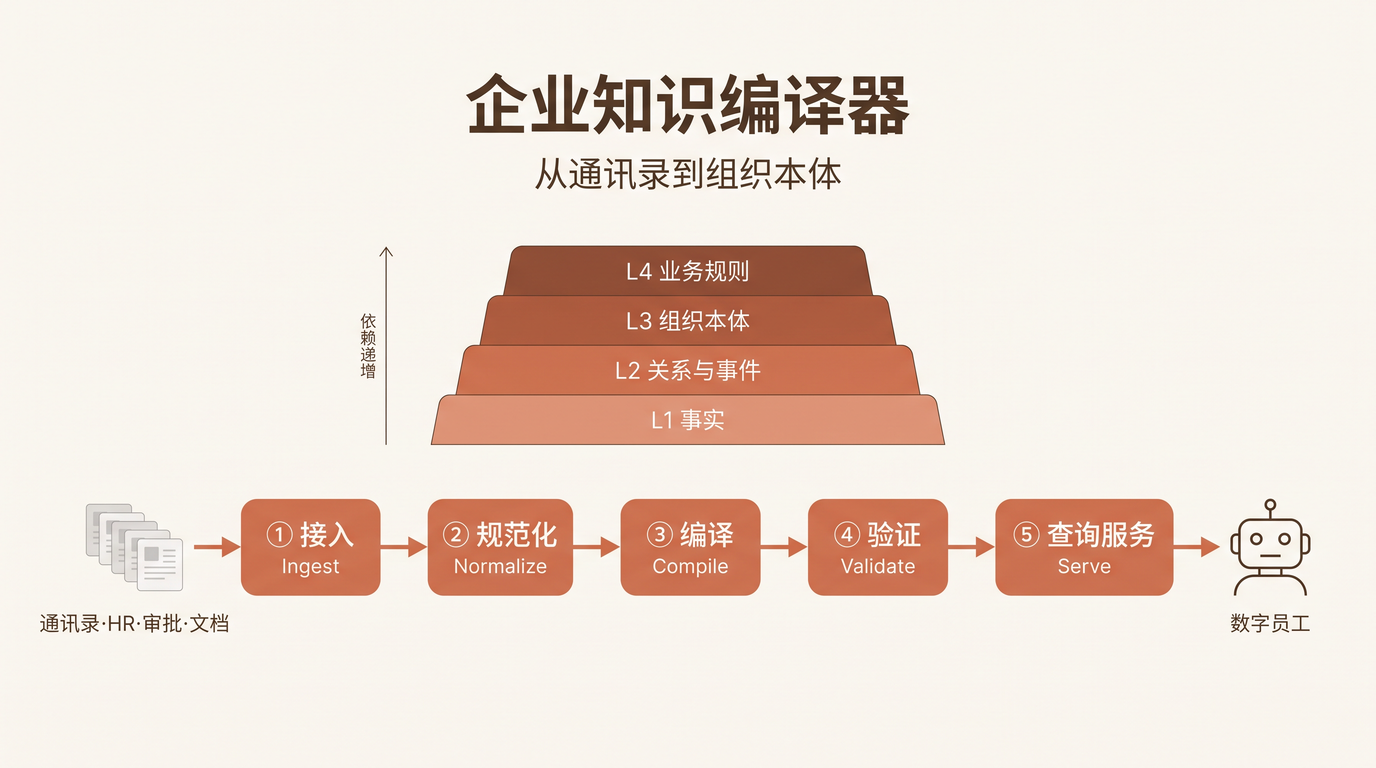
那篇讲的是路线:为什么组织平台可以反着走,先让 Agent 以数字员工的身份上岗,再从它的日常工作里长回本体。但路线讲完,有个工程问题被我一笔滑过去了——从钥匙串到本体,中间那道编译,具体怎么做?

「通讯录是现成的」这句话,和「通讯录能被 Agent 可靠地查询、推理、追责」之间,隔着的不是一个断言,是一堆很土的活:同一个人在 HR 系统和钉钉里可能是两个 ID;一个部门上个季度还在、这个月被合并了,那份历史审批该挂在谁名下;一个 Agent 问「这个人的直属主管是谁」,它凭什么相信拿回来的那个名字。开头那张卡住的报销单,就死在这堆活里。

这篇就把这道编译拆开写。核心判断只有一句:企业知识不是检索出来的,是编译出来的;而且要从最土的那一层开始编译——可验证的事实。

The Org Chart Is Not a Contact List, It Is the First Skeleton of Your Ontology

[Read More]

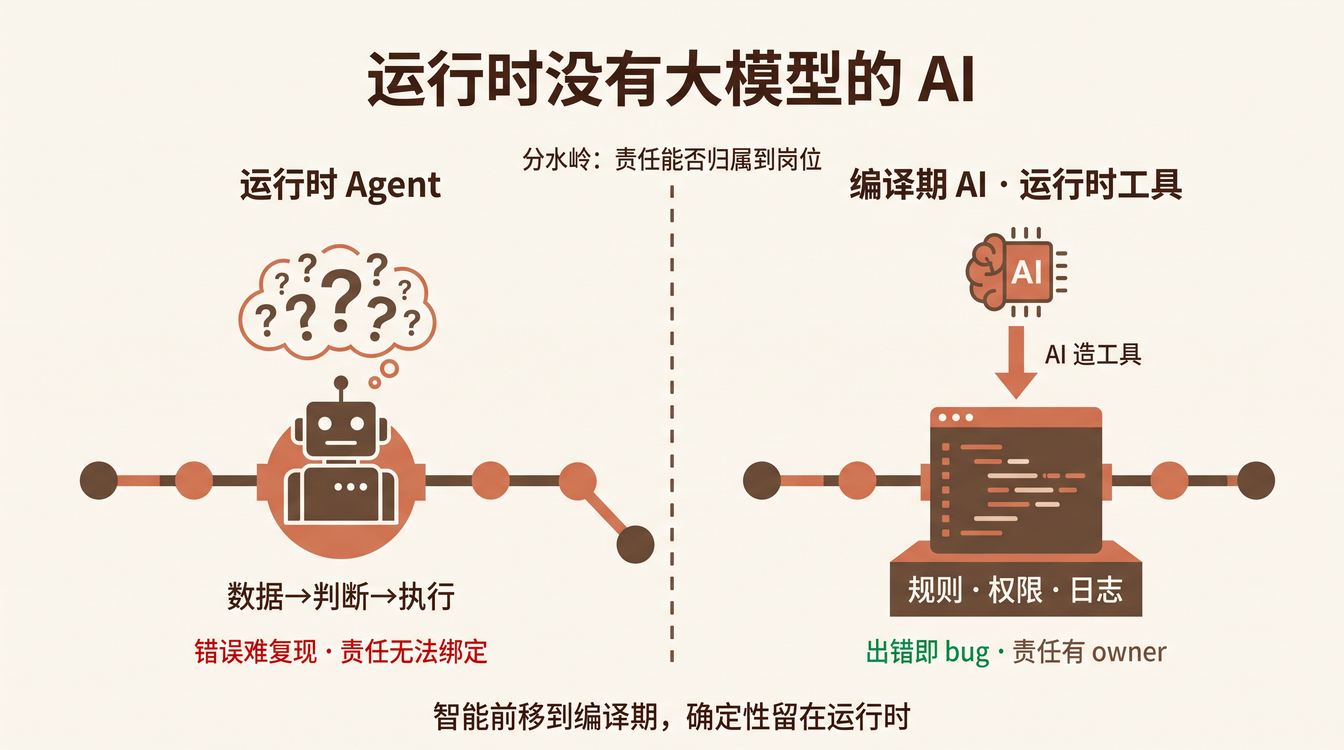
制造业选中的 AI,运行时没有大模型

The AI Manufacturing Actually Chose Has No LLM at Runtime

三个月前,一个做汽车零部件的朋友跟我吐槽:他们花大半年选的「国内最好的大模型」,搭了三个月的质检 Agent,上线两周被业务部门集体退货。我在 AI to B 的最后一公里 里记下了他那句话:「我们的 AI 项目,死在了数据治理和系统对接上——这两件事,跟模型半毛钱关系都没有。」

那是一次个案级的抱怨。今天,我看到了一份系统级的判决书。

公众号 REIVAX.io 发了一篇文章:《AI 落地传统企业:赋能个人、接管流程,还是造工具?》。作者自述在传统制造企业做数字化,把 AI 进入企业生产链条的方式分成三种模式,然后逐一裁决哪种能落地。这是我少见的 需求侧第一人称 的 AI 落地分析——不是厂商写的,不是咨询顾问写的,是那个要为项目成败负责的人写的。

判决结果出乎很多人意料:制造业用脚投票选中的那个模式,业务流程运行时没有大模型。

The AI Manufacturing Actually Chose Has No LLM at Runtime

[Read More]

大多数企业 AI 的终点是人,Palantir 的终点是业务

Most Enterprise AI Ends at a Human — Palantir's Ends at the Business

上周,我翻我们数字员工的一条真实执行链路:一条消息进来,Agent 理解意图,调用 dws 能力执行,结果回到钉钉。全程没有「人看报表」这一环——数据的终点不是被谁看见,而是业务本身被改变。

这条链路短到不起眼。但它让我意识到,自己正在做一件大多数企业 AI 还没做成的事——同一时间,绝大多数企业的 AI 项目,正卡在「把结果给人看」这一步出不来。

最近读到「森林瀑布」的一篇长文《Palantir 还是太全面了》,把 Palantir 的官网和产品文档逐页扒了一遍。文章里有一句话,我认为点破了企业 AI 的分水岭:

「AI 到底连接到了什么。如果 AI 连接的只是一个搜索框,它还是聊天机器人。如果 AI 连接的是企业 Ontology、业务规则、Action 和真实业务系统,它才真正开始进入企业的操作层。」

[Read More]

Databricks 逼近 Palantir,但最后一层藏在组织里

Databricks Is Closing In on Palantir — But the Last Layer Lives in the Org

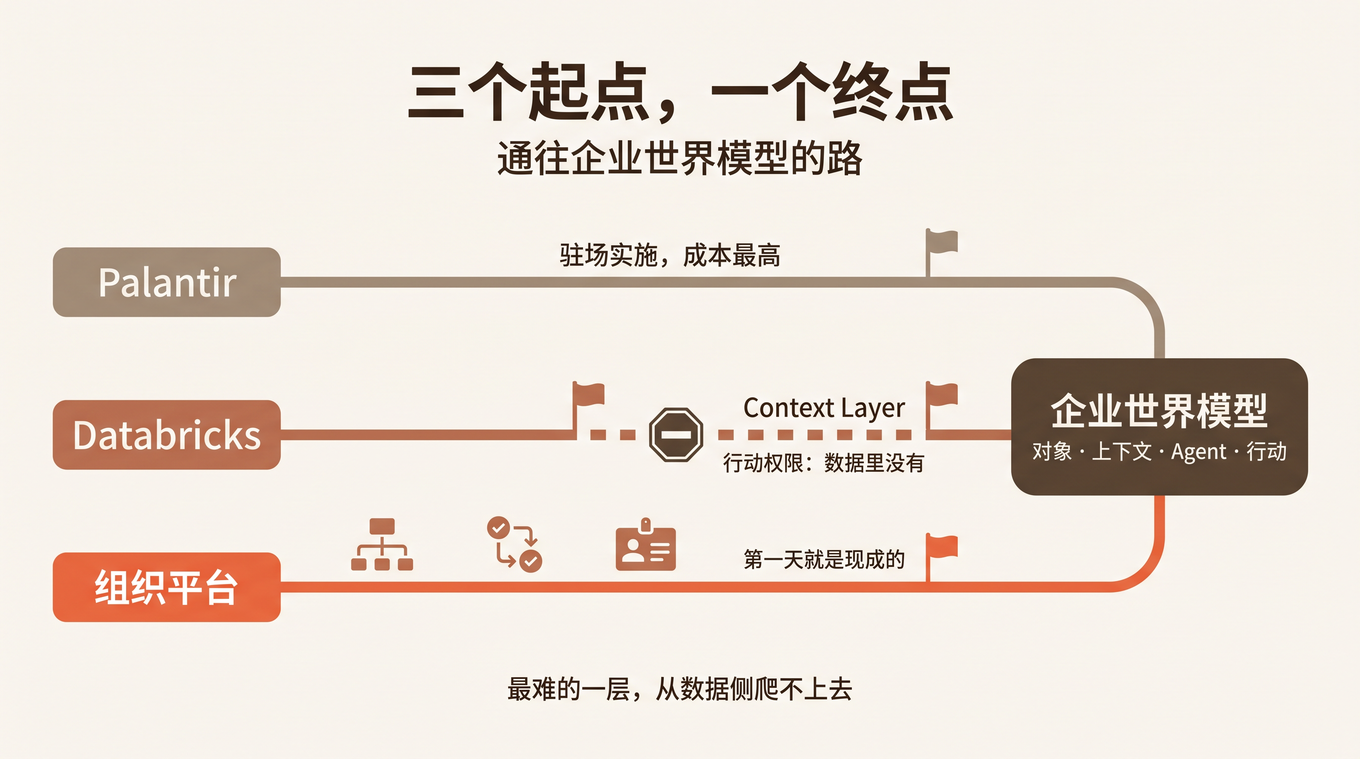
昨天读到汪小东的一篇长文,标题是《Databricks 正在逼近 Palantir 的核心区》。文章把 Databricks 2026 年的产品拼图摊开看:Genie Ontology、Agent Bricks、Supervisor Agent、Unity AI Gateway、Omnigent、Lakebase——结论是 Databricks 正在从「管理企业数据」走向「理解企业业务」,逼近 Palantir 经营了二十年的战略腹地。

文章最后那句话写得很好:

「模型提供智能,但企业需要一个能够承载智能的世界。Ontology,正在成为这个世界的骨架。」

这个判断我完全同意——它和我在 AI 的竞争变了:未来是上下文的竞争 里说的方向完全一致。但读完之后,有一个问题一直挂着我:

如果 Ontology 是终点,为什么数据资产最多、AI 工程师最密集的 Databricks,走到 Context Layer 就停住了?它缺的到底是什么?

四天前我在 Palantir 从本体长到 Agent,我们从 Agent 长回本体 里讨论过 Palantir 的路线。Databricks 的入局,让这盘棋从两家变成了三家。这篇文章在那篇的基础上再往前推一步:三家从三个起点出发,走向同一个终点——而 Databricks 恰好证明了,最难的那一层,从数据侧爬不上去。

Databricks Is Closing In on Palantir — But the Last Layer Lives in the Org

[Read More]