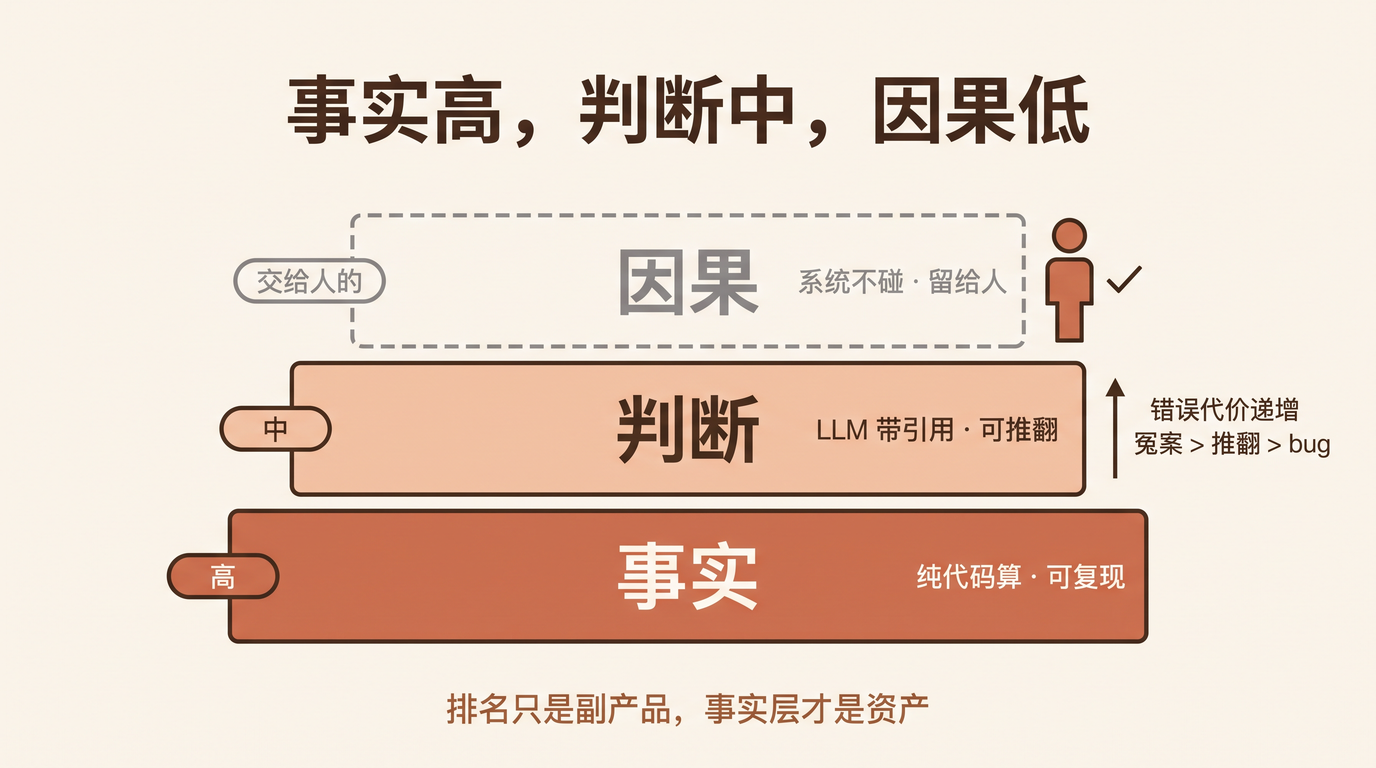
前几天我手工做了一份研发效能排名,把一群工程师某两天的 PR 产出按质量和效率排了个序。做完之后,记住的是两件事。
第一件:评审记录里抓出一个极端案例——评审意见指出问题之后 54 秒,代码就合入了。这种事实只能靠把时间戳逐条比对出来。它躺在数据里,但没有任何模型会替你「读」出来。
第二件:这份排名差点在第一步就错了。GitHub 账号、IM 身份、群里的那个「人」,是三套账号体系。有个账号明明就是某位工程师,但证据只有群里几句「@某某 #PR 号」的交叉引用。如果我图省事直接猜合,就会把别人的产出算到他头上——这是这类系统能犯的最坏的错。
排名做出来之后我想明白了一件事:难点根本不在统计,在四件性质完全不同的事——认人、算数、取证、判断。而让 AI 做效能度量,成败取决于你有没有把这四件事分给不同的角色。
这篇把我此后一直遵守的通律写下来:AI 度量研发效能,精度分三层——事实高、判断中、因果低。 以及一个更反直觉的结论:排名只是副产品,真正的资产是它底下那层确定性事实——建好之后,一整张管理问题表都是近零边际成本白得的。