通用 Agent 之后,企业真正应该落地什么?

After the General Agent, What Should Enterprises Actually Deploy

上个月一个 CIO 给我看他们的 AI 成果清单,讲得很顺:接入了多少个 Agent、开了多少智能体账号、买了多少 token、做了几场全员培训。我听完问了他一句:「你们每天真实发生的业务里,有多大比例是 Agent 参与完成的?」

他停住了。停了几秒,说:「这个我们没统计过。」

这不是个例。绝大多数企业的 AI 成绩单,记的都是投入项——买了多少、接了多少、开了多少。而真正决定 AI 能不能产生业务价值的那个数字,没人算过。

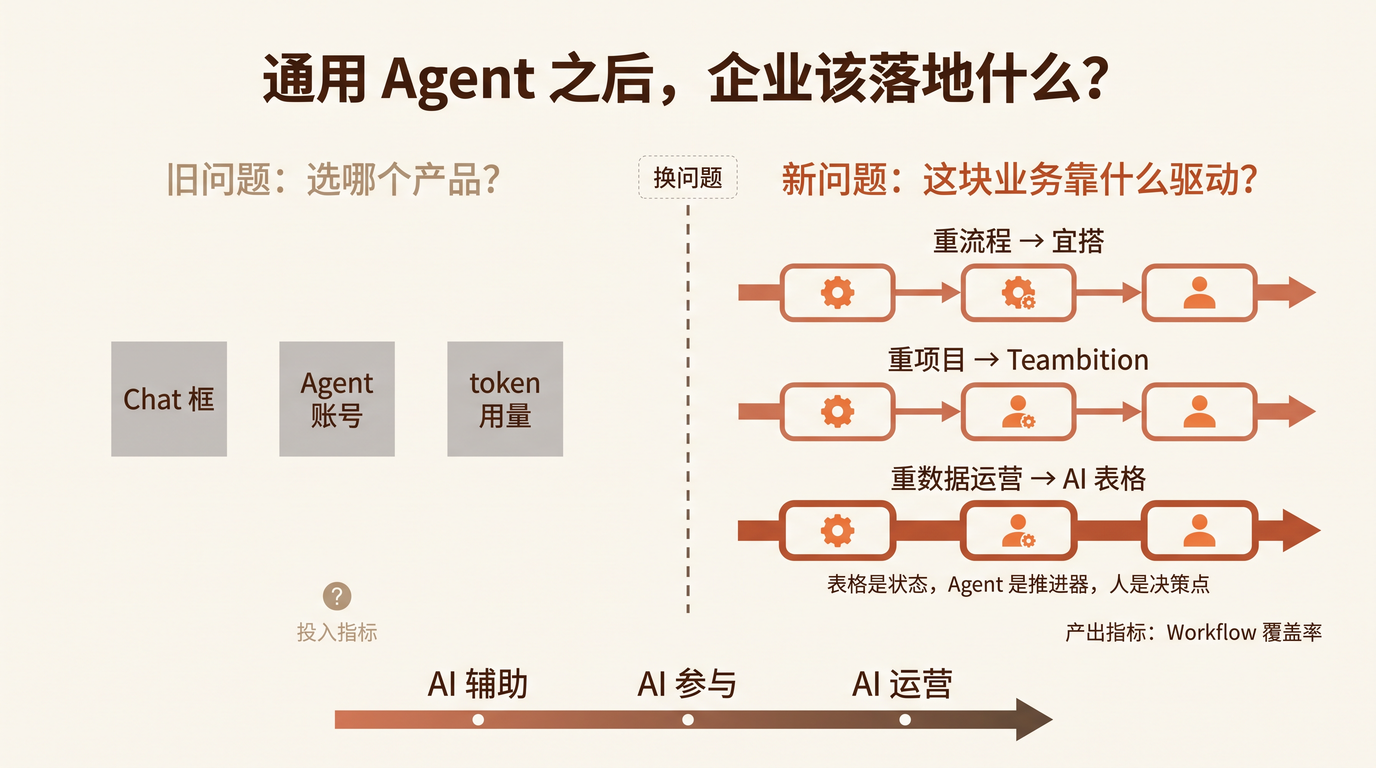
通用 Agent 之后,企业要解决的,不是再做一个更聪明的 Chat,而是把 AI 真正嵌进每天发生的协同工作流。

过去企业数字化的路径大致是:

业务流程 → 表单 / 审批系统 → 人来操作系统
# generated by hugo AI

AI 时代正在变成:

业务目标 → Agent 理解与执行 → 人做判断与审核
# generated by hugo AI

所以引入通用 Agent 只是第一步。真正的问题是:你的企业有没有一个能让 Agent 进入、理解、执行、反馈、持续优化的工作流载体。 没有载体,Agent 再聪明也只是停在对话框里。
After the General Agent, What Should Enterprises Actually Deploy

[Read More]

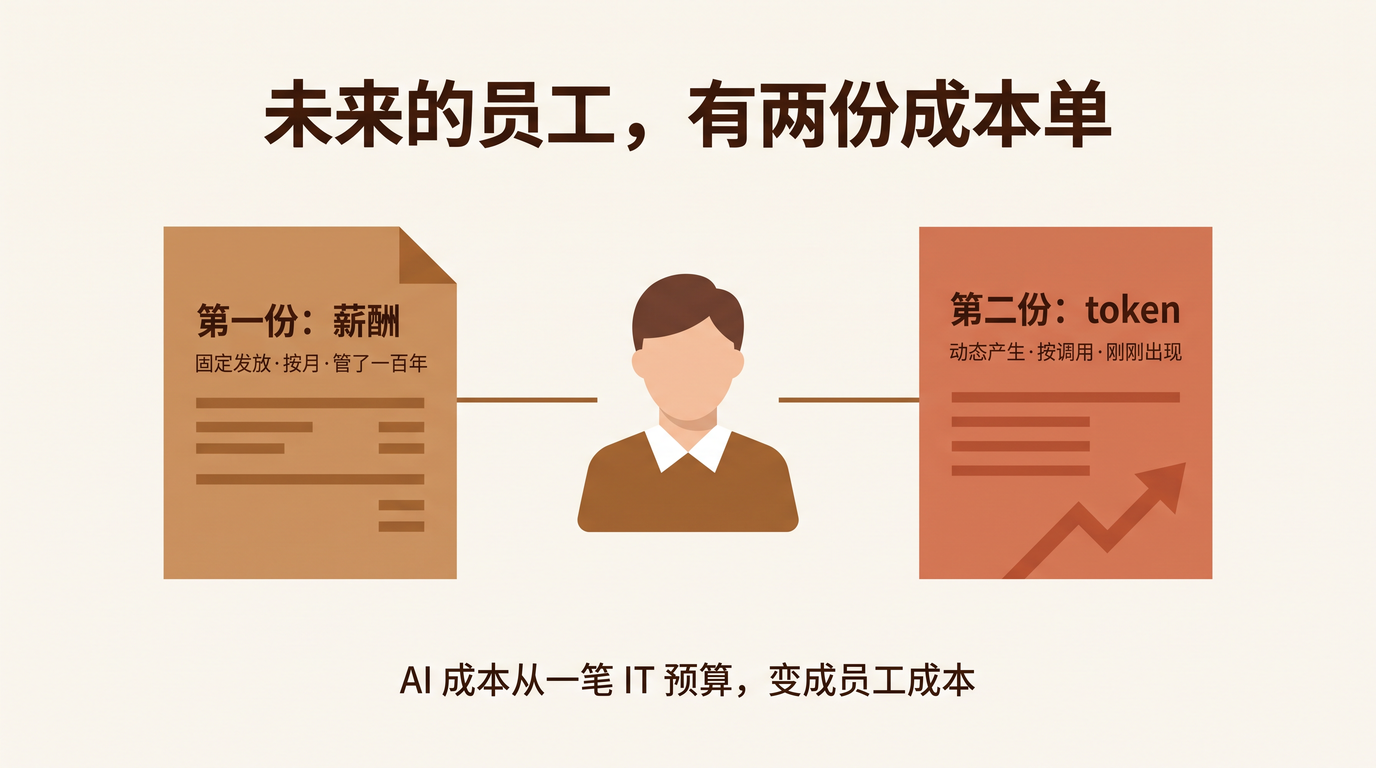
未来的员工,有两份成本单

The Future Employee Comes With Two Cost Sheets

月底,一个用了大半年 AI 的老板跟我抱怨:他知道这个月公司在 AI 上花了多少钱,云账单上写着。但他答不上来另一个问题——这笔钱是哪个团队、哪个流程、哪个数字员工花掉的。

「账单是一整笔,」他说,「就像食堂一个月的米面油采购单,你知道总数,但说不出哪道菜亏本。」

这不是个例。绝大多数企业的 AI 支出,今天都停在「一笔云账单」的粒度上。而我在 OpenRouter CEO Alex Atallah 最近的一场访谈里,看到他给出了一个完全不同的判断——他说这是「很反常、却很少有人讨论」的现象:

「过去员工的成本主要是固定薪酬……未来,员工成本会是动态数字,与每个人是否有效地使用昂贵或廉价模型有关。管理者仍要正常评估员工的效率和产出,但也可以把效率和 AI 使用成本放在一起看。」

换句话说:AI 的成本,正在从「一笔 IT 预算」变成「一份人力成本」。 未来每个员工——尤其是每个数字员工——都会带着两份成本单:一份是薪酬,一份是 token。

The Future Employee Comes With Two Cost Sheets

[Read More]

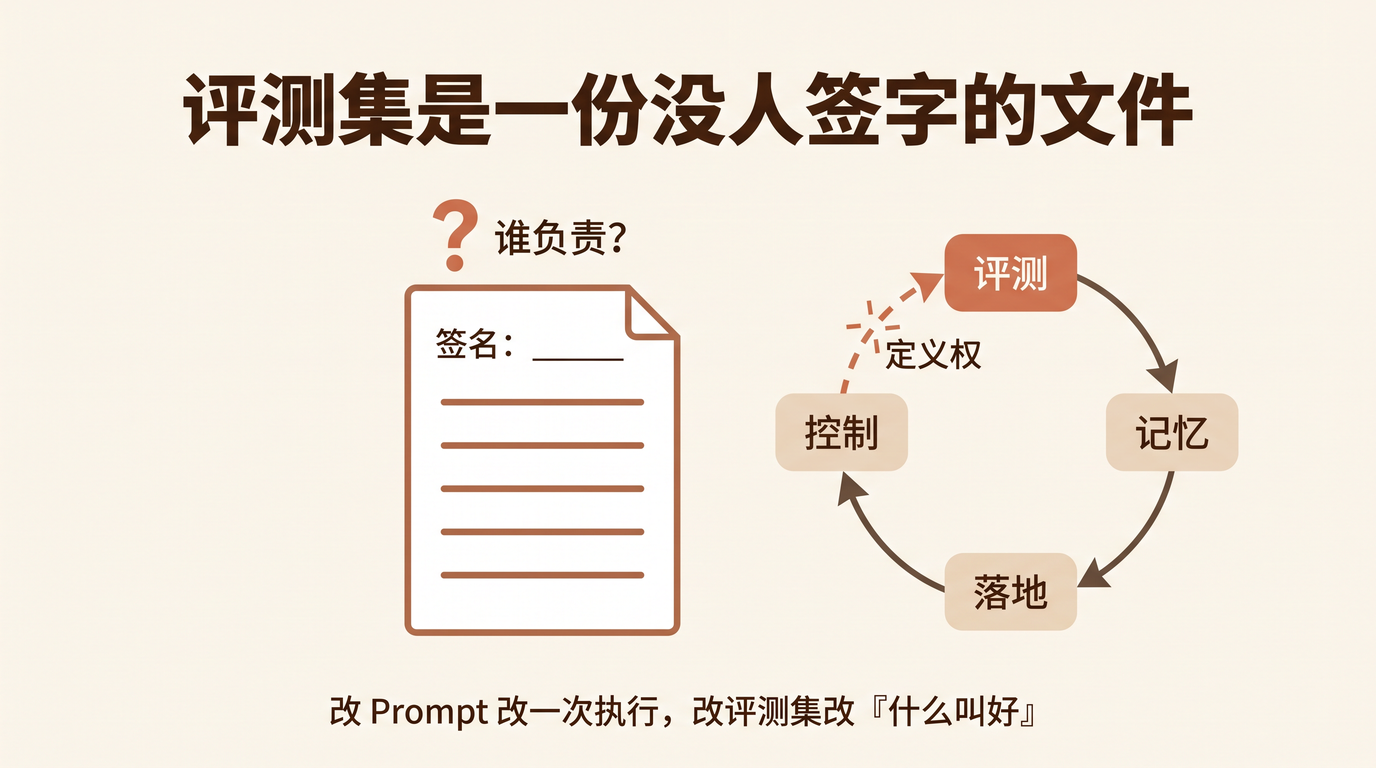
评测集是一份没人签字的文件

An Unsigned Eval Set Is a Flywheel Without an Owner

最近读到一篇两万字的 Agent 自进化方法论,写得相当扎实。其中记了一条血泪教训:有团队在某个场景上连续 20 多轮自动迭代,效果一直不提升——最后发现根因根本不在配置层,而在工具层。20 多轮里,系统忠实地修 Prompt、改 Skill,每一轮都按评测信号在优化。

回头看,最惊人的不是根因藏得深,而是这 20 多轮里,没有一个人问过:这批评测 case 本身,选对了吗?

没人问,因为没人需要问——这份评测集没有主人。

这篇方法论(作者 yannisyang、ethanytzhou)把评测、记忆、落地、控制四个环节拆成飞轮:评测是眼睛,记忆是大脑,落地是手脚,人机协作是方向盘。四个齿怎么建、坑在哪、从零到一怎么落地,都讲了。它最有价值的一句话是:

大多数团队的问题恰恰在于:每个组件内部做得还行,但组件之间的「箭头」没有自动化。

飞轮的瓶颈不在齿,在齿与齿之间的通路。我完全同意——但沿着这句话再往下推一步,会发现一个这篇两万字没有回答的问题:

所有箭头里最上游的那一条——「什么叫好」——它的定义权在谁手里?

An Unsigned Eval Set Is a Flywheel Without an Owner

[Read More]

麦肯锡终于说了:Agent 也要绩效考核——但他们没说怎么考

McKinsey Says Agents Need Performance Management — But Not How to Measure Them

8 月底,麦肯锡的播客 McKinsey Talks Talent 里,主持人 Lucia Rahilly 抛出了一个很多公司都在回避的问题:Agent 进了核心工作流,谁来管它?

资深合伙人 Brooke Weddle 的回答很直接:「HR 管理的不再只是人类的绩效,现在还有数字员工。」 全球技术与 AI 负责人 Kate Smaje 接着把问题拆成了三问:

「我到底有多少个 Agent?谁对它们的绩效负责或担责?它们创造了多少价值?」

问完,她自己补了一句更狠的话:当她问企业「上次讨论非人类劳动力的绩效是什么时候」——「几乎没有组织能回忆起自己把这件事排上过议程。」

听到这三个问题的时候,我愣了一下——这不是新闻,这是我今年 3 月起就在博客里反复写的那一系列问题。麦肯锡用了整个 8 月,终于追上了这条线。

他们给出的答案也对:Agent 归使用它的业务负责人管,不是 IT,不是 CTO。 这和我在数字员工的第一准则不是可控性里推导的主管制,几乎是同一个结论的两条路径——他们从管理实践归纳,我从问责公理演绎,殊途同归。

但这份答案只答了一半。

[Read More]

钉钉数字员工架构与落地实践

DingTalk Digital Employee: Architecture and Implementation Practices

8 月 27 日晚上,我做了一场《钉钉数字员工架构与落地实践》的分享。六十分钟的正题讲完,真正让我反复回味的,是 Q&A 环节的四个问题。

最后一个最尖锐。提问者先铺垫了他的观察:从演示看,数字员工做的是秘书、提醒、传话、会议纪要这类辅助性工作。然后他话锋一转:

如果我让数字员工承担一部分技术开发工作,它将面对非常复杂的场景和长周期的任务。长周期任务下,执行的成功率会一路衰减。请问你们的数字员工能不能解决复杂的长期问题?如果不能……

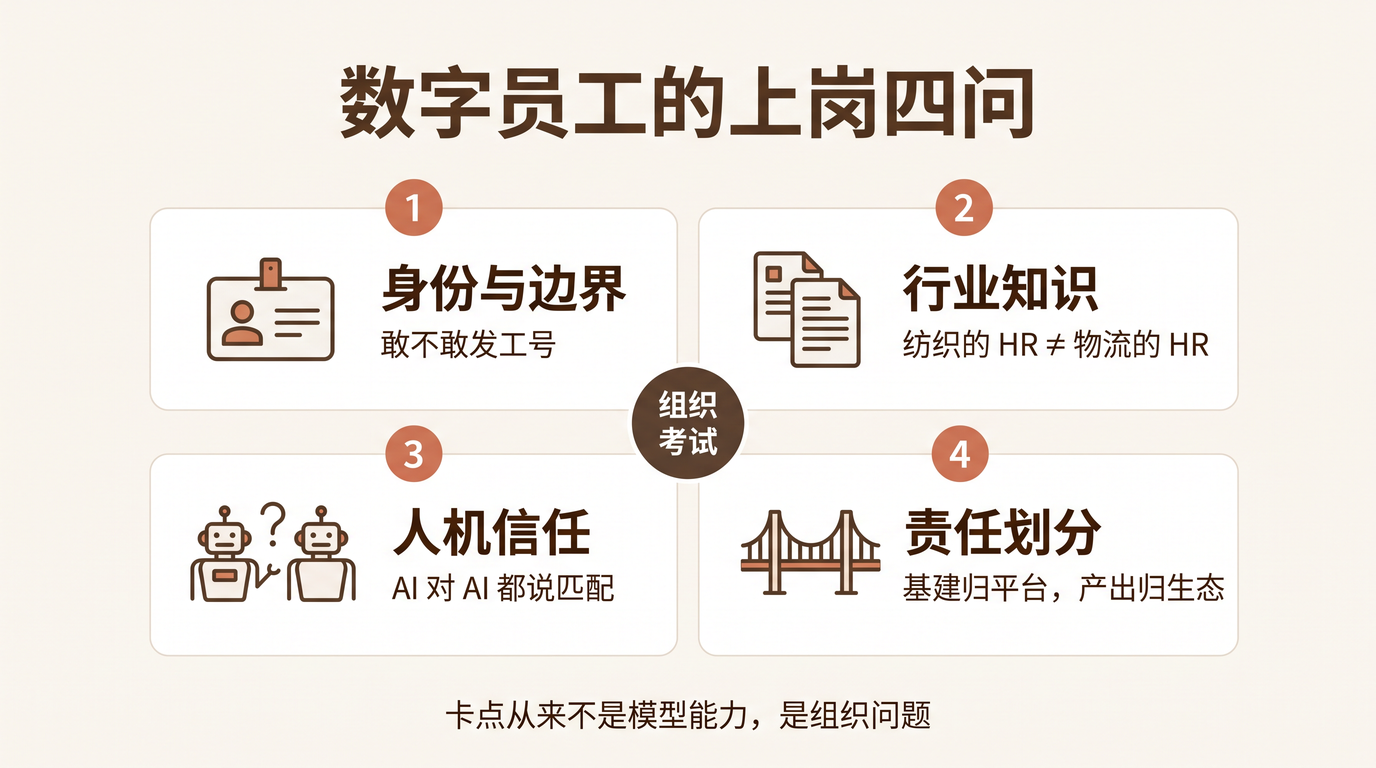
「如果不能」悬在半空。我当时的回答很直接: 钉钉做的是让 AI 能进入企业组织架构的基建——数字员工账号、连接多 Agent,权限管控、运行审计、知识管理,为任务提供上下文等基础能力,还提供入转调离全生命周期管理、执行前主管审批确认放行、岗位能力评估和考核、拟人化交互等功能,但还不能对企业自建或生态交付给企业客户的数字员工的产出效果来负责。

分享结束后,我把这四个问题记了下来。它们看似散,其实指向同一件事: 数字员工的落地卡点,从来不是模型能力,而是四个组织问题。 而四个问题说到底,又可以归到一个词上: 委托 ——把工作交给 AI 之后,这份委托如何在组织里被信任。

DingTalk Digital Employee: Architecture and Implementation Practices

[Read More]

AI Native 组织的第一生产力,是敢被蒸馏的管理者

The First Productivity of an AI-Native Org Is a Manager Willing to Be Distilled

上周一个老板问我:他想像同行那样,用 3 个真人带 30 个数字员工跑业务(这个比例是我们推演的示意,不是他的真实编制)。卡点在哪?

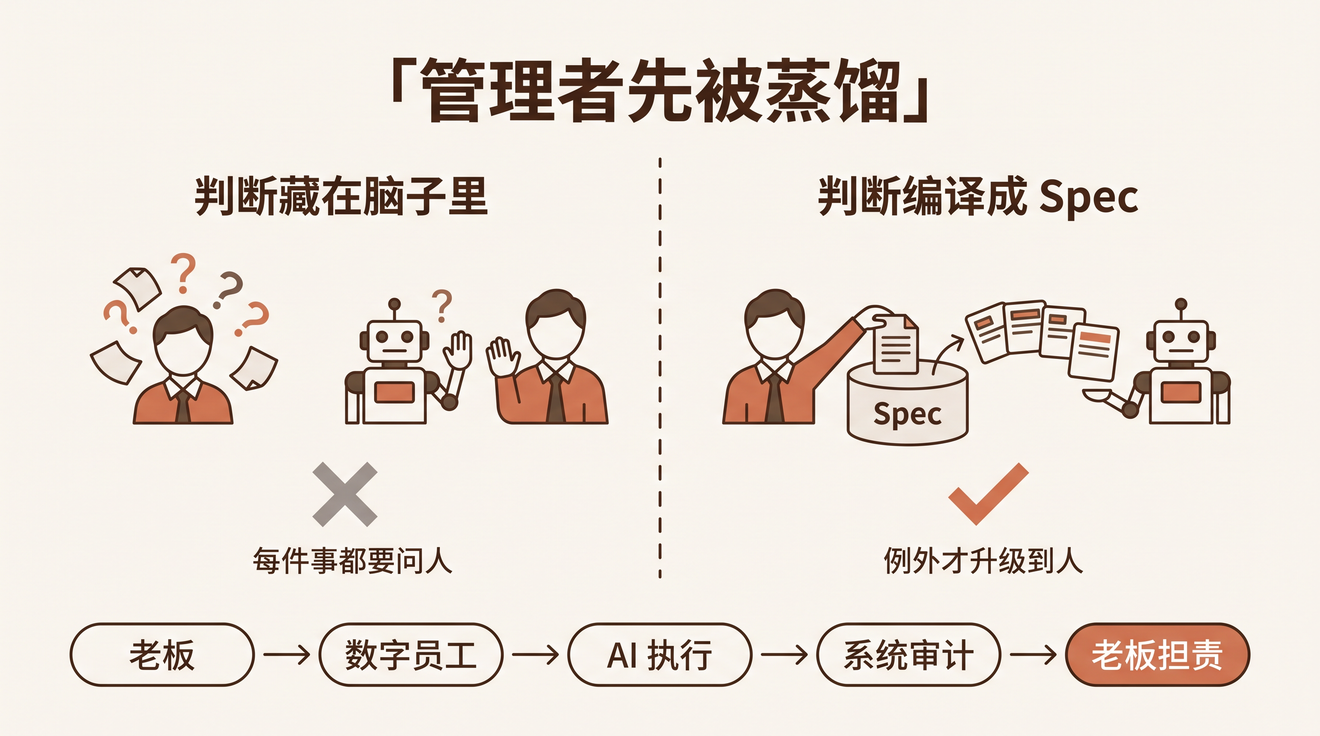
不是模型不够聪明,也不是工具不够多。卡在一个很朴素的地方:没有一个中层愿意把自己的判断标准写成文档。

审批到什么金额要上报、哪种客户投诉要升级、什么情况下可以破例——这些判断每天都在发生,但全装在某个管理者的脑子里。数字员工问他,他口头答;换一个场景,又得重新问。

于是 30 个数字员工,每一个都变成了「等他拍板」的排队窗口。

The First Productivity of an AI-Native Org Is a Manager Willing to Be Distilled

[Read More]

大多数企业 AI 的终点是人,Palantir 的终点是业务

Most Enterprise AI Ends at a Human — Palantir's Ends at the Business

上周,我翻我们数字员工的一条真实执行链路:一条消息进来,Agent 理解意图,调用 dws 能力执行,结果回到钉钉。全程没有「人看报表」这一环——数据的终点不是被谁看见,而是业务本身被改变。

这条链路短到不起眼。但它让我意识到,自己正在做一件大多数企业 AI 还没做成的事——同一时间,绝大多数企业的 AI 项目,正卡在「把结果给人看」这一步出不来。

最近读到「森林瀑布」的一篇长文《Palantir 还是太全面了》,把 Palantir 的官网和产品文档逐页扒了一遍。文章里有一句话,我认为点破了企业 AI 的分水岭:

「AI 到底连接到了什么。如果 AI 连接的只是一个搜索框,它还是聊天机器人。如果 AI 连接的是企业 Ontology、业务规则、Action 和真实业务系统,它才真正开始进入企业的操作层。」

[Read More]

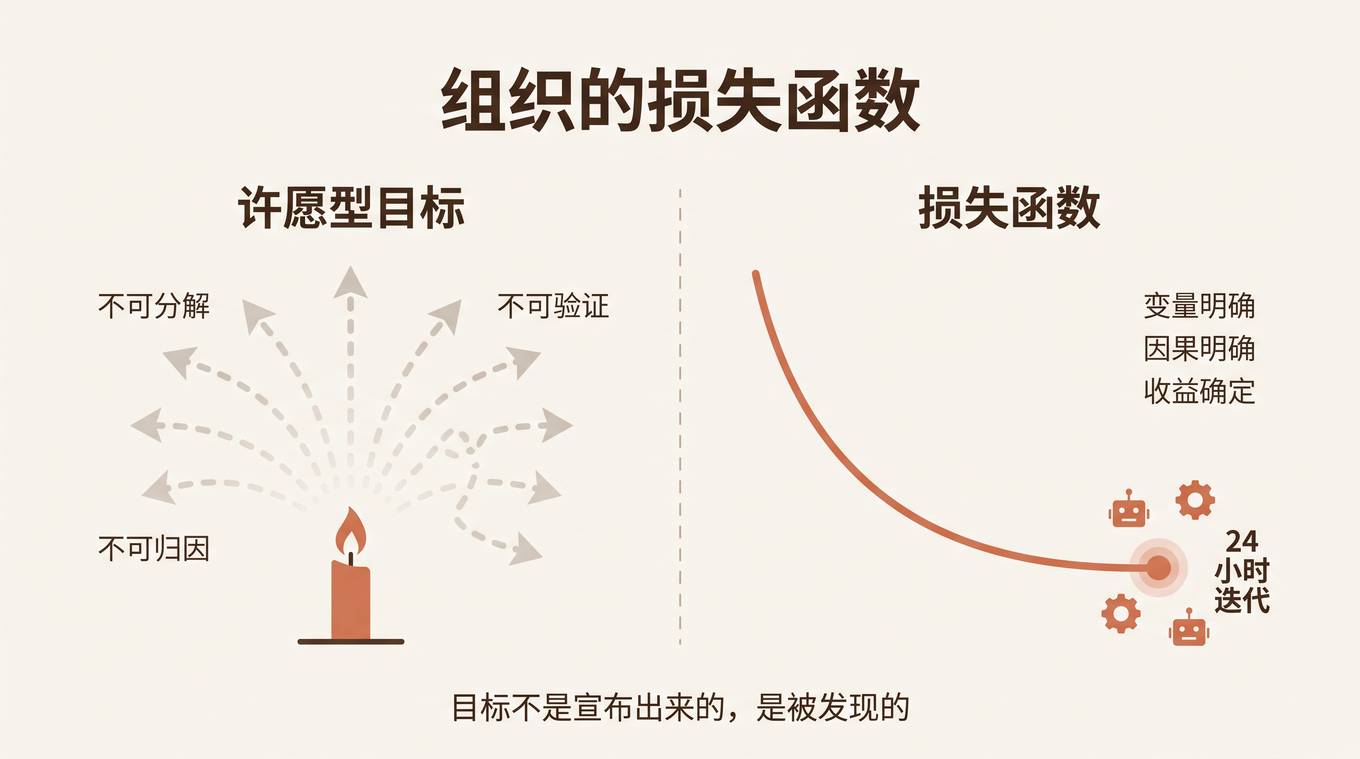
组织的损失函数:为什么你的 OKR 只是许愿

Your OKRs Are Just Wishes: What Organizations Really Need Is a Loss Function

和朋友讨论组织的 AI 化时,有一句话点破了本质:

「训练过模型的人都懂:损失函数错了,训练步数越多,跑得越偏。」

组织也一样。目标错了,团队越勤奋,死得越快。

训练速度从来不是问题,梯度方向才是。而大多数组织最大的危机是:它们从未认真检查过,自己正在优化的那个东西,到底是一个目标,还是一个愿望。

Your OKRs Are Just Wishes: What Organizations Really Need Is a Loss Function

[Read More]

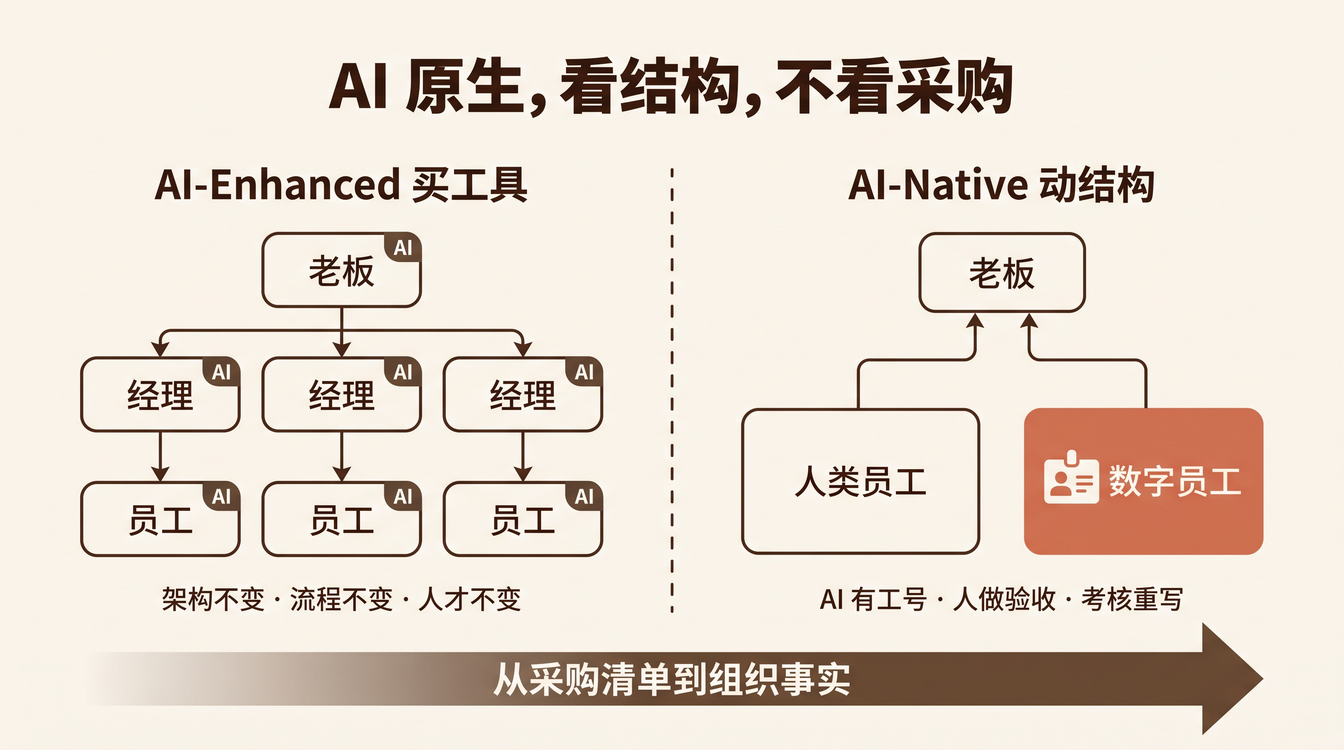
组织架构没变,就别谈 AI 原生

No Org Change, No AI-Native: A Structural Litmus Test

这句话出自最近一次关于企业 AI 转型的讨论。

当时的话题是:怎么判断一家公司是不是真的 AI 原生了?很多人的第一反应是列技术清单——买了多少 AI 工具、覆盖了多少人、token 消耗增长了几倍。然后有人扔出了这么一句:

企业组织架构不变、流程不变、人才要求不变,就别谈 AI 原生。

乍一听很极端,但细想会发现它的厉害之处:它把「AI 原生」从一个技术采购问题,变成了一个组织事实问题——原生与否,不看买了什么,看结构动没动。

这个类比很精确。cloud-native 的反面不是「没用云」,而是 lift-and-shift——把单体应用原封不动搬上虚拟机,然后宣称自己上云了。今天绝大多数所谓的「AI 转型」,就是 AI 版的 lift-and-shift:把 AI 塞进旧流程、旧考核、旧管理思维里,然后管这叫原生。

No Org Change, No AI-Native: A Structural Litmus Test

[Read More]

AI 让每个人都变快了,为什么公司没有变快

Individual Speed, Organizational Friction — Where the Real Bottleneck Moved

上周,一位做软件外包的朋友跟我吐苦水。

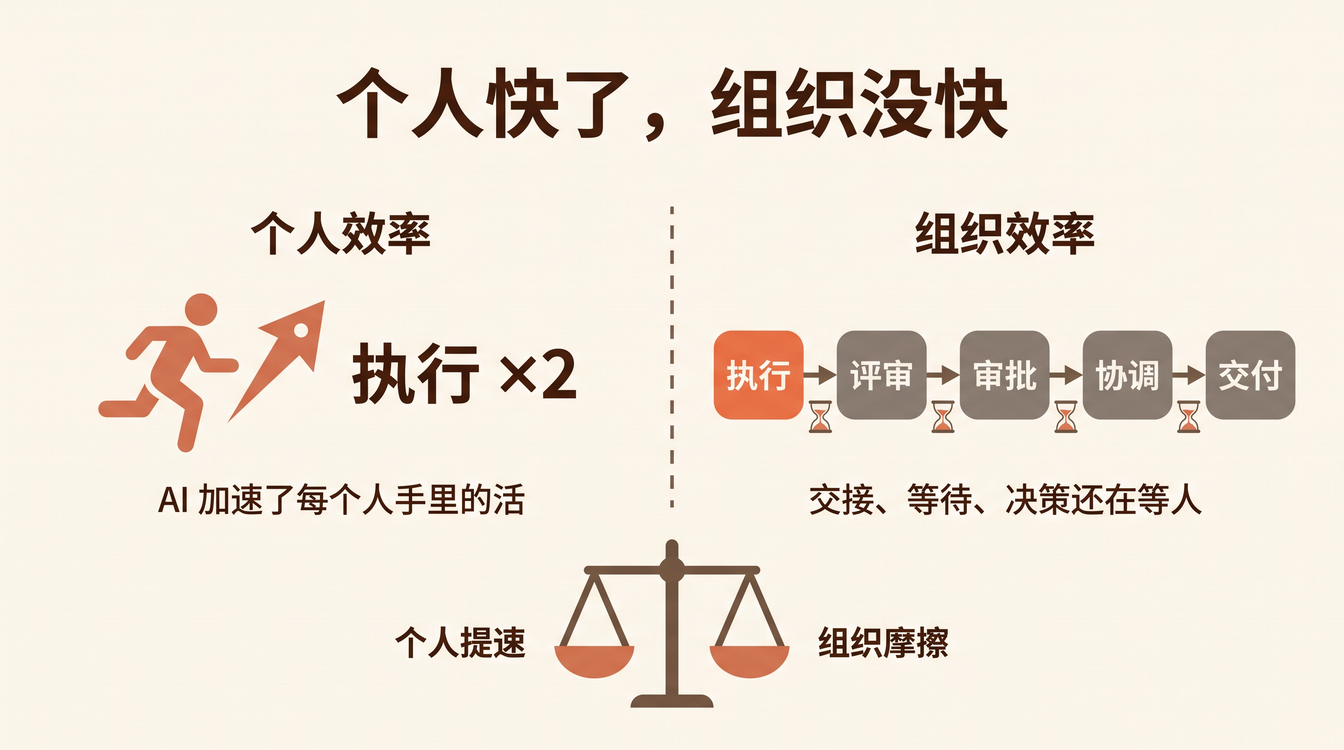
他给公司三十多个工程师全部配了 AI 编程工具,钱花了不少,工程师也很买账。半年后他拉数据,想看看交付速度提升了多少——结果发现,项目平均交付周期几乎没变。工程师写的代码确实多了,但代码堆在评审环节;评审通过了,又堆在测试和发布环节。

他问我:「是不是工具不够好?要不要换一个更贵的?」

我说:工具没问题。问题是 AI 把每个人手里的活干快了,但活和活之间的缝隙,一点没变窄。代码从「写完」到「上线」,中间隔着评审、测试、审批、排期——这些环节里没有一个 AI,全是人在等人。

Individual Speed, Organizational Friction — Where the Real Bottleneck Moved

[Read More]