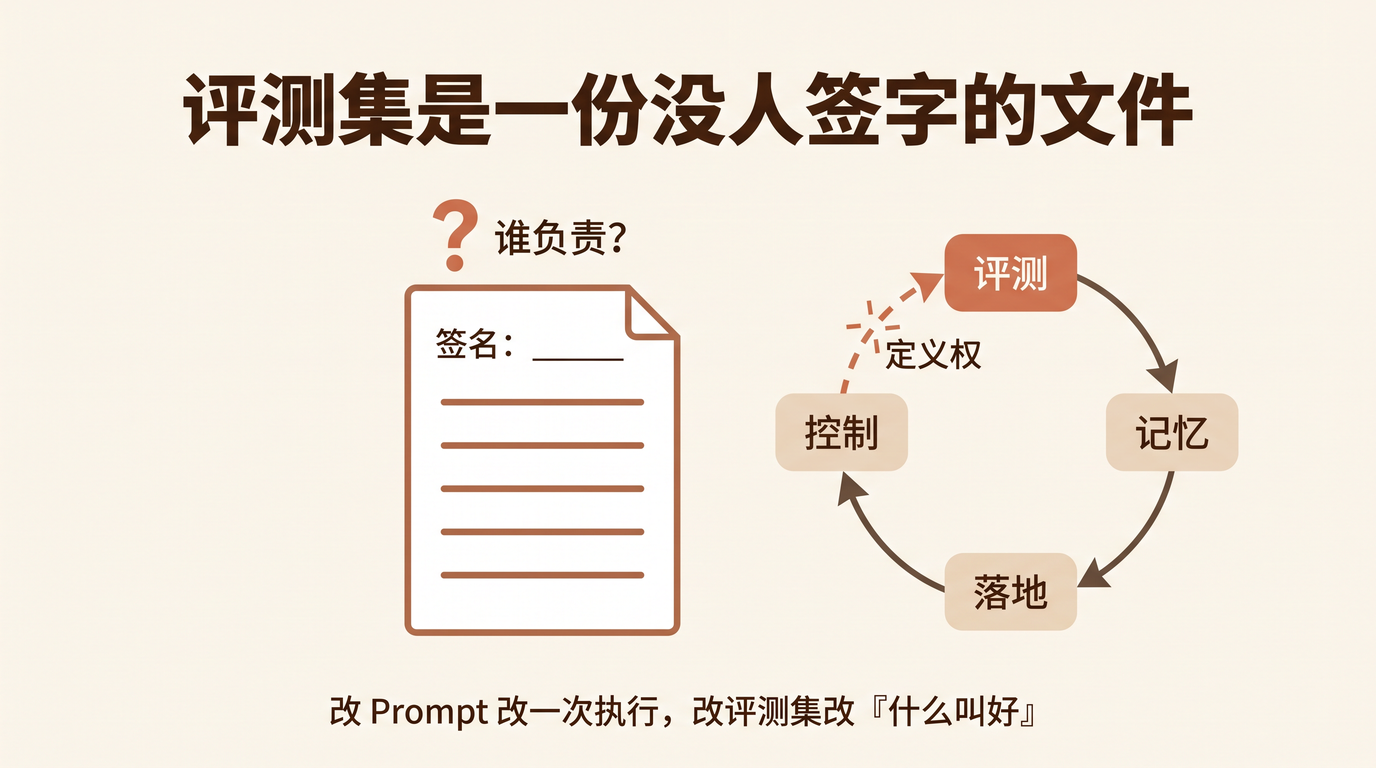
评测集是一份没人签字的文件

An Unsigned Eval Set Is a Flywheel Without an Owner

最近读到一篇两万字的 Agent 自进化方法论,写得相当扎实。其中记了一条血泪教训:有团队在某个场景上连续 20 多轮自动迭代,效果一直不提升——最后发现根因根本不在配置层,而在工具层。20 多轮里,系统忠实地修 Prompt、改 Skill,每一轮都按评测信号在优化。

回头看,最惊人的不是根因藏得深,而是这 20 多轮里,没有一个人问过:这批评测 case 本身,选对了吗?

没人问,因为没人需要问——这份评测集没有主人。

这篇方法论(作者 yannisyang、ethanytzhou)把评测、记忆、落地、控制四个环节拆成飞轮:评测是眼睛,记忆是大脑,落地是手脚,人机协作是方向盘。四个齿怎么建、坑在哪、从零到一怎么落地,都讲了。它最有价值的一句话是:

大多数团队的问题恰恰在于:每个组件内部做得还行,但组件之间的「箭头」没有自动化。

飞轮的瓶颈不在齿,在齿与齿之间的通路。我完全同意——但沿着这句话再往下推一步,会发现一个这篇两万字没有回答的问题:

所有箭头里最上游的那一条——「什么叫好」——它的定义权在谁手里?
An Unsigned Eval Set Is a Flywheel Without an Owner

[Read More]

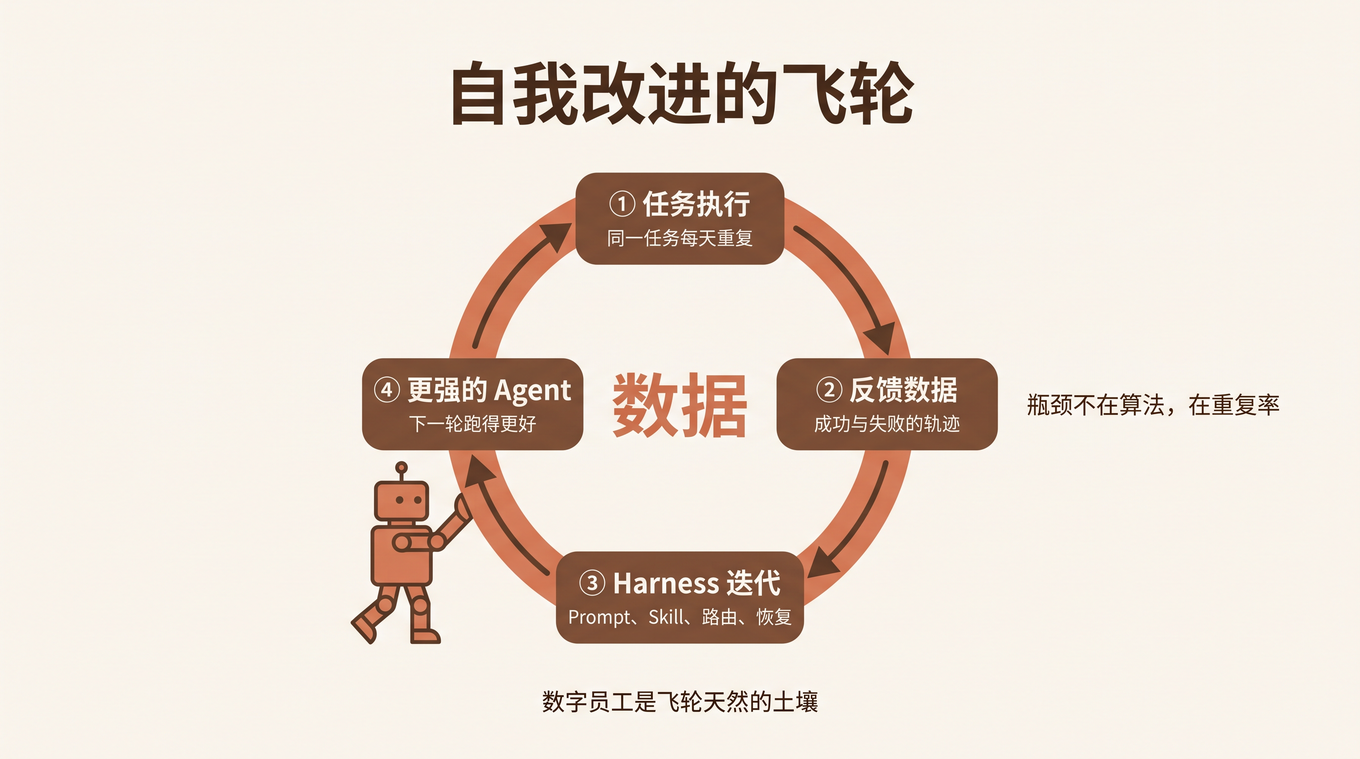
数字员工的自我进化:从 Harness 开始,每天重复干同一件事

Harness RSI Runs on Production Data, Not Algorithms

最近读了一篇关于 Harness 自进化的报道,里面有个细节让我停下来想了很久。

停下来的原因,是我们自己也卡在这里:数字员工上线一段时间了,它好像变「顺手」了,但说不清是不是变「聪明」了。这个模糊感,恰好被报道里的三个数字点破。

报道里那家公司说(厂商自报口径):他们平台上 95% 以上的 Agent 被每天重复运行;在留存用户中,93.4% 的操作是系统自触发的;超过六成的自动化流程持续运行了一个月以上。

大多数人读到这三个数字,看到的是「这家公司用户很多」。我看到的是另一件事:这三个数字加起来,恰好是递归式自我改进(RSI)最稀缺的原料。

Harness RSI Runs on Production Data, Not Algorithms

[Read More]

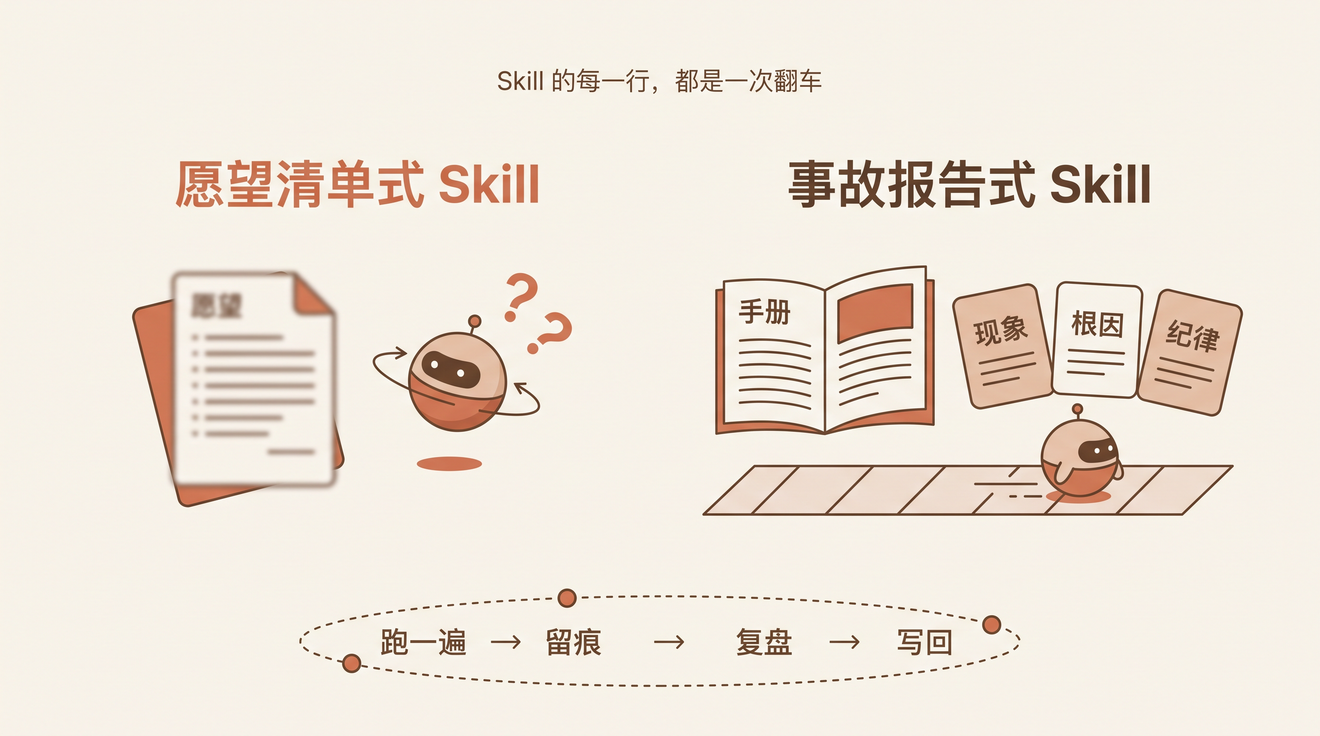
我的公众号排版 Skill,每一行都是一次翻车

Every Line of My Publishing Skill Is a Crash Report

本文全部时间线与数字来自 2026-08-30 一次真实执行记录,可在本机数据库逐条复核。

昨天傍晚六点三十七分,我中断了一个正在跑的任务。

任务叫 wx post 376——一句话,AI 同事全套接管:把博客文章排版成公众号 HTML、钉钉投递、生成朋友圈文案、发到“数字员工协作群”让另一个 agent 转发到 X.com,最后驱动已登录的 Chrome 进公众号后台,把标题、正文、作者、封面、原创声明一项项填进编辑器存草稿。

它跑了四十分钟,干完了八成。然后,在原文链接设置成功后的第十四秒,会话被我中断,留下一份半成品草稿。

今天我对 AI 同事说了一句话:「回顾下处理 376 的整个过程,找出优化空间。」

它做了三件事:从本地数据库里挖出自己的完整执行历史,重建逐分钟时间线;找出六个优化点;当场把 Skill 改写为 v2.2.0。

这篇想写的就是这个过程给我的冲击——一个 Skill 里最值钱的不是流程,是翻车记录;而这份事故报告,可以不用人来写。

Every Line of My Publishing Skill Is a Crash Report

[Read More]

AutoHarness:Warp 的 Agent 自我改进循环

Self-Improving Means Shipping Config, Not Updating Weights

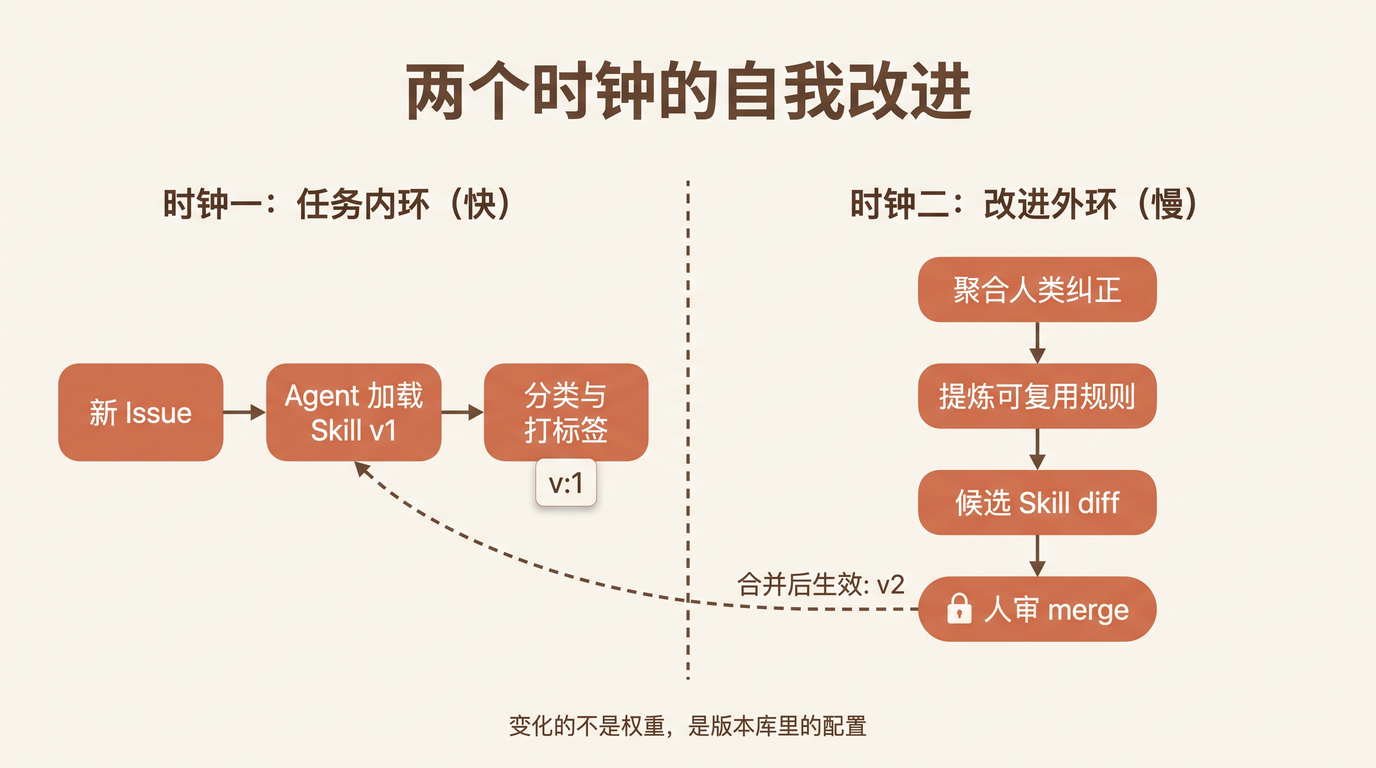
先看一个反直觉的场景。6 月 12 日,Warp 创始人 Zach Lloyd 的 GitHub 账号向开源 demo 仓库 issue-triage-loop 提交了一个 PR #21。PR 的真正作者不是他,而是一个在 Oz 上运行的 Agent。它做的事很克制:回看 issue #16 到 #20 这 5 次 triage 判断,发现其中 4 次被人类维护者纠正,于是把这些纠正压缩成 3 条可复用的规则,diff 只有 8 行新增、6 行删除,最后提出把 triage Skill 从 v1 升到 v2。

一个 Agent,给自己交了一份只有 14 行的「改进申请」,等人批准。这就是 Anthropic 笔下「self-improving agent」的真实形态——它让人联想到模型在线训练、自动改权重,但讲的并不是这些。我把官方文章、Warp 公开 demo、这个 PR 和当前开源实现放在一起看,结论很清楚:持续变化的是版本库里的 Skill 与相关配置。 Claude 负责执行任务、归纳反馈和生成候选修改;Git、评测、权限与人审决定修改能否进入生产。

Self-Improving Means Shipping Config, Not Updating Weights

[Read More]