AI 的账单搬家了:从 token 到轮次

The Bill Has Moved: From Tokens to Turns

Anthropic 昨天发布 Opus 5.5,标题新闻是降价:同样的工作负载,成本比上一代低约 40%。

但这篇发布博客里最值钱的不是降价,是一组没上标题的数据。他们拉了 2026 年 3 月到 9 月 Claude Code 的聚合账单,发现每个请求的 输入与输出 token 之比,从 189:1 涨到了 324:1——六个月内,每个请求的上下文膨胀了 2.6 倍。

翻译一下:你的 AI 账单,早就不是「写」出来的,是「读」出来的。 输出只占 token 总量的千分之三;就算算上输出单价通常是输入的三五倍,砍掉一半输出,账单也就省下不到一个百分点。生成是零头,重读上下文才是大头。

而且账单还在搬。博客里引用开发者 Addy 的一句话,我认为是全文最重要的一句:

减少一个轮次,比一个缓存 token 还要更省成本。

token 之后是缓存,缓存之后是轮次。今天把这条搬家路线讲清楚——因为它直接决定你该在哪里省钱、在哪里花钱。
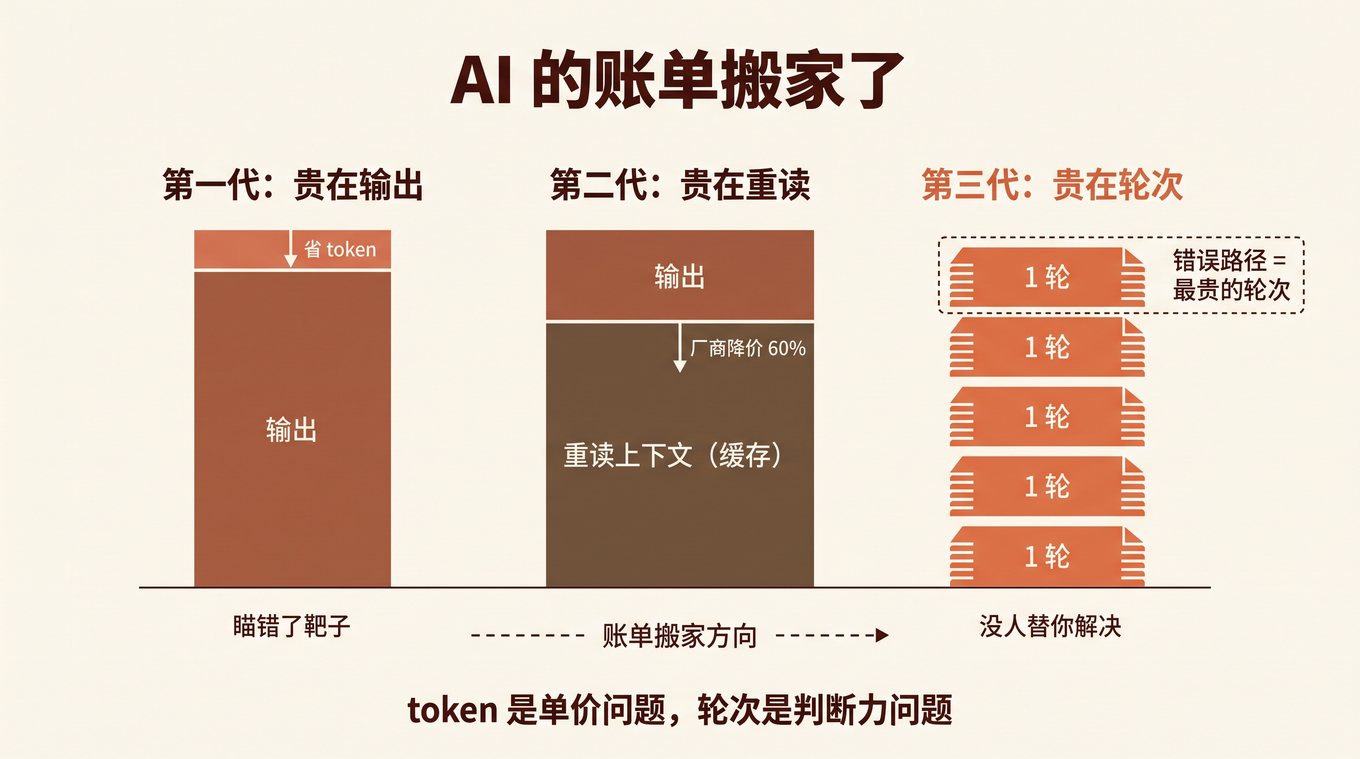
The Bill Has Moved: From Tokens to Turns

[Read More]

悟空技巧十二:Token 经济学,用工程手段优化 AI 协作成本与延迟

Wukong Tip #12: Token Economics and Performance Optimization at Scale

你的团队全面接入悟空(或企业级 AI 平台)三个月后,CTO 把两份报告拍在了你的桌上。

第一份是财务账单:API 调用费用环比增长了 400%,其中 60% 的 Token 消耗在生成「无用的客套话」和「重复的上下文注入」上。 第二份是用户体验报告:核心业务场景的平均首字延迟(TTFT)高达 8 秒,客服团队抱怨 AI 响应太慢,导致客户在等待中流失。

AI 能力很强,但如果成本压不住、延迟降不下,它就无法成为真正的生产基础设施。

在前面的十一篇文章中,我们构建了从 需求澄清、流程控制、多 Agent 编排 到 安全防御 的完整工程体系。

但所有这些技巧,都聚焦在「功能实现」和「质量保障」。当 AI 协作从「试点项目」走向「规模化运营」时,Token 消耗(成本)和推理延迟(性能) 将成为决定项目生死的硬指标。

今天,我们探讨技巧十二,也是本系列的收官之作:如何通过「Token 经济学」,用工程手段优化 AI 协作的成本与延迟,实现质量、速度与 ROI 的最佳平衡。

[Read More]